2026 年 9 月,Fireworks Research 亮出了一张不同寻常的底牌:专用模型 Ember-1。它直接将开源模型 Kimi K3 当作底座,通过二次训练砍掉了超过四成的冗余推理内容。当行业都在堆砌更长上下文时,这个项目把手术刀对准了模型自我产生的思考过程。大模型降本的突破口,已经从压缩参数转移到了消除无用思维链路。
账单开销九成来自机器无效自语
多轮 agentic 工作流的成本账单中,最昂贵的部分恰恰是机器内部一遍遍重放的思考记录。在这种框架下,模型每执行一个新的步骤,就必须把此前所有的推理痕迹重新输入。这导致上下文长度随着轮次近似呈平方级增长。早期轮次的推导被反复阅读并计费,占满了大量的生成管道。
翻开 Kimi K3 的公开 API 定价表,这种机制带来的成本反噬尤为刺眼。未缓存的输入单价是 3 美元每百万 token,缓存后更是降到 0.3 美元。但它的输出定价却高达 15 美元,构成了最高 50 倍的价差。这种剪刀差让模型在输出端生成的每一次冗余思考,都变成了高昂的账单数字。
解决问题的常规思路是换用小模型,但这往往带来复杂场景下的能力退化。Ember-1 选择了另一条路线:把大模型输出中的废话强行挤干。这种转变将优化的矛头直接指向了生成链路本身。降低单价救不了无限制膨胀的 token 数量,直接干预并剔除无效推理才能真正止血。
砍去 71% 推理步骤依然稳拿基准分数
Fireworks AI 披露的内部真实流量 A/B 盲测展示了直观的剥离效果。同一组工作负载下,未修改的 K3 原模型取得 0.751 的评估成绩,平均用掉 23.8 步,输出 49.3K 的 token。换成 Ember-1 后得分微涨至 0.753,步数降至 21.4 步,输出 token 暴跌到 29.9K。推理 token 发生断崖式下降 71.3%,总消耗缩减了 39%。
把战线拉到公开的严苛行业基准上,这套剪枝策略同样保持了稳定。在 SWE-bench Verified 中,Ember-1 的通过率达到 92.2%,紧咬 K3 默认档的 93.2%。由于输出内容减少,单任务平均省下 68.1 美元,token 下降幅度达到 15.5%。能力上限没有折损,模型生成的大量中间步骤纯属多余动作。
在针对长链路的 DeepSWE 1.1 测试里,Ember-1 的表现甚至反超了基座。它的成绩从 K3 的 66.4% 跃升至 75.2%,单任务省下 126.9 美元。而在 τ-2 Bench Airline 测试中,它的得分也从 64% 涨到了 66%,微弱节省了 0.3 美元。
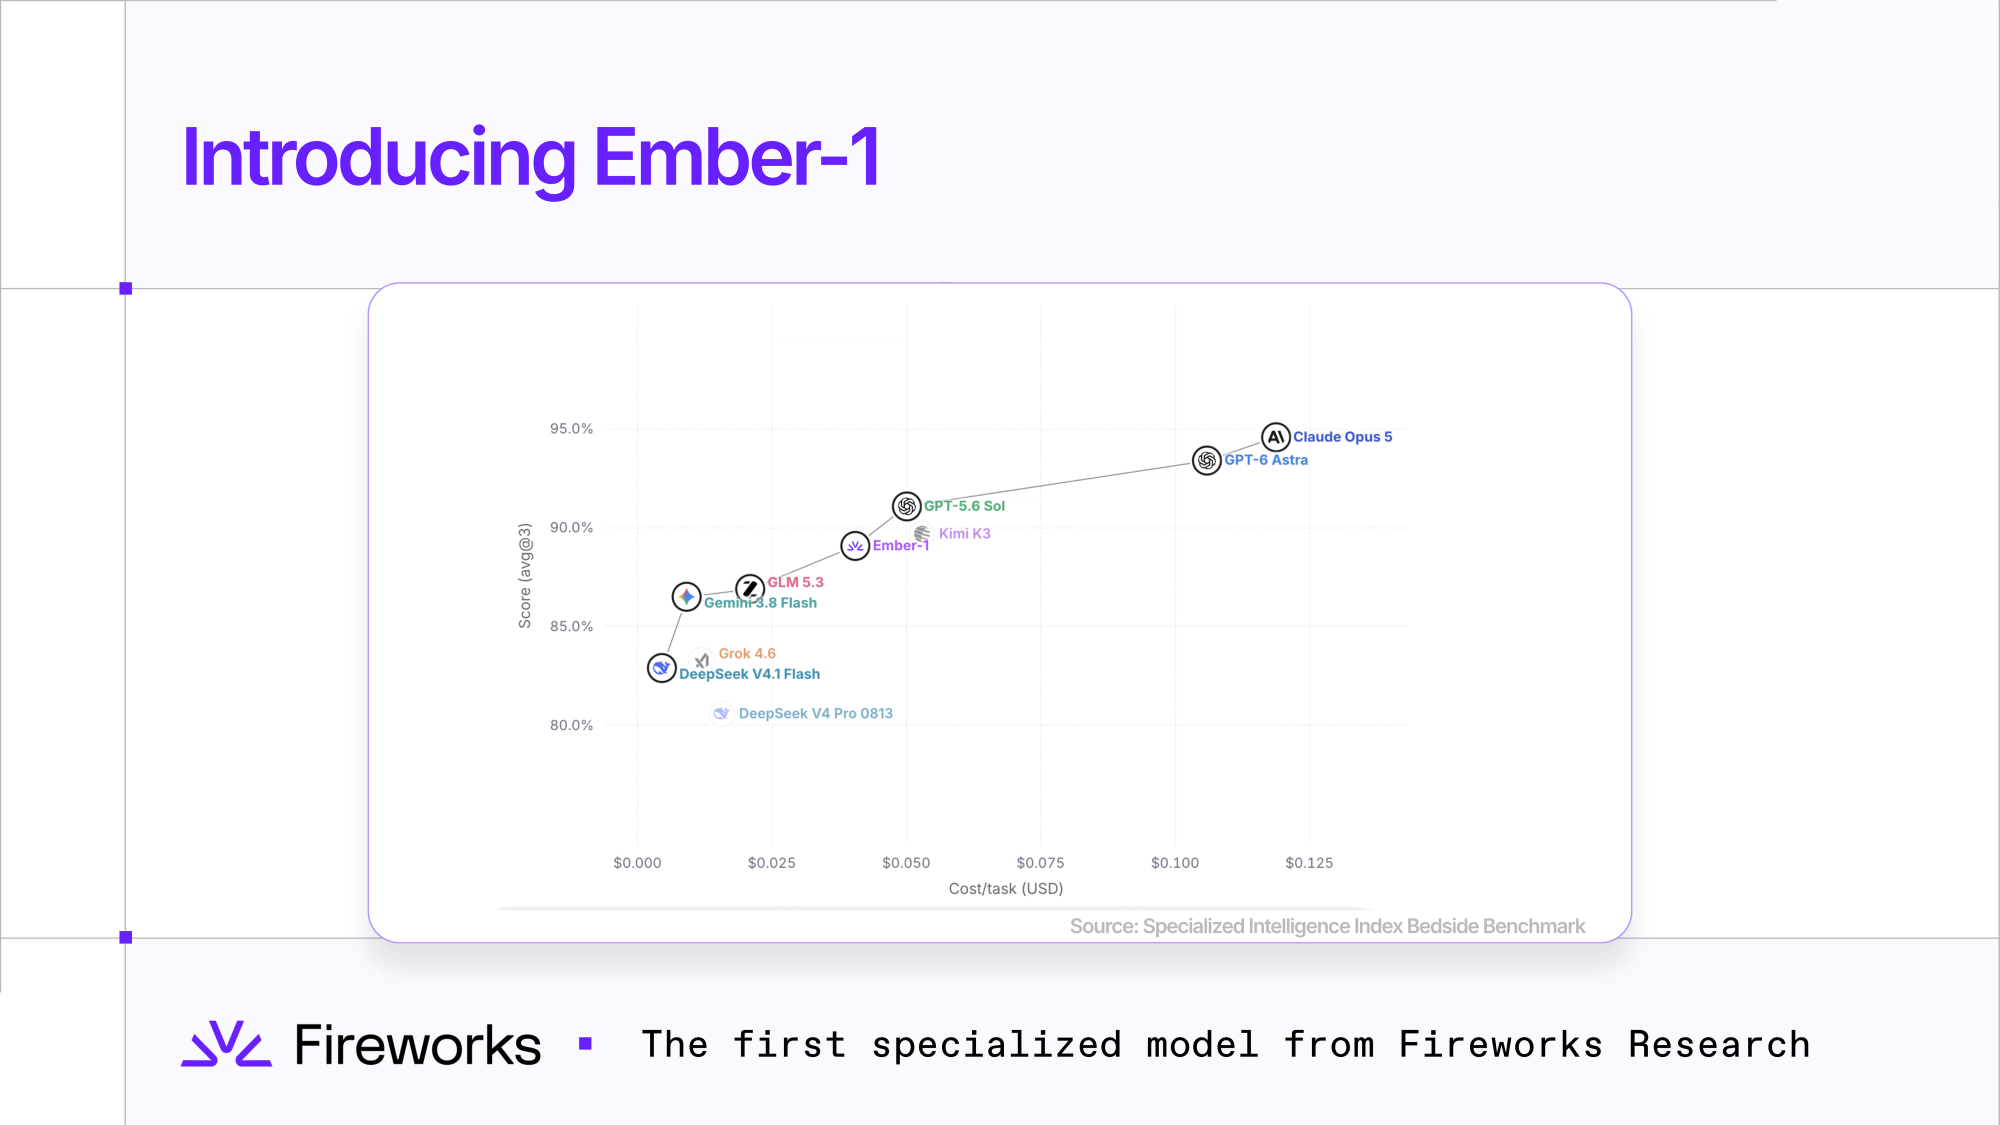 图:Ember-1 相对 Kimi K3 的 token 消耗下降。来源:Fireworks AI 官方博客
冗长的分析过程并不等于高质量的推理,反而容易引入噪声幻觉。通过定向训练让模型学会简明扼要地给出推导,最终决策的正确率反而更高。这些数据推翻了只要思考时间够长结果就一定更好的经验直觉。
将中国开源底座当作毛坯房重新装修
Ember-1 项目背后没有堆砌巨量的算力资源,也没有漫长的新模型开发周期。开发团队仅仅围绕 Fireworks 自有数据,跑了 50 多次训练实验和 200 余次评估迭代。整个流程跑在自有的 Serverless Training 平台上,并未专门搭建任何独立的 GPU 集群。这种轻量级的开发模式,揭示了推理厂商对待开源基座的全新打法。
过去海外的推理平台主要扮演计算通道角色,负责把各个开源模型原封不动地搬上服务器。他们通过底层的算子优化来压榨硬件吞吐量,比拼并发量与首字延迟。在这个时期,中国开源模型是货架上的一个现成通道商品。
如今 Ember-1 的出现撕开了这个买办模式的缺口。平台开始把 K3 当作一个能力足够强但带有计算冗余的底层地基,利用业务数据重新做应用层的构建。这套动作将原本的算力分发模式,升级为基于开源模型二次专精的高附加值服务。
厂商不仅自己兜售精简版模型,还同步开放了微调训练支持。企业客户可以利用自有数据,在这套已经清洗掉冗余的框架上做更深度的专精。这种做法把底座模型变成了加工流水线上的一个原材料环节,不再将其视作不可动摇的黑盒。
帕累托前沿易主与社区的套壳质疑
在医疗等垂直领域的专业评估中,Ember-1 的轻量化优势带来了直观的财务回报。根据 Doximity 提供的 Bedside Bench 数据,这个涵盖 500 个临床病例、10 个专科类别并由执业医师验证的题库坐标系被改写。Ember-1 在单任务成本与完成度两个关键维度上,划出了一条全新的帕累托前沿。
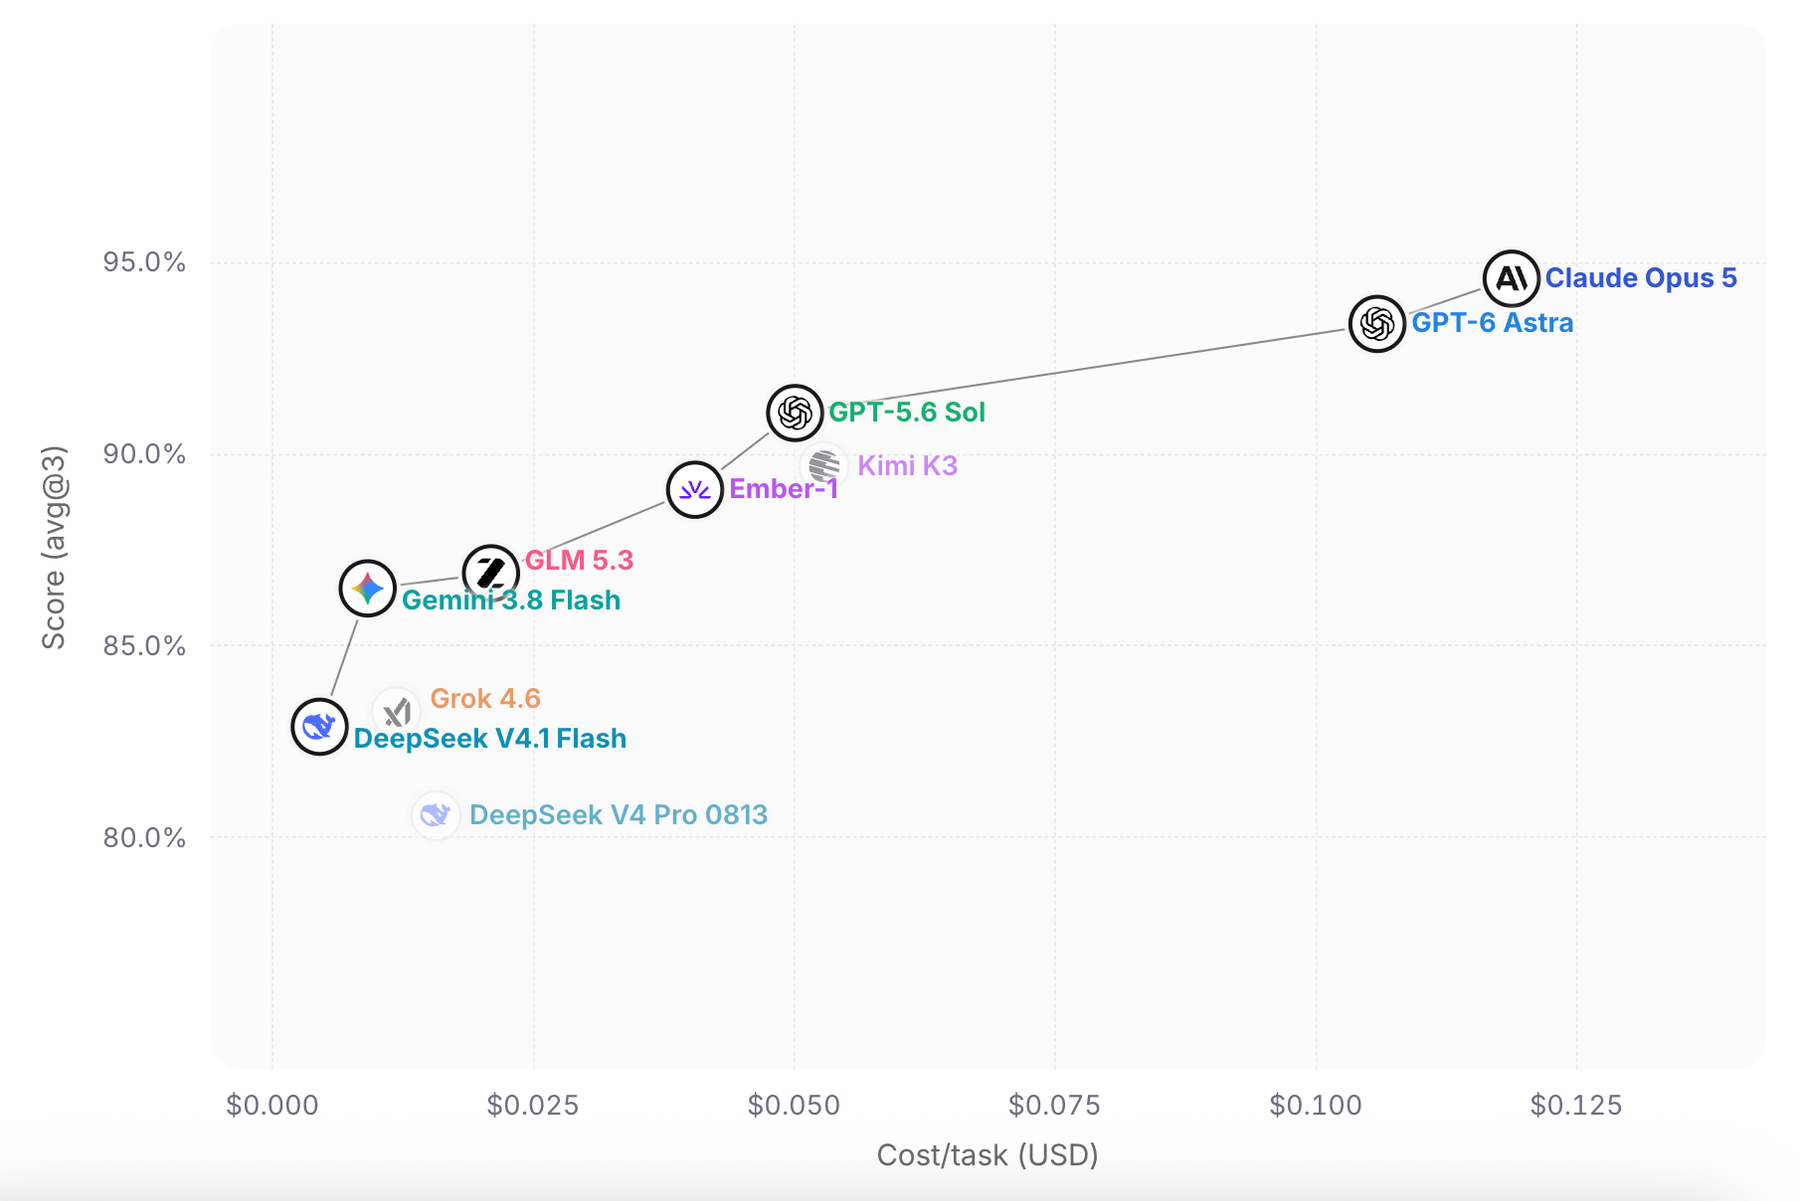 图:Bedside Bench 上的 cost/task 帕累托前沿。来源:Fireworks AI 官方博客
面对 OpenAI 的 GPT-5.6 Sol 等第一梯队闭源巨头,这套基于 K3 魔改出来的系统在性价比指标上形成了强力压制。
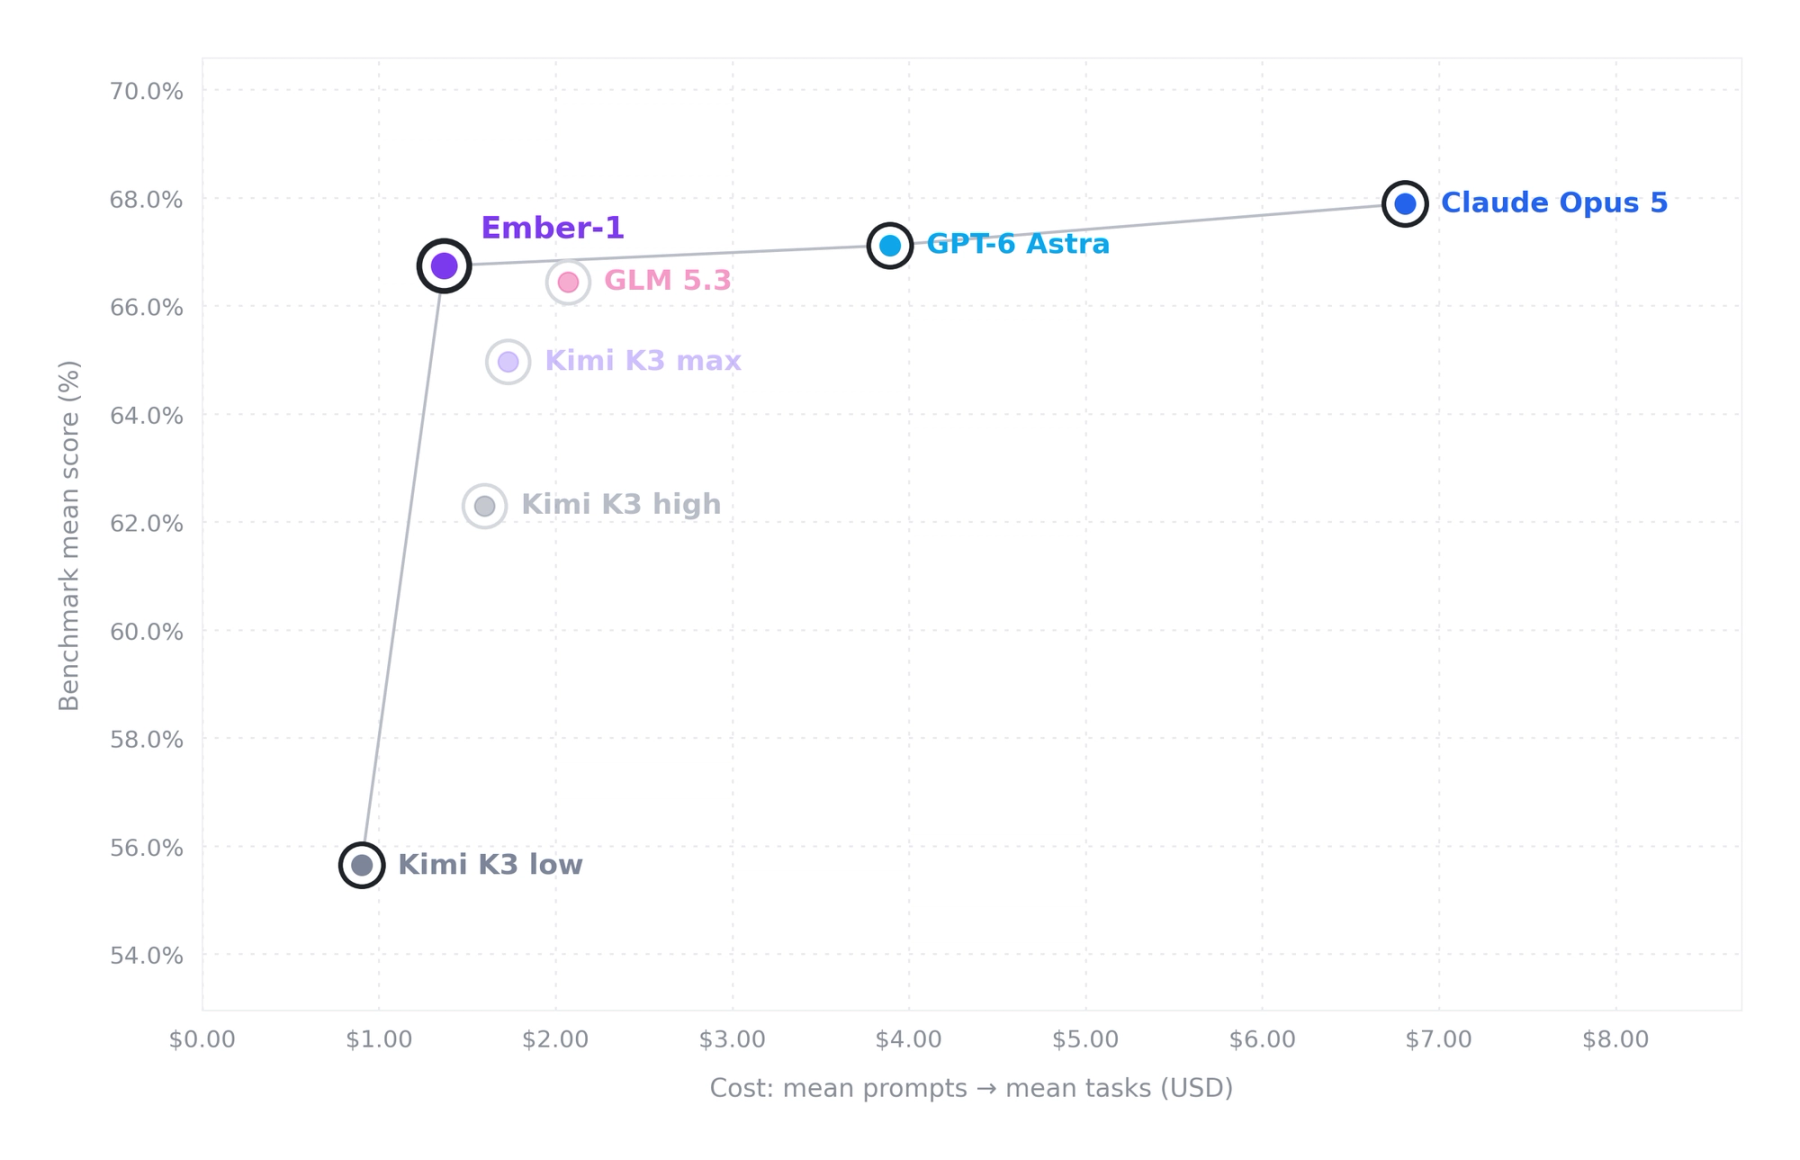 图:5 项行业基准的成本与任务均值对比。来源:Fireworks AI 官方博客
面对这种取巧的做法,技术社区表现出了强烈的两极分化情绪。部分工程师指出,把长链路的推理轨迹压缩进更短的输出里,并未脱离传统的模型蒸馏路径。反对声音认为,这套方案是把别人训出的开源模型做了一次成本裁剪,换上自己的名号二次销售,不属于底层智能的跨越。
针对这种质疑,工程侧交出的答卷同样现实且直接。用模型做二次裁剪谈不上涌现出新智能,但在复杂生产环境里单任务能省下成百上千美元,这种优化本身构成了坚实的商业壁垒。企业并不关心模型是否使用了最前沿的基础架构,他们只关心实际任务的完成度以及每个月需要支付的账单总额。
留下关键反思机制重塑系统防线
Ember-1 在执行流程删减时,并没有采用一刀切的暴力思维截断。Kimi K3 推理过程中具备高价值的自我反思机制,被研究团队刻意保留并加以利用。模型依然能够回看早期的失败假设,响应负面反馈,并将结论追溯到最初的某一步决策。被系统清洗掉的内容,仅限于那些陷入死循环的无逻辑复读。
在特定企业的两家生产编码工作负载中,这场缩水手术展现了稳定的实战收益。在保持任务完成率和失败率均未出现波动的安全前提下,每个任务大约能省下 35% 的 token 消耗。其中一家客户甚至已经将其部署到了线上生产环境,计划全面替换原有的基座模型,以应对日益膨胀的调用成本。
不过这项技术的泛化边界和稳定性区间依然缺乏足够的公开验证。目前 35% 到 50% 的压缩区间,主要是在特定的代码和常规推理数据分布上测算得出的。如果把应用场景切换到需要长链条严格推导的数学证明任务,这种强行压缩是否会导致关键步骤丢失,仍需要系统性的论证数据。
无论技术路线存在多少争议,大模型的降本之战已经跳出了单纯比拼卡池规模的阶段。精准剥离无效计算,正在成为推理厂商构筑系统防线的核心手段。只要模型仍然按 token 长度计费,任何消除推理废话的技术都会立刻兑现为现实利润。下一次能力竞争的焦点不再是谁生成的步骤更长,而是谁能用最精简的字数把复杂问题想透。
参考链接:
- Fireworks AI 官方博客
- Hacker News 社区讨论