用英语让大模型写一篇短文,耗电通常只有零点几焦耳。换成中文,耗电量直接翻倍。若是换成印地语或孟加拉语,耗电量会飙升数倍乃至十几倍。
在部分长程测试场景下,非英语文本的能耗差距拉大到了 180 倍。这项测算来自密歇根大学工程学院。成果已提交至自然语言处理学术会议 EMNLP。
论文第一作者是博士生邓乃豪(Naihao Deng)。通讯作者为拉达·米哈尔切亚(Rada Mihalcea)教授。他们搭建了名为 ML.Energy 的监测框架。测试跑在 Great Lakes 高性能计算集群上,全面评估了主流开源模型。
测试对象包含阿里巴巴的千问 3(Qwen 3)、谷歌的 Gemma 3 以及 Meta 的 Llama 3.1。数据集选取了覆盖 122 种语言的 Belebele 阅读理解题库、小学数学应用题与开放式提问。原本单语言的数据集,则使用 Meta 的 NLLB 工具转译为 7 种语言对照。
问同样一句话,非英语文本耗电飙升到180倍
实测数据展现出清晰的语言阶梯。大多数西欧语言的生成能耗在英语的 2 倍以内。印地语的耗电量达到英语的 7.9 倍,孟加拉语则飙升至 15.3 倍。
公开报道中普遍引用的数字是中位数附近的 15 倍。在复杂生成任务里,峰值能耗差距触及了 180 倍上限。日常测试中多数语言每 token 耗能 0.1 焦耳,少数复杂语言却飙升至 4.8 焦耳。
在现有开源架构下,语言本身的文字形态直接左右了算力开销。 西班牙语和中文的母语人口都超过英语。但在大模型生成这两种文字时,耗电量依旧接近英语的两倍。
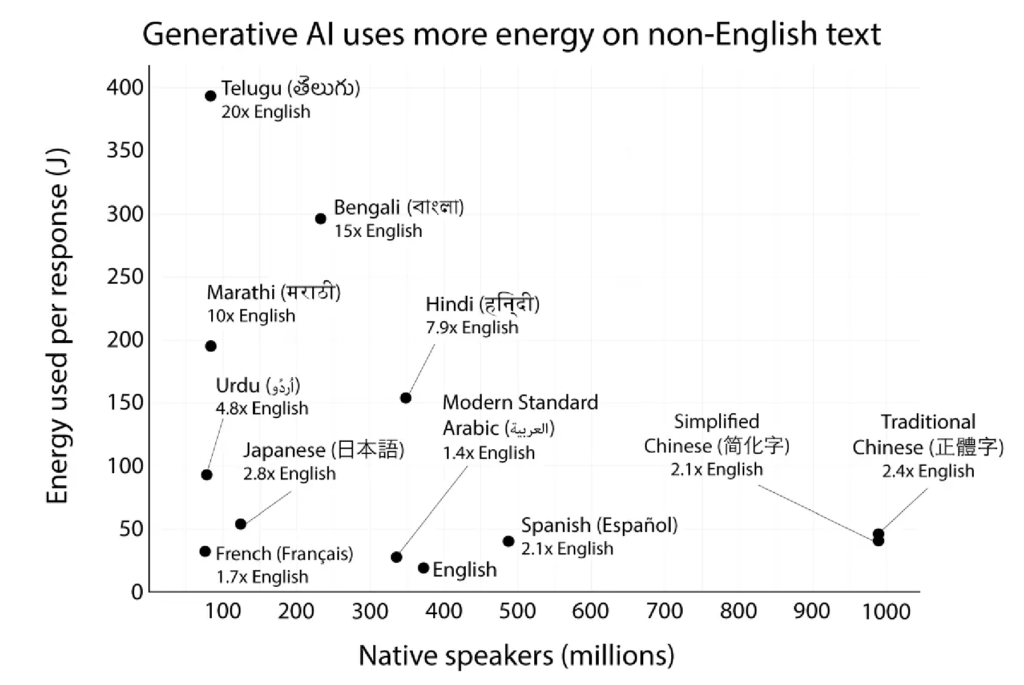 图:各语言生成能耗与英语的对比,西欧语言接近英语,天城文与孟加拉文能耗陡增。来源:Scott Hyde / University of Michigan Engineering
字符被拆得太碎,显存塞满直接拖慢运算
普通人与大模型交流时输入的是字词。在芯片底层,所有句子都必须先拆成数字编号,也就是 token。负责拆解句子的程序叫分词器,它的角色就像切分文字积木的尺子。
大模型的分词字典主要基于海量英语文本构建。常用英文单词或词根,往往只占一块积木。遇到非英语语种,分词过程立刻变得稀碎。
印地语、尼泊尔语使用的天城文,以及孟加拉文,结构格外复杂。这些文字包含大量元音附标、连字变形与复合辅音。分词器在词表里找不到整块积木,只能按字节强行切分成四到六倍的碎块。
切词过碎会直接塞满显卡的高速显存。 服务器被迫压缩并行计算的批次大小,硬件吞吐量大幅下滑。当显卡无法批量处理任务,每块文字积木平摊的电耗便会二次上升。
这套能耗传导链源于切词算法与硬件显存的连锁制约。从小参数模型到数百亿参数大模型,测试规律高度一致。无论更换何种芯片,英语在基准测试中始终是耗电最少的一档。
账单按字块结算,多花钱反倒换来更差回答
数据中心的电表转速,直接折算成了商业账单。主流云计算平台和大模型厂商,普遍按照处理的 token 数量计费。表达同样的意思,南亚语言要消耗多出数倍的 token,用户就要多掏数倍的调用费。
结合全球语言数据库 Ethnologue 的统计,研究算出了一个沉重的人口数字。全球约有 5.2 亿人坚持使用母语与 AI 对话,消耗的电能与金钱是英语使用者的两倍以上。母语选择在现实中变成了一笔昂贵的隐形支出。
多花钱往往换不来对等的服务质量。在 Belebele 阅读理解与数学应用题测试中,能耗越高的低资源语种,答题准确率反而垫底。模型在这些语言上的训练语料匮乏,芯片飞速空转,却频繁给出离题的错误答案。
这项研究获得了美国国家科学基金会(NSF)与 DARPA 的资助。福特汽车、劳德研究所与 OpenAI 同样提供了支持。大模型的计费规则与分词机制发生耦合,把语言差异固化成了数字成本壁垒。
 图:论文通讯作者 Rada Mihalcea 教授与第一作者邓乃豪在实验室。来源:Brenda Ahearn / University of Michigan Engineering
能耗悬殊背后,冷门语种卡死在复读循环
测试数据公布后,在技术社区 Hacker News 上引发了技术讨论。有开发者翻阅论文第 6 页的实验记录,指出了异常能耗的另一层原因。部分任务飙出 180 倍能耗,核心在于小语种任务里的生成崩溃。
面对训练不足的冷门语种,模型经常找不准停止生成的特殊标记。一旦失去退出条件,模型就会陷入死循环。它在胡言乱语与机械复读中耗尽最大长度,导致显卡长时间满负荷空转。
异常能耗叠加了两重损耗:既有文字切词过碎的先天低效,也有模型推理失控造成的电力浪费。社区讨论中也有工程师对对比基准提出了不同看法。将能耗与母语人口挂钩,无形中放大了英语的优势。
全球数以亿计的非母语使用者,同样在持续产出英文文档与代码。英语语料在绝对体量与质量上的优势,短期内难以撼动。这也是各类大模型在英语环境下表现最稳定、运行最节能的现实基础。
抹平母语使用差距,算法与翻译哪条路走得通
面对母语带来的能耗与成本鸿沟,密歇根大学的研究团队给出了务实的工程化思路。最直接的路线是优化分词字典。或者建立路由机制,将非英语请求智能分发给专用的小型专家模型。
另一条看似迂回但成效显著的策略是先翻译后推理。用户输入母语后,系统先调用轻量翻译工具转成英文。大模型用英文处理完毕,再把答案翻译回母语。
实测表明,这一套组合流程反而更省电。它的综合能耗明显低于母语直出,回答准确率也更为稳定。长期的根本出路,依然在于扩充低资源语种的高质量训练数据集。
大模型按字块计费的商业规则,把不同文字的排版特征变成了现实的算力与金钱差距。全球 5.2 亿人使用母语的权利,不应当被分词算法的先天偏见悄然加价。消除技术普惠背后的语言代价,关乎算法公平,也是绿色算力必须跨过的一道工程门槛。
参考链接:
- 密歇根大学工程学院研究简报 (Michigan Engineering News)
- EMNLP 会议论文:大模型多语言能耗效率评估
- Hacker News 技术讨论帖 (item?id=50441444)