350 000 disques affichent un taux de panne de 1,73 %
Fin septembre 2026, Backblaze a dévoilé son rapport Drive Stats pour le deuxième trimestre 2026, et un indicateur clé a immédiatement attiré l’attention : le taux de panne annualisé (AFR) trimestriel est grimpé à 1,73 %. Il ne s’agit pas d’une simple variation statistique, mais du niveau le plus élevé enregistré depuis une longue période. Au cours du trimestre, les 354 415 disques durs retenus dans l’analyse ont cumulé 31 553 350 jours-disque (Drive Days) et essuyé 1 498 défaillances avérées. Dans l’exploitation quotidienne d’un centre de données, chaque jour-disque accumulé représente un coût d’infrastructure, et chaque panne soumet les mécanismes de redondance à une épreuve en conditions réelles. Un parc de plus de 350 000 unités balaie les discours marketing pour exposer la trajectoire d’usure brute du matériel en production. À mesure que ce pourcentage progresse, les interventions nocturnes de remplacement dans les travées de serveurs deviennent inévitablement plus régulières.
Face à la hausse des défaillances, beaucoup ont le réflexe d’incriminer le contrôle qualité des constructeurs. Pourtant, plus de treize années de suivi continu révèlent une réalité bien différente : sur les 31 modèles suivis ce trimestre, 10 ont franchi la barre des 3,0 % d’AFR. Ces disques parvenus au crépuscule de leur cycle de vie ont tiré la moyenne globale de la flotte vers le haut.
Ce taux élevé découle avant tout du vieillissement mécanique du parc dans les infrastructures cloud. Deux modèles historiques de HGST, d’une capacité de 4 To et 8 To et cumulant respectivement près de neuf et huit années de service continu, ont été officiellement retirés du service ce trimestre. Parallèlement, pour le deuxième trimestre consécutif, aucun modèle inédit n’a intégré le parc, augmentant de façon irréversible l’âge moyen du cluster de stockage. Le fait que les unités vieillissantes gonflent les statistiques juste avant leur mise au rebut rappelle que le disque dur reste un consommable dont l’usure s’accélère avec les années.
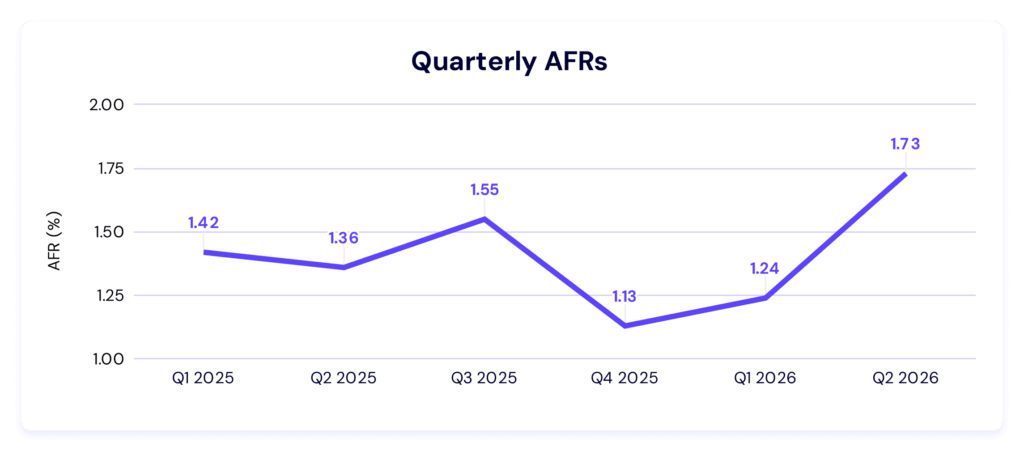 Figure : Nette remontée récente du taux de panne annualisé trimestriel. Source : Backblaze Drive Stats
Un écart décuplé au sein d’un même format
Sur le marché grand public, le choix d’un disque dur se résume souvent à la capacité et au format physique. Sous le microscope du stockage cloud à grande échelle, ces caractéristiques de façade ne suffisent plus. Sur le créneau des 16 To, par exemple, le Seagate ST16000NM001G a maintenu un AFR trimestriel remarquable de 0,65 %, tandis que le Toshiba MG08ACA16TA s’est établi à 1,01 %. Ces deux références majeures, comptant chacune plus de 30 000 disques en production, constituent un socle d’une grande stabilité.
Pourtant, au sein de ce même format 3,5 pouces, le HGST HUH721212ALN604 de 12 To a vu son taux de panne trimestriel s’envoler à 7,63 %. Entre disques d’une même génération et de capacités comparables, l’écart de fiabilité est ainsi multiplié par plus de dix. Acheter des disques durs, c’est adopter un lot de fabrication précis et les procédés d’usine qui lui sont associés.
L’analyse par quartiles a mis en évidence trois valeurs aberrantes particulièrement marquées (avec un AFR supérieur à 6,95 %) : outre le modèle HGST à 7,63 %, le Seagate ST10000NM0086 (10 To) a atteint 9,33 % et le Seagate ST14000NM0138 (14 To) s’est élevé à 8,26 %. Ces deux derniers modèles ne comptaient respectivement que 965 et 1 235 unités déployées, une goutte d’eau à l’échelle des 350 000 disques du parc. S’ils affichent des taux proches de 10 %, c’est parce que leur âge avancé s’est conjugué à un dénominateur statistique restreint : une poignée de pannes suffit alors à doubler le pourcentage calculé.
Le piège statistique des classements sans panne
À première vue, Seagate a réalisé un trimestre éclatant en s’adjugeant l’intégralité du palmarès des modèles sans aucune panne. Les disques ST8000NM000A, ST12000NM000J et ST14000NM000J n’ont enregistré aucune défaillance en trois mois, et la version 16 To de la même série n’a connu qu’une seule panne. Au milieu de modèles dépassant couramment les 3 % de panne, ces références paraissent d’une fiabilité absolue.
Mais cette vitrine masque un piège statistique élémentaire. Aucun de ces modèles n’atteignait le seuil minimal de 500 disques et 100 000 jours-disque cumulés requis pour figurer dans le tableau de fiabilité sur l’ensemble du cycle de vie. L’un de ces disques ne comptait d’ailleurs que 171 exemplaires en service. Quand la taille de l’échantillon est réduite à quelques centaines d’unités sur trois mois, ne déplorer aucune défaillance relève d’une simple attente probabiliste et non d’une invulnérabilité mécanique.
La mesure de la fiabilité exige un recul temporel suffisant et une assise statistique massive. Revendiquer un taux de zéro panne sans cumuler des dizaines de millions de jours-disque revient à se proclamer maître du jeu après avoir gagné un seul tour de roulette. Les petits échantillons créent de faux miracles statistiques, raison pour laquelle Backblaze impose des critères d’éligibilité rigoureux sur ses bilans historiques. Assimiler les résultats à court terme de quelques centaines d’unités à la robustesse éprouvée de dizaines de milliers de disques relève de l’illusion.
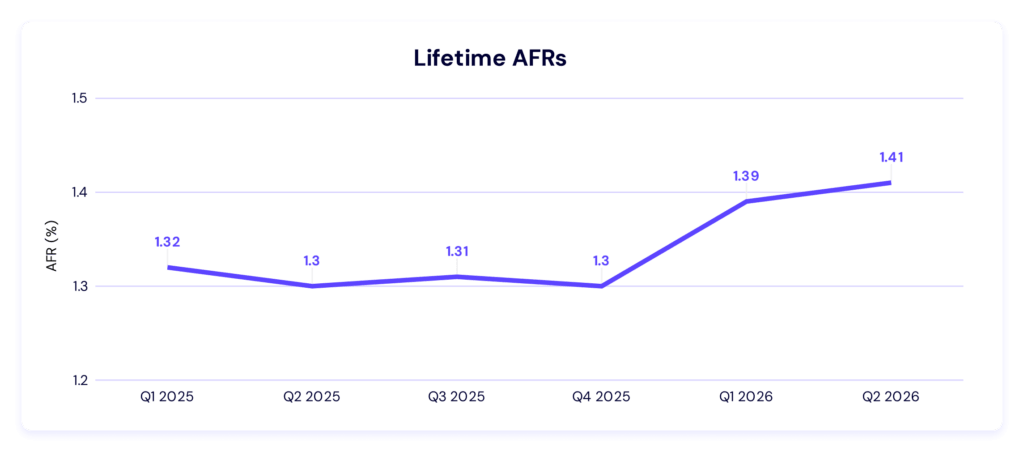 Figure : Performance réelle des différents modèles sur la durée. Source : Backblaze Drive Stats
La course à la capacité reporte la complexité sur le logiciel
Pendant que les disques anciens s’usent, l’expansion des centres de données se poursuit sans relâche. Les unités de 20 To et plus représentent désormais plus de 25 % du parc analysé ce trimestre, les nouveaux déploiements se concentrant massivement vers les capacités les plus élevées. Western Digital a dévoilé cette année un disque UltraSMR de 40 To et fixé une feuille de route prévoyant d’atteindre les 100 To d’ici 2029. Cette hausse spectaculaire de la densité de stockage redéfinit en profondeur les infrastructures physiques.
Dans ce bond capacitif, la technologie d’enregistrement magnétique à bardeaux (SMR) joue un rôle de premier plan. Avec l’enregistrement conventionnel (CMR), les pistes sont juxtaposées parallèlement avec un intervalle de garde. La technologie SMR superpose au contraire les pistes à la manière des bardeaux ou des tuiles d’un toit. La tête d’écriture étant physiquement plus large que la tête de lecture, ce chevauchement partiel permet à la tête de lecture de lire les données sans altération, libérant ainsi 10 % à 25 % d’espace supplémentaire par plateau.
Cette configuration architecturale a des répercussions directes sur les couches applicatives. Le SMR s’avère particulièrement exigeant quant au profil de charge : les écritures séquentielles et les ajouts en fin de fichier s’exécutent sans encombre, mais des réécritures aléatoires fréquentes déclenchent de lourdes opérations de réorganisation de zones et de ramasse-miettes. Qu’il s’agisse de SMR géré par le disque (Drive-managed), conscient de l’hôte (Host-aware) ou directement piloté par l’hôte (Host-managed), le système d’exploitation et la pile logicielle doivent être adaptés. Le gain de place dans les baies de serveurs se paie ainsi par un report de la complexité matérielle vers la couche logicielle.
Des plateaux en verre pour franchir le cap des 100 To
L’optimisation de la densité surfacique approche désormais des limites physiques absolues. L’enregistrement magnétique assisté par la chaleur (HAMR) utilise une impulsion laser microscopique pour chauffer brièvement la surface lors de l’écriture, permettant aux têtes d’enregistrer sur des grains magnétiques plus petits et thermiquement stables. Dans la mesure où HAMR et SMR répondent à des contraintes physiques différentes, les constructeurs prévoient de combiner ces deux technologies sur un même disque pour atteindre le palier des 100 To.
Pour résister aux contraintes thermiques et aux tolérances mécaniques extrêmes, les traditionnels plateaux en alliage d’aluminium sont progressivement abandonnés. Les substrats en verre sont déjà devenus le standard sur les disques HAMR de 2,5 pouces et se généralisent dans les formats 3,5 pouces à très haute densité. Changer le support matériel de base constitue une refonte technique majeure, attestant que l’aluminium a atteint ses limites physiques. La compétition au sein des centres de données s’est désormais déplacée vers la science des matériaux : à mesure que la capacité unitaire s’envole, chaque gain de densité exige une gestion thermique plus fine et une stabilisation mécanique renforcée.
À ce jour, le parc de 350 000 disques de Backblaze ne compte aucun disque SMR. L’entreprise a cependant indiqué que dès l’intégration de ces technologies émergentes, elle les identifiera distinctement pour en analyser publiquement les taux de panne. Quel que soit le nombre de plateaux en verre scellés dans chaque boîtier, l’impératif reste identique pour les opérateurs cloud : maintenir une fiabilité prévisible tout au long du vieillissement des équipements. À l’ère des disques en verre de 100 To, la préservation des données ne reposera plus uniquement sur la robustesse mécanique d’un composant individuel, mais sur l’aptitude des logiciels d’orchestration à absorber les défaillances physiques sous-jacentes.
Liens de référence :
- Rapport Backblaze Drive Stats