350.000 discos registran una tasa de fallos del 1,73%
A finales de septiembre de 2026, Backblaze publicó su informe de fiabilidad de discos duros para el segundo trimestre de 2026, y una métrica clave encendió de inmediato las alarmas: la tasa anualizada de fallos (AFR) trimestral subió hasta el 1,73%. No se trata de una oscilación menor, sino de la cifra más alta registrada en bastante tiempo. Durante el trimestre, los 354.415 discos duros analizados acumularon 31.553.350 días de funcionamiento (Drive Days) y experimentaron 1.498 averías reales. En la operativa de un centro de datos, cada día de disco acumulado supone un coste directo, y cada fallo somete a prueba los mecanismos de redundancia en condiciones de fuego real. Una base de más de 350.000 unidades neutraliza cualquier artificio publicitario para revelar la curva de desgaste real del hardware. A medida que este porcentaje sube, las rondas nocturnas de sustitución de discos en las salas de servidores se vuelven inevitablemente más habituales.
Muchos observadores tienden a atribuir el incremento de fallos a problemas de control de calidad en fábrica. Sin embargo, los registros recopilados a lo largo de más de 13 años reflejan otra realidad: de los 31 modelos evaluados este trimestre, 10 superaron la barrera del 3,0% de AFR. Este grupo de dispositivos, situados en la recta final de su ciclo de vida, elevó de forma determinante el promedio general de la flota.
Una tasa de averías elevada es, ante todo, el reflejo directo del envejecimiento de la flota en un centro de datos en la nube. Dos modelos veteranos de HGST, de 4 TB y 8 TB, que prestaron servicio durante casi nueve y ocho años respectivamente, fueron retirados formalmente este trimestre. Al mismo tiempo, por segundo trimestre consecutivo no se incorporó ningún modelo nuevo al inventario, lo que elevó de manera irreversible la edad media de todo el clúster de almacenamiento. El hecho de que las unidades más antiguas disparen las estadísticas justo antes de su desmantelamiento confirma que el disco duro es un bien fungible cuyo desgaste se acelera con el paso de los años.
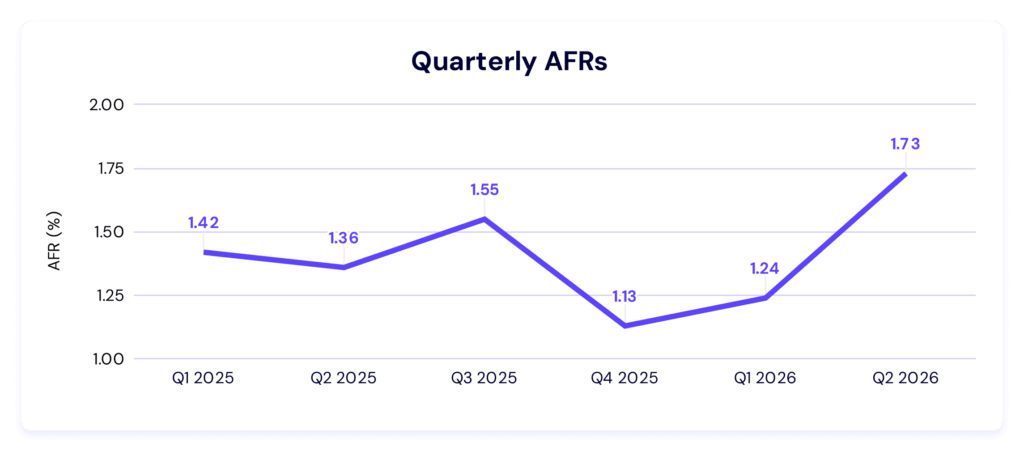 Gráfico: Marcado repunte reciente en la tasa anualizada de fallos trimestral. Fuente: Backblaze Drive Stats
Una brecha de diez veces dentro del mismo formato
En el mercado de consumo, la compra de un disco duro suele reducirse a la capacidad y al formato físico. Sin embargo, bajo la lupa del almacenamiento a hiperescala, esas especificaciones superficiales se desmoronan con rapidez. En el segmento de los 16 TB, por ejemplo, el modelo Seagate ST16000NM001G registró un AFR trimestral del 0,65%, mientras que el Toshiba MG08ACA16TA se situó en el 1,01%. Ambos modelos de referencia, con más de 30.000 unidades en funcionamiento cada uno, mantuvieron una base operativa extraordinariamente estable.
En cambio, dentro de ese mismo formato estándar de 3,5 pulgadas, el HGST HUH721212ALN604 de 12 TB alcanzó un alarmante 7,63% de AFR trimestral. En modelos de la misma época y con capacidades comparables, la disparidad de comportamiento superó el factor de diez. Comprar discos duros implica adquirir un lote concreto y asumir los procesos de manufactura que respaldan esa partida en los racks.
El análisis de cuartiles identificó tres anomalías estadísticas especialmente pronunciadas (con un AFR superior al 6,95%): además del 7,63% citado, el Seagate ST10000NM0086 (10 TB) trepó al 9,33%, y el Seagate ST14000NM0138 (14 TB) marcó un 8,26%. Estos dos últimos modelos apenas sumaban 965 y 1.235 unidades en producción, una cifra casi insignificante dentro del conjunto de 350.000 discos. Si alcanzaron tasas de fallo cercanas al diez por ciento fue por la reacción combinada entre su veteranía física y un denominador reducido: bastan unas pocas averías para duplicar el porcentaje resultante.
La trampa estadística de las listas con cero fallos
A primera vista, Seagate firmó un trimestre impecable al monopolizar la lista de modelos con cero averías. Las unidades ST8000NM000A, ST12000NM000J y ST14000NM000J no registraron ningún fallo durante los tres meses del trimestre, mientras que la variante de 16 TB de la misma gama sufrió tan solo una avería. En un entorno donde numerosos discos superaban el 3% de AFR, estos modelos parecían milagrosamente fiables.
Sin embargo, detrás de esa marca se esconde una clásica trampa estadística. Ninguno de estos modelos cumplía el umbral de 500 unidades y 100.000 días de funcionamiento acumulados exigido para figurar en la tabla histórica de ciclo de vida. Uno de ellos, de hecho, contaba con una muestra de apenas 171 discos. Cuando el volumen analizado se reduce a unos pocos cientos de unidades a lo largo de un solo trimestre, no registrar averías es una probabilidad estadística perfectamente previsible y no una demostración de robustez sobrehumana.
El cálculo fiable de la fiabilidad exige una escala temporal prolongada y una base de datos masiva. Presumir de cero fallos sin contar con decenas de millones de días de servicio equivale a proclamarse maestro del azar tras ganar una sola tirada en la ruleta. Las muestras pequeñas generan con facilidad espejismos estadísticos, razón por la cual Backblaze aplica criterios de volumen tan estrictos en sus tablas acumuladas. Equiparar el rendimiento puntual de unos cientos de unidades con la fiabilidad probada de decenas de miles es un ejercicio de autoengaño.
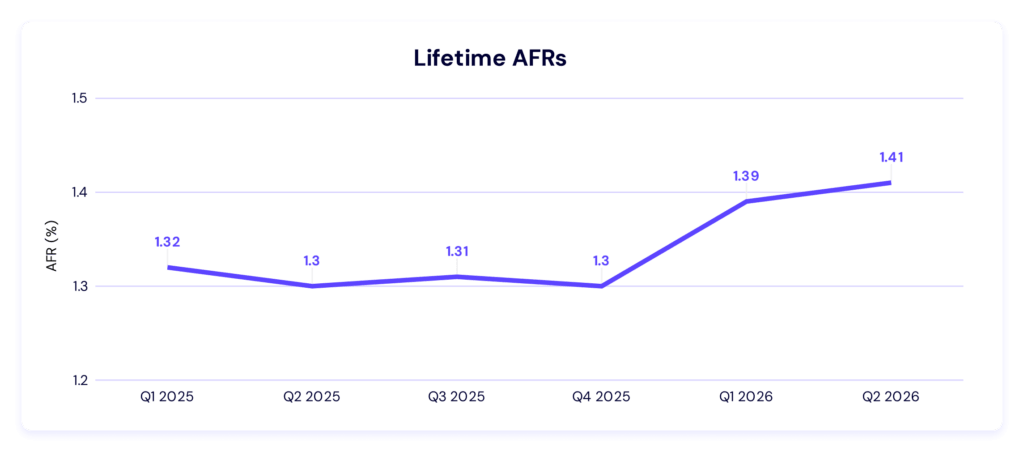 Gráfico: Rendimiento real de cada modelo observado a largo plazo. Fuente: Backblaze Drive Stats
El aumento de densidad traslada la complejidad al software
Mientras los discos veteranos envejecen, la ampliación de los centros de datos no se detiene. Las unidades de 20 TB o más superan ya el 25% del parque analizado en este trimestre, y las nuevas implementaciones se concentran de manera continua en las densidades más altas. Western Digital anunció recientemente un disco UltraSMR de 40 TB y fijó una hoja de ruta orientada a alcanzar los 100 TB para 2029. Este vertiginoso salto en la densidad de almacenamiento está transformando la arquitectura física de los centros de datos.
En esta carrera por la capacidad, la tecnología de grabación magnética escalonada (SMR) desempeña un papel determinante. En la grabación convencional (CMR), las pistas discurren contiguas con bandas de protección entre ellas. SMR, por el contrario, superpone las pistas a modo de tejas en un tejado. Dado que el cabezal de escritura es físicamente más ancho que el de lectura, solapar parcialmente las pistas permite al cabezal lector recuperar la información sin pérdidas, ganando entre un 10% y un 25% de capacidad adicional por plato.
Esta arquitectura repercute directamente sobre la capa de aplicaciones. La tecnología SMR es sumamente exigente con el perfil de la carga de trabajo: las escrituras secuenciales y las operaciones de anexado se ejecutan de forma óptima, pero las sobreescrituras aleatorias recurrentes desencadenan intensas reorganizaciones de zonas y recolección de basura. Ya sea mediante discos gestionados por el propio dispositivo (Drive-managed), conscientes del host (Host-aware) o gestionados íntegramente por este (Host-managed), el software de almacenamiento y el sistema operativo están obligados a adaptarse. El precio de exprimir más terabytes en el mismo espacio de rack consiste en trasladar la complejidad del hardware al software.
Sustratos de cristal para alcanzar la barrera de los 100 TB
La extracción de densidad magnética está llegando a los límites que impone la física. La grabación magnética asistida por calor (HAMR) utiliza un láser microscópico para calentar puntualmente una zona minúscula del plato durante la escritura, lo que permite registrar datos en granos magnéticos mucho más reducidos y térmicamente estables. Dado que HAMR y SMR abordan barreras físicas distintas, los fabricantes han dejado claro que combinarán ambas técnicas para alcanzar el objetivo de los 100 TB.
Para soportar los ciclos térmicos y la extrema precisión requerida, los tradicionales platos de aleación de aluminio están siendo reemplazados de forma progresiva. El uso de sustratos de vidrio o cristal ya es estándar en las unidades HAMR de 2,5 pulgadas y se está generalizando en los diseños de alta capacidad de 3,5 pulgadas. Reemplazar la base estructural del disco supone una reingeniería profunda y confirma que las aleaciones de aluminio han agotado su recorrido físico. La competencia en el centro de datos se ha desplazado hacia la ciencia de materiales: a medida que la capacidad unitaria se multiplica, cada salto en densidad exige un control térmico más riguroso y una amortiguación mecánica mucho más precisa.
Por el momento, la flota de 350.000 discos de Backblaze no incorpora unidades SMR, aunque la compañía ha confirmado que clasificará y analizará las tasas de fallo de estas nuevas tecnologías a medida que entren en producción. Al margen de cuántos platos de cristal contenga cada chasis hermético, el reto fundamental para los proveedores en la nube sigue siendo el mismo: mantener un índice de fallos predecible conforme los equipos envejecen. Cuando los discos de cristal de 100 TB sean la norma, la integridad de los datos ya no dependerá de la infalibilidad de cada unidad individual, sino de la capacidad del software de almacenamiento distribuido para absorber la turbulencia del hardware subyacente.
Enlaces de referencia:
- Informe Backblaze Drive Stats


