La plus vaste base de connaissances servant à entraîner les grands modèles de langage (LLM) est aujourd’hui polluée par les textes que ces algorithmes génèrent eux-mêmes. Sur la version anglophone de Wikipédia, les patrouilleurs luttent quotidiennement contre un déferlement continu d’articles rédigés par des machines. Selon les données de l’outil de détection Pangram, près de 20% des nouveaux articles publiés fin 2025 portaient la marque d’une génération synthétique. En refluant dans l’encyclopédie collaborative, les données synthétiques contaminent insidieusement la matière première des futures générations d’IA.
À première vue, la campagne de nettoyage menée par les bénévoles ressemble à une simple maintenance communautaire. En réalité, cette bataille défensive touche directement aux fondations documentaires de l’ensemble de l’industrie de l’intelligence artificielle. Un réservoir de savoir vérifié patiemment par des humains depuis plus de vingt ans risque de dégénérer en un marécage de faits contrefaits.
Cinq longs articles en cinq minutes : les patrouilleurs débusquent 20% d’entrées synthétiques
Les coulisses de Wikipédia subissent une crue documentaire inédite. Un rédacteur humain consulte des sources fiables, pèse chaque mot et consacre généralement plusieurs jours à la rédaction d’un article approfondi de plusieurs milliers de signes. Pourtant, dans les journaux de bord de 2026, de nouveaux comptes soumettent régulièrement cinq longs brouillons en moins de cinq minutes.
Les scripts automatisés ont réduit le coût marginal de production textuelle à zéro. Face à cette industrialisation du spam, Ellia Lebleu, doctorante en IA au centre Inria de Rennes, a sonné l’alarme. En décembre 2023, elle a fondé sur Discord, avec d’autres contributeurs bénévoles, l’initiative WikiProject AI Cleanup. Leur mission : traquer et expurger des dizaines de milliers d’articles encyclopédiques fabriqués à la chaîne par des machines.
Ces textes assemblés par des outils automatiques présentent une signature stylistique caractéristique. Ils abusent de structures ternaires et de parallélismes artificiels, déroulent une prose mécanique et adoptent des découpages de paragraphes interchangeables, dignes d’une chaîne de montage. La lecture paraît fluide, mais le fond n’est qu’un empilement d’adjectifs creux, dépourvu du moindre fait inédit ou vérifiable.
D’après les relevés de Pangram, environ 20% des nouvelles entrées fin 2025 étaient suspectées d’être issues de générateurs artificiels. Grâce à un travail d’épuration constant, cette proportion a reculé à environ 16% début 2026. Malgré cela, les productions artificielles représentent encore près d’un sixième des nouveaux contenus. Le coût de fabrication des rebuts numériques est tombé à zéro, tandis que le temps nécessaire à la vérification humaine demeure incompressible.
 Fig. : Composition graphique associant le globe de Wikipédia aux outils d’édition. Source : IEEE Spectrum
Moins de fausses citations, mais de vraies sources qui ne soutiennent pas le texte
Les volontaires du projet ont constaté que les outils de génération ont nettement gagné en subtilité au cours de l’année écoulée. Aux débuts de l’IA générative, les hallucinations étaient grossières. Les modèles inventaient des noms d’universitaires imaginaires ou indiquaient des numéros de revue fantaisistes. Il suffisait aux patrouilleurs de copier la référence dans un moteur de recherche académique pour démasquer l’imposture en quelques secondes.
Désormais, les scripts s’appuient presque systématiquement sur la génération augmentée de récupération (RAG). Le modèle extrait de véritables références avant d’écrire, puis insère de vrais liens et des ouvrages authentiques au bas de la page. Les sources existent bel et bien et les hyperliens fonctionnent, donnant l’illusion que les citations fictives ont disparu.
La tromperie n’en est devenue que plus pernicieuse. Le problème le plus fréquent consiste désormais en des citations bien réelles qui ne corroborent absolument pas l’affirmation du texte. Par exemple, une notice historique mentionnait avec précision un ouvrage universitaire reconnu en indiquant le numéro de page adéquat ; en consultant le livre physique, les bénévoles ont découvert que l’auteur ne faisait pas la moindre mention des faits racontés sur Wikipédia.
Ce genre de contrefaçon perfectionnée est indétectable lors d’une lecture rapide. Les patrouilleurs doivent endosser le rôle d’enquêteurs sur les fraudes scientifiques, se procurer des ouvrages imprimés ou éplucher des dizaines de pages d’articles universitaires. Vérifier une simple référence bibliographique ne prend plus quelques secondes, mais près d’une demi-heure.
Afin d’endiguer cette dérive, Wikipédia en anglais a officiellement promulgué en mars 2026 la recommandation WP:LLM, interdisant formellement l’utilisation de grands modèles pour rédiger ou reformuler le corps des articles. La communauté a également instauré le critère de suppression rapide WP:G15 pour les contenus issus de LLM. Quand les machines drapent des allégations fallacieuses dans des références authentiques, la vérification manuelle mot à mot reste le seul rempart.
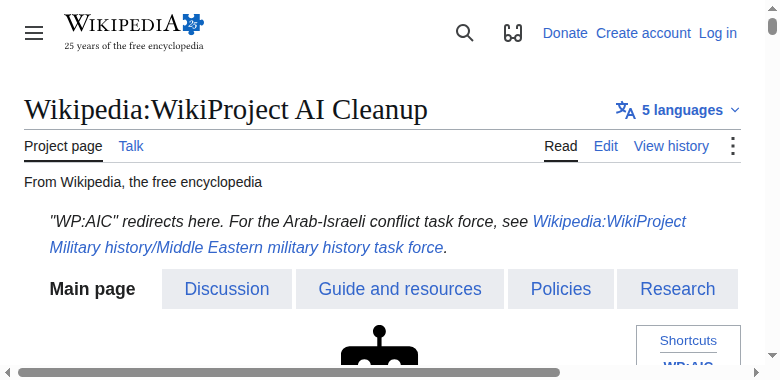 Fig. : Page d’accueil de WikiProject AI Cleanup, affichant la lutte contre les abus de textes automatisés comme objectif central. Source : Wikipedia
La réabsorption de textes synthétiques et l’effondrement des modèles
Si Wikipédia n’était qu’un forum de discussion ordinaire, l’afflux d’articles de remplissage ne nuirait qu’au confort des lecteurs. Mais à l’échelle de l’écosystème technologique de l’IA, l’encyclopédie en ligne constitue une source nourricière d’une importance capitale. Presque tous les modèles de frontière attribuent un poids d’échantillonnage prépondérant aux données de Wikipédia lors de leur pré-entraînement.
L’excellence de Wikipédia découle de plus de deux décennies d’examen minutieux par des contributeurs du monde entier. Les grands laboratoires ont largement exploité ce réservoir de savoir pour enseigner le bon sens et le raisonnement à leurs modèles. Si Wikipédia se retrouve polluée par des écrits automatisés, les modèles de demain absorberont leurs propres résidus comme des vérités établies.
Les chercheurs désignent cette dérive sous le nom de trouble de l’autophagie des modèles ou effondrement du modèle (model collapse). Dès lors qu’un modèle s’entraîne de manière répétée sur des données artificielles, les erreurs de départ s’amplifient de façon exponentielle au fil des itérations. Les réponses convergent inexorablement vers la moyenne, les connaissances rares mais cruciales s’évaporent, et le système finit par sombrer dans un délire incohérent.
Une enquête menée par la MIT Technology Review a mis en lumière la manière dont ce phénomène a dévasté certaines versions linguistiques régionales de Wikipédia. Dans les langues disposant de peu de contributeurs actifs, la part d’articles générés par des machines s’est envolée. Les modèles linguistiques entraînés ensuite sur ces données ont vu leurs performances s’effondrer, multipliant les propos hors sujet et les fabulations.
Un modèle progresse lorsqu’il ingère du savoir authentique ; il régresse s’il se nourrit de ses propres déchets. Chaque article factice supprimé par les bénévoles préserve un îlot de données pures pour les architectures futures.
Les archives antérieures à 2022 : l’« acier à faible radioactivité » du numérique
Dans les débats communautaires entre développeurs, nombreux sont ceux qui comparent désormais les archives web antérieures à la fin de 2022 à l’acier à faible radioactivité (low-background steel) utilisé en physique. La métaphore, empruntée à l’histoire industrielle et nucléaire, est saisissante.
Après l’explosion de la première bombe atomique en 1945, l’atmosphère terrestre s’est chargée d’isotopes radioactifs artificiels. Tout l’acier produit ensuite dans les hauts-fourneaux terrestres a absorbé ces particules radioactives lors du soufflage de l’air. Pour construire des instruments de mesure et des détecteurs ultrasensibles, les physiciens ne pouvaient employer d’acier moderne ; ils ont dû récupérer les blindages de navires coulés au fond des mers durant la Première Guerre mondiale.
L’arrivée de ChatGPT fin 2022 a constitué la première détonation atomique du monde informationnel. Depuis lors, le web public a été submergé par des contenus générés à la chaîne. Les flux de recherche sont saturés de déchets algorithmiques, tandis que la production humaine originelle se raréfie à grande vitesse.
Les archives web d’avant 2022 revêtent aujourd’hui le même caractère irremplaçable que cet acier historique. Les géants de l’IA rachètent à prix d’or les catalogues de maisons d’édition et font même l’acquisition de collections entières d’anciens livres de bibliothèques. Toutes ces manœuvres répondent à une même logique : mettre la main sur des réflexions humaines authentiques, exemptes de toute contamination algorithmique.
Le texte sur Internet a longtemps paru intarissable. Mais à l’heure où les retombées radioactives de la prose synthétique recouvrent le web, la parole humaine préservée est devenue une ressource stratégique non renouvelable.
La vérification manuelle mot à mot : ultime ligne de défense des faits humains
Face à cette vague de contenus synthétiques, les réponses purement algorithmiques montrent leurs limites. Les logiciels de détection statistique d’IA commettent de fréquents faux positifs et laissent passer de nombreuses fraudes. Il suffit aux opérateurs de reformuler légèrement leurs instructions ou de remplacer quelques synonymes pour contourner les filtres automatiques.
Ellia Lebleu concède volontiers qu’il est encore prématuré de mesurer l’efficacité réelle des nouvelles règles. Un règlement permet de discipliner les utilisateurs de bonne foi, mais il reste impuissant face aux réseaux automatisés de publication en masse.
Le véritable rempart demeure le travail minutieux des rédacteurs traditionnels de Wikipédia. Les bénévoles consultent de vieux livres papier et comparent les affirmations avec les numérisations de revues scientifiques. Avec une infinie patience, ils débusquent les contre-vérités phrase après phrase. Il ne faut que quelques secondes pour lancer un script Python et générer des dizaines de milliers de mots via une API ; il faut en revanche une demi-journée à un être humain pour vérifier l’exactitude d’un seul paragraphe.
Cette guerre d’usure est totalement asymétrique. Pourtant, ce sont ces bénévoles désintéressés qui, au milieu du tourbillon des déchets synthétiques, maintiennent fermement la digue de la vérité factuelle.
L’intelligence artificielle est en train de souiller son propre manuel d’apprentissage. En purgeant les articles générés par des machines, Wikipédia sauvegarde la base factuelle sans laquelle l’industrie de l’IA ne peut survivre. Si l’humanité renonce à exiger la vérité des faits fondamentaux et laisse les modèles se repaître de leurs propres excrétions, notre savoir numérique ne sera bientôt plus qu’un trompe-l’œil désert. Défendre le réel réclame encore, et toujours, le dévouement d’êtres humains en chair et en os.
Liens de référence :
- Grand reportage d’IEEE Spectrum
- Recommandations WP:LLM et WP:G15 de la version anglophone de Wikipédia
- Page du projet bénévole WikiProject AI Cleanup
- Enquête de la MIT Technology Review sur la pollution des corpus
- Débats de la communauté tech sur l’acier à faible radioactivité et le model collapse