Am 19. November 2026 hat Mechrevo seinen Enterprise-Desktop-KI-Rechner „Master X10“ offiziell vorgestellt. Mit Kantenlängen von rund 15 Zentimetern und einem Gewicht von lediglich 1,42 Kilogramm beherbergt das ultrakompakte Gehäuse NVIDIAs RTX Spark Superchip und stellt eine dauerhafte thermische Verlustleistung von bis zu 140 Watt bereit.
Das Basismodell mit 64 GB Unified Memory und einer 1 TB SSD startet bei 32.999 RMB (ca. 4.200 Euro). Eine High-End-Konfiguration mit 128 GB Speicher und 2 TB NVMe-Kapazität liegt bei 49.999 RMB (ca. 6.400 Euro). Damit packt der chinesische Hardwarehersteller ein vollständiges Rechenzentrum für Large Language Models in ein 1,25 Liter fassendes Aluminiumgehäuse.
Ab 32.999 RMB: Lokale KI-Rechenleistung wandert vom Serverraum auf den Schreibtisch
Der Einsatz großer Sprachmodelle in Unternehmen scheiterte bisher oft an den physischen Rahmenbedingungen. Um Spitzenmodelle lokal zu betreiben, mussten Entwicklerteams entweder teure Rack-Server anschaffen oder auf Cloud-Computing-Cluster ausweichen. Server-Racks erfordern klimatisierte Serverräume, eigene Stromkreise und Schallschutzmaßnahmen. Cloud-Dienste wiederum werfen Bedenken hinsichtlich Datensouveränität und Latenzschwankungen bei API-Anfragen auf.
Klassische Serverhardware stellt hohe Anforderungen an die Stromversorgung: Standardmäßige 2U-Server verlangen dedizierte 16A-Sicherungen und kontrollierte Umgebungstemperaturen. Der Master X10 benötigt unter Volllast dagegen lediglich 140 Watt und lässt sich an jeder handelsüblichen 10A-Schreibtischsteckdose betreiben. Kleine und mittlere Teams erhalten so eine lokale LLM-Infrastruktur ohne kostspielige Umbauten der Büroelektrik.
Damit bietet der Master X10 einen pragmatischen Mittelweg. Die Anschaffungskosten von 32.999 RMB entsprechen einer High-End-Workstation, machen den Bau eines Serverraums jedoch komplett überflüssig. Das Gerät kann ohne geräuschdämmende Serverschränke direkt am regulären Arbeitsplatz betrieben werden.
Dieser Formfaktor verändert die Bereitstellung privater KI-Modelle grundlegend. Designteams und quantitative Analysegruppen können Inferenz-Pipelines direkt lokal ausführen. Quellcode und vertrauliche Unternehmensdaten verbleiben vollständig im lokalen Netzwerk (LAN), unberührt von Störungen oder Ausfällen des öffentlichen Internets.
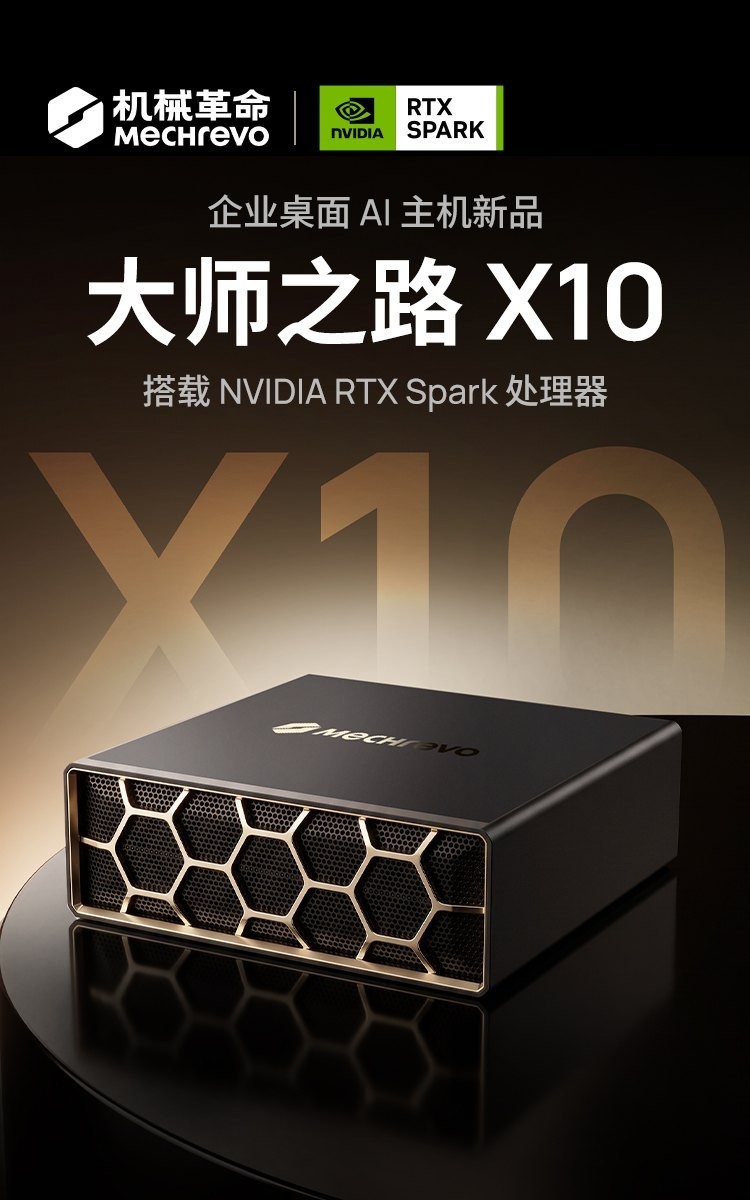 Abbildung: Spezifikationen und Gehäusedesign des Mechrevo Master X10 Enterprise-KI-Desktops. Quelle: Offizielle Pressemitteilung von Mechrevo.
140 Watt Verlustleistung auf 1,25 Litern: Doppel-Radiallüfter bändigen dichte Rechenlasten
Eine derart hohe Leistungsaufnahme in einem Miniaturgehäuse dauerhaft zu kühlen, stellt höchste Anforderungen an die Aerodynamik. Mit Abmessungen von 155×158×51 Millimetern beansprucht der Master X10 ein Volumen von lediglich 1,25 Litern. Im Vergleich zu sperrigen Serverschränken nimmt er kaum mehr Stellfläche ein als ein gebundenes Buch.
Mechrevo fertigt das Unibody-Gehäuse im CNC-Fräsverfahren vollständig aus Metall. Die Frontblende kombiniert einen goldfarbenen Aluminiumrahmen mit einem Waben-Lüftungsgitter für maximalen Luftdurchsatz. Das Metallgehäuse fungiert dabei selbst als passiver Kühlkörper und leitet Abwärme von den internen Komponenten ab.
Im Inneren arbeiten zwei Radiallüfter zusammen mit 70 Kühllamellen. Eine Heatpipe-Matrix verteilt die Hitze des Chips rasch auf Kupferlegierungs-Radiatoren. Selbst bei intensiven Matrix-Berechnungen hält dieses Kühlsystem eine Dauerleistung von 140 Watt aufrecht und leitet Hitze zügig ab, um thermisches Drosseln (Thermal Throttling) zuverlässig zu verhindern.
Das Lufteinlassgitter bietet einen Öffnungsgrad von über 60 Prozent, was die Strömungsgeschwindigkeit spürbar erhöht. Hydrodynamische Gleitlager der Lüfter dämpfen mechanische Vibrationen auch bei hohen Drehzahlen wirksam ab.
Während typische Serverlüfter oft Geräuschpegel von über 65 dB erreichen, hält der Master X10 den Schallpegel im Leerlauf und bei moderater Inferenz auf dem Niveau normaler Büroumgebungen. Entwickler können unmittelbar neben dem laufenden System programmieren, ohne von niederfrequentem Lüfterlärm gestört zu werden.
Unified Memory überwindet den PCIe-Flaschenhals: 300 GB/s Bandbreite für große Modelle
Das Herzstück des Systems bildet NVIDIAs RTX Spark Superchip. Er liefert 1 Pflops an FP4-Sparse-Rechenleistung und unterstützt modernste Tensor-Core-Befehlssätze. Die hardwarebeschleunigte Gleitkomma-Berechnung mit geringer Bitbreite steigert den Inferenzdurchsatz moderner Sprachmodelle signifikant.
Der entscheidende architektonische Vorteil liegt im 300 GB/s schnellen Unified Memory. In herkömmlichen Desktop-Systemen sind Grafikspeicher (VRAM) und Systemspeicher (RAM) physisch getrennt. Modellgewichte müssen permanent über den Systembus zwischen Hauptspeicher und Grafikkarte hin- und hergeschaufelt werden, limitiert durch die Bandbreite der PCIe-Steckplätze.
Selbst die aktuelle PCIe 5.0 x16-Schnittstelle liefert in eine Richtung maximal 64 GB/s. Das kontinuierliche Paging großer Modellgewichte verursacht erhebliche Latenzen. Der On-Die-Bus des RTX Spark beseitigt diese Engstelle vollständig.
Durch die Integration von LPDDR5X-Speicher mit hoher Bandbreite teilen sich CPU und GPU einen gemeinsamen physischen Adressraum. Die Kapazität von bis zu 128 GB erlaubt das Laden von Modellen mit 70 Milliarden Parametern ohne aufwendiges Tensor-Sharding. Der Ladevorgang erfolgt nahezu verzögerungsfrei, und dank Zero-Copy-Zugriff entfällt jeglicher Bus-Transfer-Overhead.
Die einheitliche Adressierung reduziert zudem den Speicherbedarf autonomer KI-Agenten. Mehrere Hintergrund-Agenten können dauerhaft aktiv bleiben und auf den geteilten Cache der Basismodell-Gewichte zugreifen. Bei gleichzeitiger Ausführung mehrerer lokaler Tasks sinkt das Risiko von Out-of-Memory-Abstürzen drastisch.
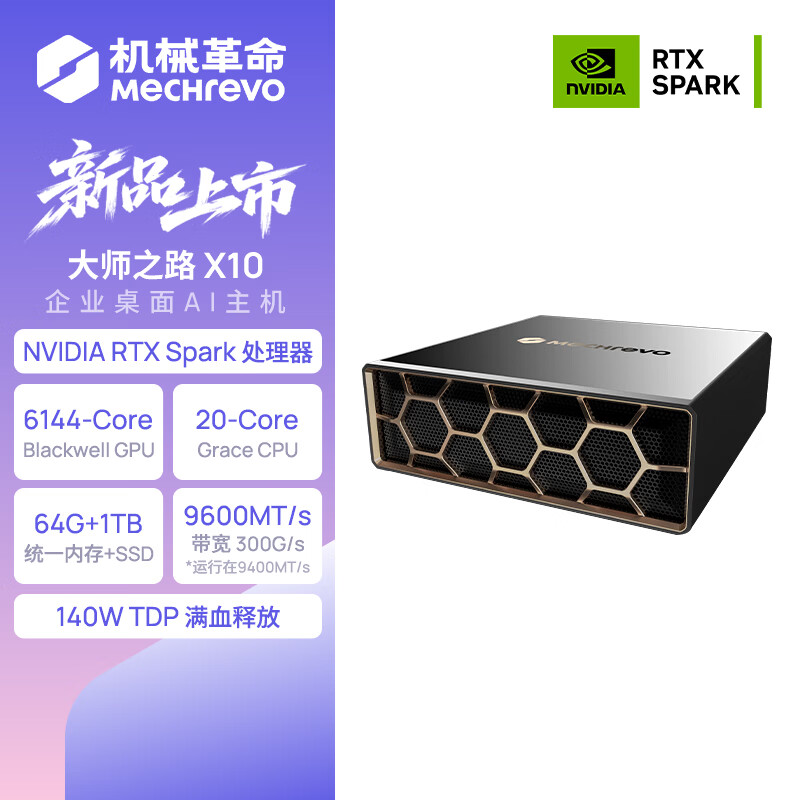 Abbildung: Industriedesign und Schnittstellen-Layout des Mechrevo Master X10 Mini-PCs. Quelle: Offizielles Produktbild von Mechrevo.
10GbE und vier Type-C-Ports: Desktop-Gerät mit vollständiger Edge-Konnektivität
Lokale Rechenknoten müssen sich nahtlos in bestehende Netzwerke einfügen. Der Master X10 ist serienmäßig mit einem 10GbE-Ethernet-Anschluss ausgestattet. Bei internen Übertragungsraten von bis zu 1,2 GB/s lassen sich Modelldateien mit mehreren Dutzend Gigabyte in weniger als einer halben Minute übertragen.
Diese schnelle Netzwerkanbindung ermöglicht das problemlose Zusammenspiel mit lokalen NAS-Systemen. Teams können Modellbibliotheken und LoRA-Gewichte zentral auf Netzwerkspeichern vorhalten; der Mini-PC lädt benötigte Daten bei Bedarf nach, ohne die lokale SSD zu überlasten.
Auch die Schnittstellenausstattung deckt professionelle Anforderungen ab: Vier vollwertige USB-C-Anschlüsse und ein HDMI 2.1-Ausgang stehen bereit. Entwickler können externe NVMe-SSDs ebenso anschließen wie hochauflösende Monitore. Für die drahtlose Kommunikation sorgen Wi-Fi 7 und Bluetooth 5.4.
An der Gehäuseseite befindet sich eine Kensington-Schloss-Buchse. Bei einem Gerät dieser Preisklasse, das kompakt genug ist, um in einer Aktentasche zu verschwinden, ist physischer Diebstahlschutz in offenen Bürolandschaften unverzichtbar. Unternehmen sichern ihre Hardware-Investition somit ohne sperrige Serverschränke ab.
Das Software-Ökosystem ist ab Werk einsatzbereit: NVIDIA liefert vollständige CUDA-Treiber und die TensorRT-LLM-Inferenz-Engine für die Plattform. Entwickler können direkt vorkompilierte Container starten und langwierige Anpassungsprozesse vermeiden, die bei Nischenhardware häufig auftreten.
Haushaltsgeräte-Komfort senkt Betriebskosten, fehlende Aufrüstbarkeit bleibt der Preis
Die Vorstellung des Master X10 hat in Entwicklerkreisen reges Interesse geweckt. Befürworter heben vor allem die drastisch reduzierten Betriebs- und Wartungskosten hervor. Während für Server bisher regelmäßige Kontrollen im Rechenzentrum nötig waren, lässt sich der neue Mini-PC so unkompliziert bedienen wie ein gewöhnliches Bürogerät.
Kritikpunkte betreffen den Einstiegspreis und die fehlende Aufrüstbarkeit. Mit 32.999 RMB liegt das System deutlich über typischen PC-Budgets. Da der LPDDR5X-Speicher fest auf der Platine verlötet ist, lässt er sich nachträglich nicht erweitern. Sollten zukünftige Generationen von Spitzenmodellen noch größere Parameterdimensionen erfordern, stößt das Gerät an eine harte Speicherobergrenze.
Dennoch überzeugt die Total Cost of Ownership (TCO): Verglichen mit laufenden Kosten für Rack-Miete, Klimatisierung und spezialisierte Systemadministratoren amortisiert sich der Desktop-Rechner über einen Nutzungszeitraum von zwei bis drei Jahren spürbar.
Zudem verlangt die ARM-basierte Plattform gewisse Anpassungen. Zwar sind moderne KI-Frameworks weitgehend nativ verfügbar, ältere proprietäre Unternehmensdatenbanken oder spezifische Entwicklerbibliotheken müssen bei einem Wechsel jedoch unter Umständen neu kompiliert werden.
Mit der Bündelung von Enterprise-Rechenleistung in einem 1,25-Liter-Aluminiumgehäuse unterstreicht Mechrevo den Trend, KI-Inferenz direkt an den Arbeitsplatz zu verlagern. Die hohe Integrationsdichte und der einheitliche Speicher senken die Hürden für lokale Deployments enorm. Auch wenn Abstriche bei der Modularität unvermeidbar sind, markiert dieses kompakte Plug-and-Play-Konzept einen wichtigen Schritt zur Demokratisierung lokaler Rechenleistung.
Weiterführende Links:
- Mechrevo Master X10 Produktspezifikationen
- NVIDIA RTX Spark Architektur-Whitepaper
- Mechrevo Flagship-Store auf JD.com