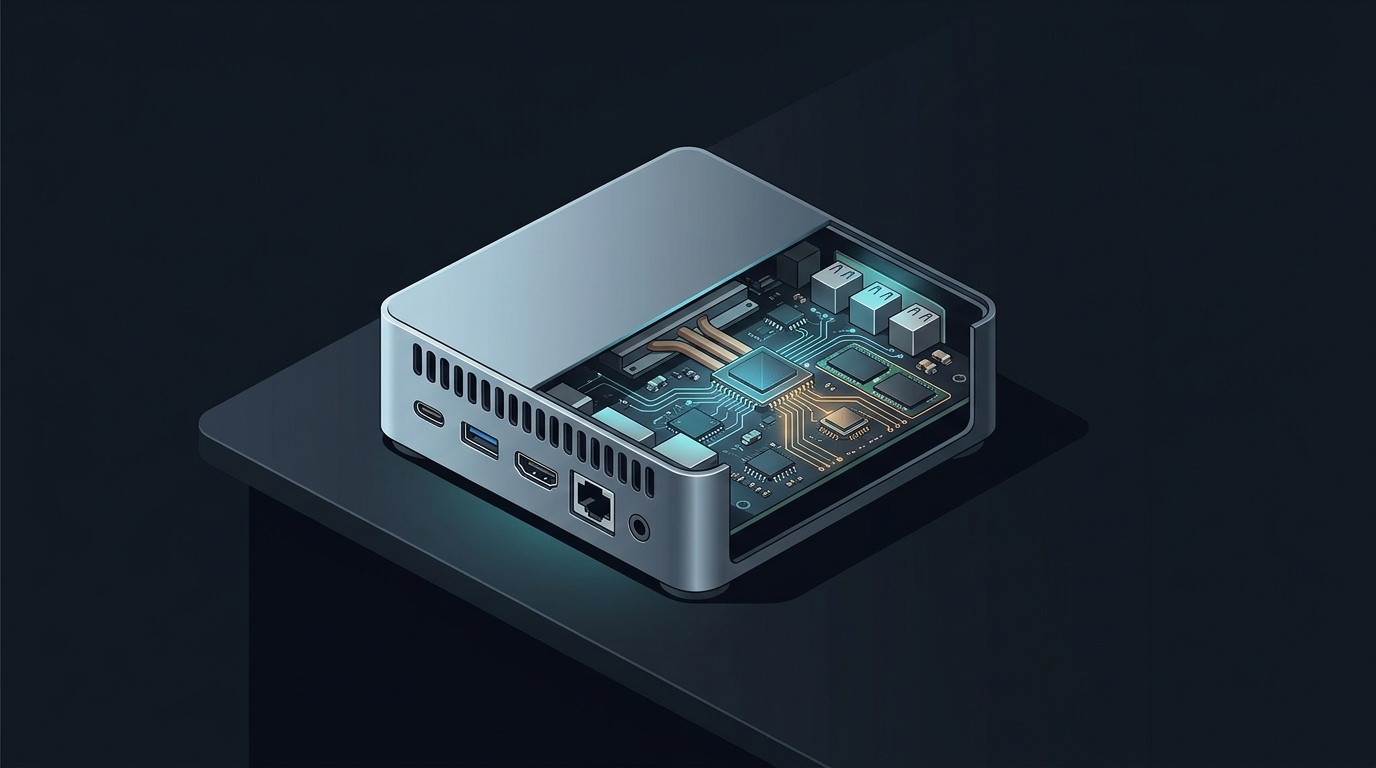
2026年11月19日、Mechrevo(機械革命)は企業向けデスクトップAIマシン「Master X10(大师之路 X10)」の販売を正式に開始しました。本体は縦横約15cm、重量わずか1.42kg。このコンパクトな筐体の中にNVIDIAの「RTX Spark」スーパーチップを搭載し、最大140Wのパフォーマンスを安定して引き出します。
ベースモデルは64GBのユニファイドメモリと1TB SSDを搭載し、価格は32,999元(約70万円)。上位モデルは128GBメモリと2TBストレージを備え、49,999元(約106万円)に設定されています。中国PCメーカーの手により、大規模モデルの演算ユニットが1.25リットルのアルミニウム製ボックスへと凝縮されました。
32,999元から:AI推論環境をサーバルームからデスク上へ解放
企業における大規模言語モデル(LLM)の導入は、これまで物理的な設置環境に縛られてきました。最先端モデルを運用するには、ラックマウントサーバを購入するか、クラウド上のコンピュートクラスタを契約するかの二者択一でした。しかし、ラック設置には専用サーバルームや大容量電源、防音対策が不可欠であり、クラウド運用にはデータ越境やAPIキューの遅延といった懸念が付きまといます。
従来のラックマウント機器は電力インフラにも厳しい要件を課します。標準的な2Uサーバでは専用の16Aブレーカーや恒温環境が要求されます。これに対し、Master X10のシステム最大消費電力はわずか140W。一般的な10Aのデスク用コンセントに接続するだけで即座に稼働します。中小規模のチームでもオフィス配線を改修することなく、ローカルLLM環境を手に入れることが可能です。
Master X10は現実的な妥協点を提供します。初期費用の32,999元はハイエンドワークステーションと同等ですが、サーバルームの構築コストを完全に省けます。防音キャビネットを用意することなく、通常のオフィスデスク上に設置して電源を入れるだけで使用できます。
このフォームファクタは、プライベートAIの導入プロセスを根本から変えます。設計チームやクオンツ運用グループは、自席でローカルに推論パイプラインを回せるようになります。コアコードや機密業務データをすべてローカルネットワーク内にとどめ、パブリック回線の遅延や揺らぎに左右されずに高速な応答を得られます。
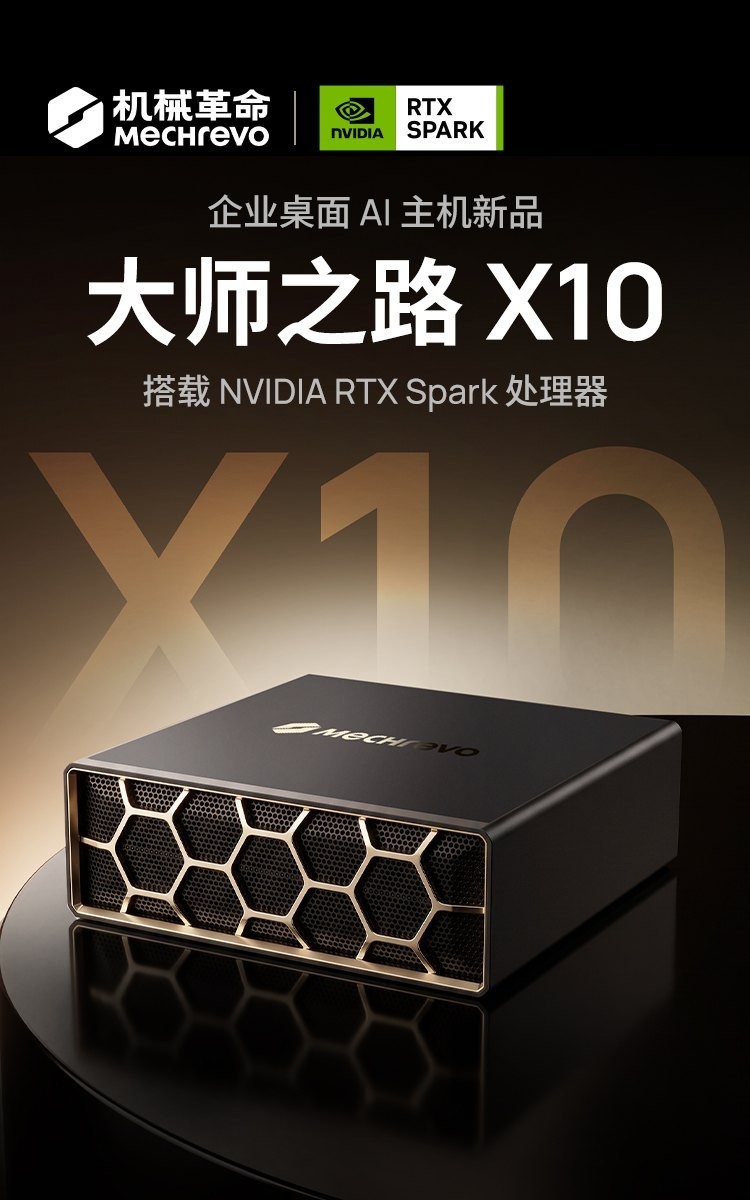 図:Mechrevo Master X10 企業向けデスクトップAIマシンの仕様と外観。出典:Mechrevo公式発表。
1.25Lに140Wの発熱を凝縮:デュアルターボファンが密な演算を冷却
極小ケースの中で高出力を維持するには、エアフロー設計の限界が試されます。Master X10の寸法は155×158×51mmで、総容積はわずか1.25リットル。数十リットルに及ぶ一般的なサーバ筐体と比べ、占有面積はほぼハードカバー本1冊分にすぎません。
Mechrevoは筐体の製造にフルメタルCNC加工を採用しました。フロントパネルにはゴールドのアルミフレームとハニカム吸気グリルを配置し、吸気効率を最大化。金属製ボディ自体もヒートシンクとして機能し、内部コンポーネントの排熱負荷を分散させます。
内部にはデュアルターボファンと70枚の放熱フィンを凝縮。ヒートパイプアレイがチップの熱を銅合金製ヒートシンクへ瞬時に分散します。密な行列演算が続く過酷なワークロードでも140Wの持続出力を維持し、熱気を素早く外部へ排出してサーマルスロットリングを防ぎます。
吸気グリルの開口率は60%を超え、空気の流入速度を大幅に向上。油圧ベアリングを採用したデュアルファンにより、高速回転時でも機械的共振を抑え込みます。
一般的なサーバの高速ファンは65dBを超える騒音を発生させます。Master X10は風響と吸気抵抗を最適化し、アイドル時や通常推論時の動作音をオフィス環境基準に抑えています。エンジニアが本体のすぐ横でコーディングを続けても、不快な低周波ノイズに悩まされることはありません。
ユニファイドメモリがPCIeのボトルネックを解消:300GB/s帯域が支える大モデル
本機の心臓部となるのが、NVIDIAのRTX Sparkスーパーチップです。FP4スパース演算で1 Pflopsの性能を提供し、新世代のTensorコア命令セットをサポート。低精度浮動小数点アクセラレーションにより、言語モデル推論のスループットを飛躍的に高めています。
アーキテクチャ上の最大の強みは、300GB/sの帯域幅を誇るユニファイドメモリにあります。従来のセパレート型デスクトップでは、グラフィックボードのVRAMとCPUメインメモリが物理的に分離しています。モデルの重みパラメータはマザーボードのバスを介してメモリ間を往復せざるを得ず、PCIeスロットが重大なボトルネックとなっていました。
最新のPCIe 5.0 x16規格であっても、片方向の帯域幅は64GB/sにとどまります。システムメモリとGPU VRAM間でモデルの入れ替えが頻発すると、深刻な待機遅延が発生します。RTX Sparkのオンダイバスはこの断絶を完全に解消しました。
RTX Sparkは広帯域なLPDDR5Xメモリを統合し、CPUとGPUが同一の物理アドレス空間を共有します。最大128GBの大容量により、700億パラメータ規模のモデルを複雑なテンソル分割なしで丸ごとロード可能。ロードは瞬時に完了し、ゼロコピーによってバスをまたぐ転送オーバーヘッドも生じません。
統合アドレッシングは、自律型AIエージェントのメモリ消費も大幅に抑制します。バックグラウンドで稼働する複数のエージェントが、ベースモデルの重みキャッシュを効率的に共有して常駐できます。ローカルで複数のタスクを並行処理する際も、VRAM不足エラー(OOM)に直面するリスクが劇的に減少します。
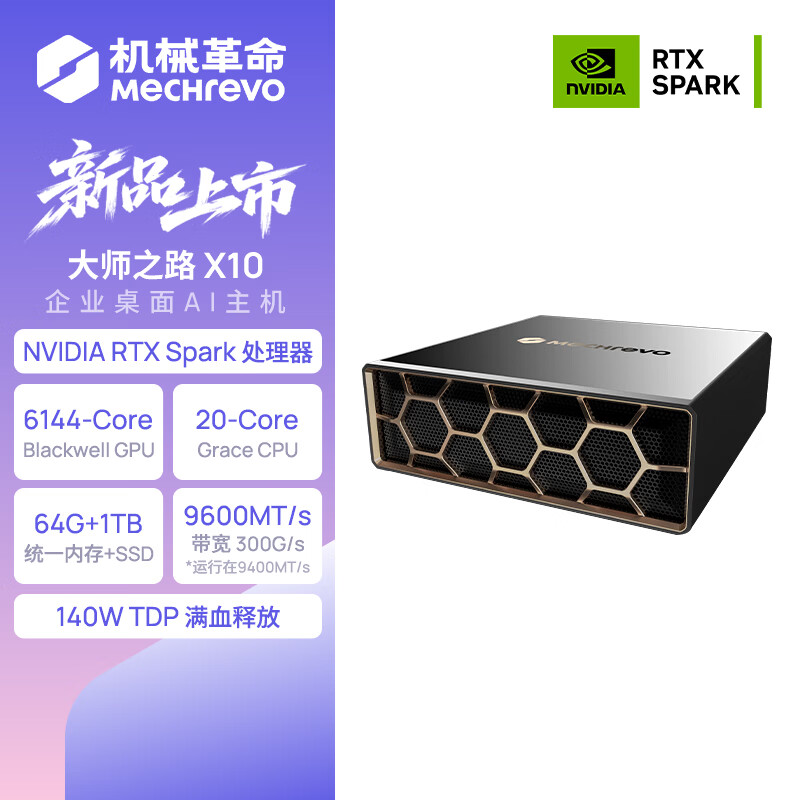 図:Mechrevo Master X10 ミニPCの外観とインターフェース配置。出典:Mechrevo公式製品画像。
10GbEと4基のType-C:デスクトップ家電が補うエッジインターコネクト
オンデバイス端末には、既存のオフィスネットワークへ即座に統合できる拡張性が求められます。Master X10は10GbE(10ギガビットイーサネット)ポートを標準装備。社内LANの転送速度は最大1.2GB/sに達し、数十ギガバイトに及ぶモデルファイルの転送もわずか数十秒で完了します。
この高速な有線ネットワークにより、小型PCと社内NASのスムーズな連携が可能になります。チームの共有ストレージ上でモデルライブラリやLoRA重みを一括管理し、ローカルSSDの容量を圧迫することなく必要に応じてオンデマンドで取得できます。
外部インターフェースも拡張性を考慮しています。4基のフル機能USB-CポートとHDMI 2.1出力を搭載。高速な外付けポータブルSSDの接続からマルチディスプレイ環境の構築まで柔軟に対応します。ワイヤレス通信には最新のWi-Fi 7とBluetooth 5.4を採用しました。
側面にはケンジントンロック用セキュリティスロットを備えています。数十万円相当の高価なハードウェアでありながら、バックパックに容易に収まるサイズであるため、オープンオフィス環境における盗難対策は必須です。高価な施錠付きサーバルームを増設せずとも、物理的なセキュリティを担保できます。
ソフトウェアスタックも万全です。NVIDIAは本チップ向けに完全なCUDAドライバとTensorRT-LLM推論ライブラリを提供しています。開発者はコンテナイメージを取得するだけで即座にサービスを立ち上げることができ、マイナーなハードウェアにありがちな長いセットアップ期間を回避できます。
運用の家電化というメリットと、拡張不可という長期的な代償
Master X10の登場は、技術コミュニティに大きな反響を呼んでいます。評価派が注目するのは、圧倒的な運用保守コストの低さです。これまでローカルサーバの維持にはサーバルームの巡回監視など専任の管理工数が必要でした。今では一般的なエンジニアが、家電感覚でローカルAI演算を利用できます。
一方で、価格設定と将来の拡張性に対する懸念も根強く存在します。32,999元からのスタート価格は一般のPC購入予算を大きく上回ります。また、LPDDR5Xメモリは基板直付けのオンボード仕様であるため、ユーザー自身での増設や交換はできません。今後フロンティアモデルのサイズがさらに肥大化した場合、マシンのメモリ容量がボトルネックとなる可能性があります。
しかし、総所有コスト(TCO)の観点から見れば有力な選択肢です。サーバラックのレンタル代、専用空調の電気料金、専任システム管理者の人件費などと比較すると、デスクトップ型ミニPCは2〜3年の運用サイクルにおいて隠れた維持コストを大幅に削減します。
ARMアーキテクチャの採用による環境差異も無視できません。主要なAIツールチェーンはネイティブ対応しているものの、社内のレガシーデータベースや特殊なライブラリを移行する際には再コンパイルの手間が生じる場合があります。
Mechrevoがエンタープライズ級の演算力を1.25Lのアルミボックスに凝縮したことは、オンデバイスAIが机上へと浸透する潮流を象徴しています。高密度なハードウェア設計とユニファイドメモリの採用により、ローカルでの環境構築ハードルは大きく引き下げられました。パーツ換装の柔軟性をトレードオフとしながらも、このプラグアンドプレイの小型フォームファクタは、デスクトップAI普及の新たな幕開けを告げています。
参考リンク:
- Mechrevo Master X10 製品仕様
- NVIDIA RTX Spark アーキテクチャ技術白書
- JD.com Mechrevo公式旗艦店 販売ページ