Una niña de cuatro años entra corriendo y en pantalla aparece un guepardo
Alrededor de una mesa familiar, intervenir en una conversación requiere apenas medio segundo. Para una persona con pérdida severa del habla que depende de un seguidor ocular, redactar una sola frase puede tomar varios minutos. Para cuando las letras terminan de alinearse penosamente en la pantalla, el hilo de la charla ya ha cambiado tres veces.
Casey Harrell, un californiano de 47 años, tuvo que soportar ese silencio durante años. En 2020 fue diagnosticado con esclerosis lateral amiotrófica (ELA), una enfermedad neurodegenerativa que paraliza de forma progresiva la musculatura de todo el cuerpo. Con el avance de la patología, sus labios y su lengua perdieron la fuerza. Harrell apenas lograba articular con esfuerzo seis palabras por minuto, reduciendo la comunicación cotidiana a un punto muerto. Solo su esposa y su cuidador principal lograban descifrar sus intenciones mediante conjeturas.
En el verano de 2023, Harrell se sometió a una intervención neuroquirúrgica en UC Davis Health. Los cirujanos colocaron cuatro diminutos chips sobre la corteza cerebral para interceptar las señales motoras del habla. En la tarde del segundo día tras encender el equipo, su hija de cuatro años entró corriendo a la habitación con un pijama de guepardo. En cuanto Harrell pensó en hablarle, el altavoz situado a su lado emitió una voz nítida: “Estoy buscando a un pequeño guepardo”.
Al otro lado del monitor, los investigadores quedaron atónitos. Temieron que el algoritmo de decodificación hubiese sufrido un fallo aleatorio. Pero al ver en el vídeo a la pequeña correteando por la sala, el laboratorio estalló en aplausos. El algoritmo no había fallado: un padre estaba respondiendo en directo a su hija.
 Figura: Un pódcast de Science News documenta cómo las interfaces cerebro-computadora devuelven la voz a personas sin habla. Fuente: Science News / PRX.
Interceptar las órdenes motoras con 256 microelectrodos
Es común imaginar que una interfaz cerebro-computadora (BCI) lee la mente. En la práctica, los sistemas actuales no interpretan pensamientos abstractos. El equipo de investigación fijó su objetivo de manera estricta en las órdenes mecánicas que el cerebro envía a los músculos articulatorios del habla.
Hablar es una de las tareas biomecánicas más intrincadas del cuerpo humano. Con cada palabra, el cerebro debe coordinar más de cien pequeños músculos en cuestión de decenas de milisegundos. Labios, lengua, mandíbula y cuerdas vocales tienen que actuar en perfecta sincronía. Aunque la ELA destruye las vías nerviosas que comunican con esos músculos periféricos, paralizando la garganta, la corteza motora del habla permanece intacta. Cada vez que Harrell intenta hablar, su cerebro continúa disparando impulsos coordinados con total intensidad.
El equipo médico implantó cuatro matrices de microelectrodos —chips de silicio de apenas unos milímetros de ancho— en el giro precentral izquierdo (la zona cerebral que gobierna la musculatura vocal). Un total de 256 finas agujas penetraron a menos de dos milímetros en la corteza cerebral. Basta con que Harrell intente mover los labios o la lengua en su mente para que los electrodos detecten las descargas neuronales. Las órdenes motoras enviadas a los músculos son interceptadas directamente en su origen neuronal.
Descomponer las ondas cerebrales en 39 bloques fonéticos
Una vez capturadas las señales neuronales, ¿cómo convertirlas en lenguaje fluido? El equipo recurrió a las unidades estructurales de la lingüística.
Todo el vocabulario cotidiano en lengua inglesa puede desarticularse en 39 fonemas, las piezas elementales del sonido vocal. Para pronunciar un simple “hello”, el cerebro ejecuta una secuencia de cuatro gestos articulatorios coordinados. Esta lógica simplificó el pipeline de decodificación: en lugar de adivinar ideas difusas, el sistema clasifica las señales neuronales en estos 39 bloques fonéticos. Posteriormente, un modelo de lenguaje ensambla los fonemas en palabras y oraciones gramaticalmente coherentes. El problema se transformó en un rompecabezas de reglas exactas.
El primer día de funcionamiento, Harrell realizó apenas 30 minutos de calibración. En una prueba con 50 palabras habituales, la precisión del sistema alcanzó el 99,6%. Al segundo día, los investigadores ampliaron el léxico a 125.000 palabras. El vocabulario de un adulto promedio suele rondar entre 20.000 y 30.000 vocablos; 125.000 palabras equivalen a un diccionario enciclopédico. Frente a esa escala léxica masiva, la precisión inicial fue del 90,2%, estabilizándose en meses posteriores en el 97,5%. Dividir las órdenes cerebrales en fonemas discretos permitió al algoritmo escalar a la riqueza de un diccionario completo.
Recuperar el timbre original a partir de grabaciones previas
Transformar intenciones en frases es solo el primer paso. El timbre de la voz define la calidez de cualquier intercambio humano. Históricamente, los sistemas de asistencia vocal han recurrido a sintetizadores genéricos: voces metálicas y planas que suenan como una máquina recitando un manual.
Harrell quería volver a sonar como él mismo. El equipo recopiló grabaciones de entrevistas y episodios de pódcast en alta definición grabados antes de que enfermara. Los algoritmos de aprendizaje automático extrajeron los matices de su timbre, su cadencia y sus patrones de dicción. Con esos parámetros, entrenaron un modelo de voz personalizado. Cuando las señales neuronales completan una frase, los altavoces reproducen el timbre genuino de Harrell. Ya no es una máquina hablando en su lugar; es él quien vuelve a llenar la habitación con su propia voz.
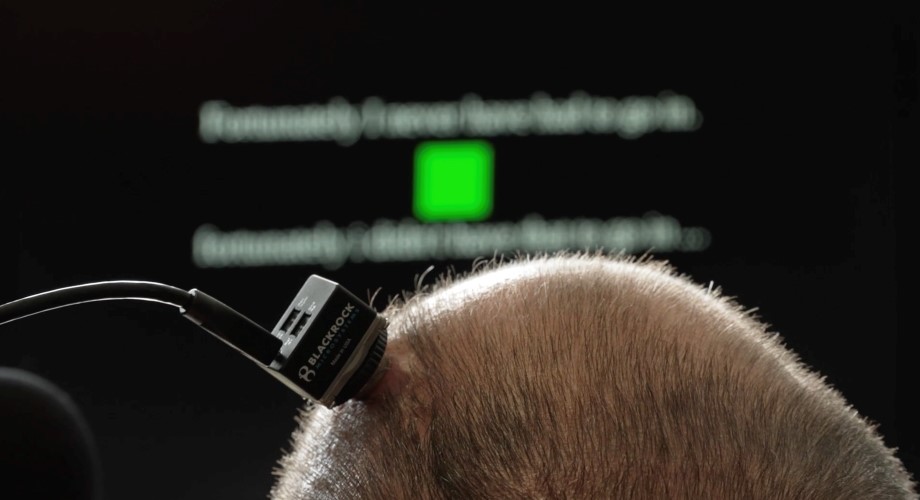 Figura: Casey Harrell revisa en pantalla las palabras decodificadas en tiempo real mediante su interfaz cerebro-computadora. Fuente: UC Davis Health.
La latencia de respuesta se redujo a unos 80 milisegundos. Un parpadeo humano dura entre 100 y 400 milisegundos. Los 80 ms son más rápidos que un parpadeo y equivalen a la demora natural con la que oímos nuestra propia voz al hablar. Esta respuesta inmediata devolvió a la conversación su ritmo espontáneo de ida y vuelta. Al escuchar su voz familiar en cuestión de milisegundos, el paciente recupera su identidad personal.
1,96 millones de palabras en dos años: el regreso a la vida familiar
Llevar una tecnología desde una demostración de laboratorio hasta el hogar cotidiano supone un abismo. En junio de 2026, Nature Neuroscience publicó los datos del seguimiento a largo plazo. A lo largo de casi dos años, Harrell utilizó el equipo en su domicilio de forma totalmente autónoma durante más de 3.800 horas. Encendido entre 10 y 14 horas al día, generó 183.060 frases y un total de 1.960.163 palabras. Durante todo el periodo, el sistema mantuvo una precisión global del 92% en las oraciones, con una velocidad media de 56 palabras por minuto.
Esa velocidad tiene una trascendencia vital tangible. El habla humana cotidiana oscila entre 120 y 150 palabras por minuto. Tras el avance de la enfermedad, la capacidad articulatoria natural de Harrell había caído a 6 palabras por minuto. Alcanzar 56 palabras por minuto significa recuperar más de un tercio de la fluidez conversacional normal. En lugar de callar durante minutos frente a un teclado, ahora puede participar de forma activa en las charlas durante la cena familiar.
La tecnología aún exige concesiones físicas. Harrell conserva dos pequeños conectores percutáneos en el cráneo, conectados por cables a un ordenador y a la corriente eléctrica, lo que limita sus desplazamientos. Es, por el momento, el único paciente en el mundo que utiliza una neuroprótesis vocal con este nivel de intensidad en su vida diaria.
Sin embargo, el verdadero valor reside en la cotidianidad recuperada. En entrevistas, Harrell subrayó cómo el sistema le ha permitido conversar con su hija de cuatro años, compartir confidencias con su esposa y bromear con viejos amigos.
Decodificar directamente las órdenes de los músculos orofaciales elude el lento paso intermedio de escribir pensamientos. Las neuroprótesis del habla han cruzado la frontera entre el teclado ortopédico y la conversación natural. Con el regreso de su voz a la sala de estar, Harrell ha recuperado la dignidad diaria de ser padre y esposo.
Enlaces de referencia:
- Pódcast de Science News: Cómo es hablar utilizando el cerebro.
- Artículo de Nature: Neuroprótesis del habla rápida y de alta precisión en un paciente con ELA.
- UC Davis Health: Tecnología pionera permite hablar en tiempo real a un hombre con ELA.