Modificar una sola etiqueta dentro de una lista de 3.000 filas le cuesta a GPUI 8,4 milisegundos de renderizado nativo. En una pantalla de 120 Hz, el presupuesto completo para un fotograma es de apenas 8,3 milisegundos. Una actualización de texto minúscula agota la totalidad del tiempo disponible. Si se recurre a elementos básicos sin almacenamiento en caché, la cifra se dispara hasta los 92 milisegundos.
Los frameworks modernos modelan las vistas como funciones puras del estado para ofrecer APIs declarativas elegantes. Aunque esto evita sincronizar nodos manualmente, rompe el vínculo necesario para deducir dependencias de grano fino. La batalla entre los frameworks de escritorio se centra ahora en si su modelo de estado puede expresar un grafo de dependencias reactivo. Sin seguimiento de dependencias de lectura, cualquier cambio mínimo se degrada en un recorrido exhaustivo por todo el árbol de componentes.
Cambiar una etiqueta tarda 8,4 ms: las vistas puramente funcionales recorren todo el árbol
Zed construyó su reputación sobre un rendimiento nativo vertiginoso. Sin embargo, las pruebas de estrés con listas extensas han expuesto cuellos de botella estructurales. Un caso de prueba creado por el desarrollador zortax simula una lista de 3.000 filas con caché de vista activada en cada una. Con solo alterar una de las etiquetas, GPUI tarda 8,4 milisegundos en completar la actualización, aumentando de forma lineal con el número de filas.
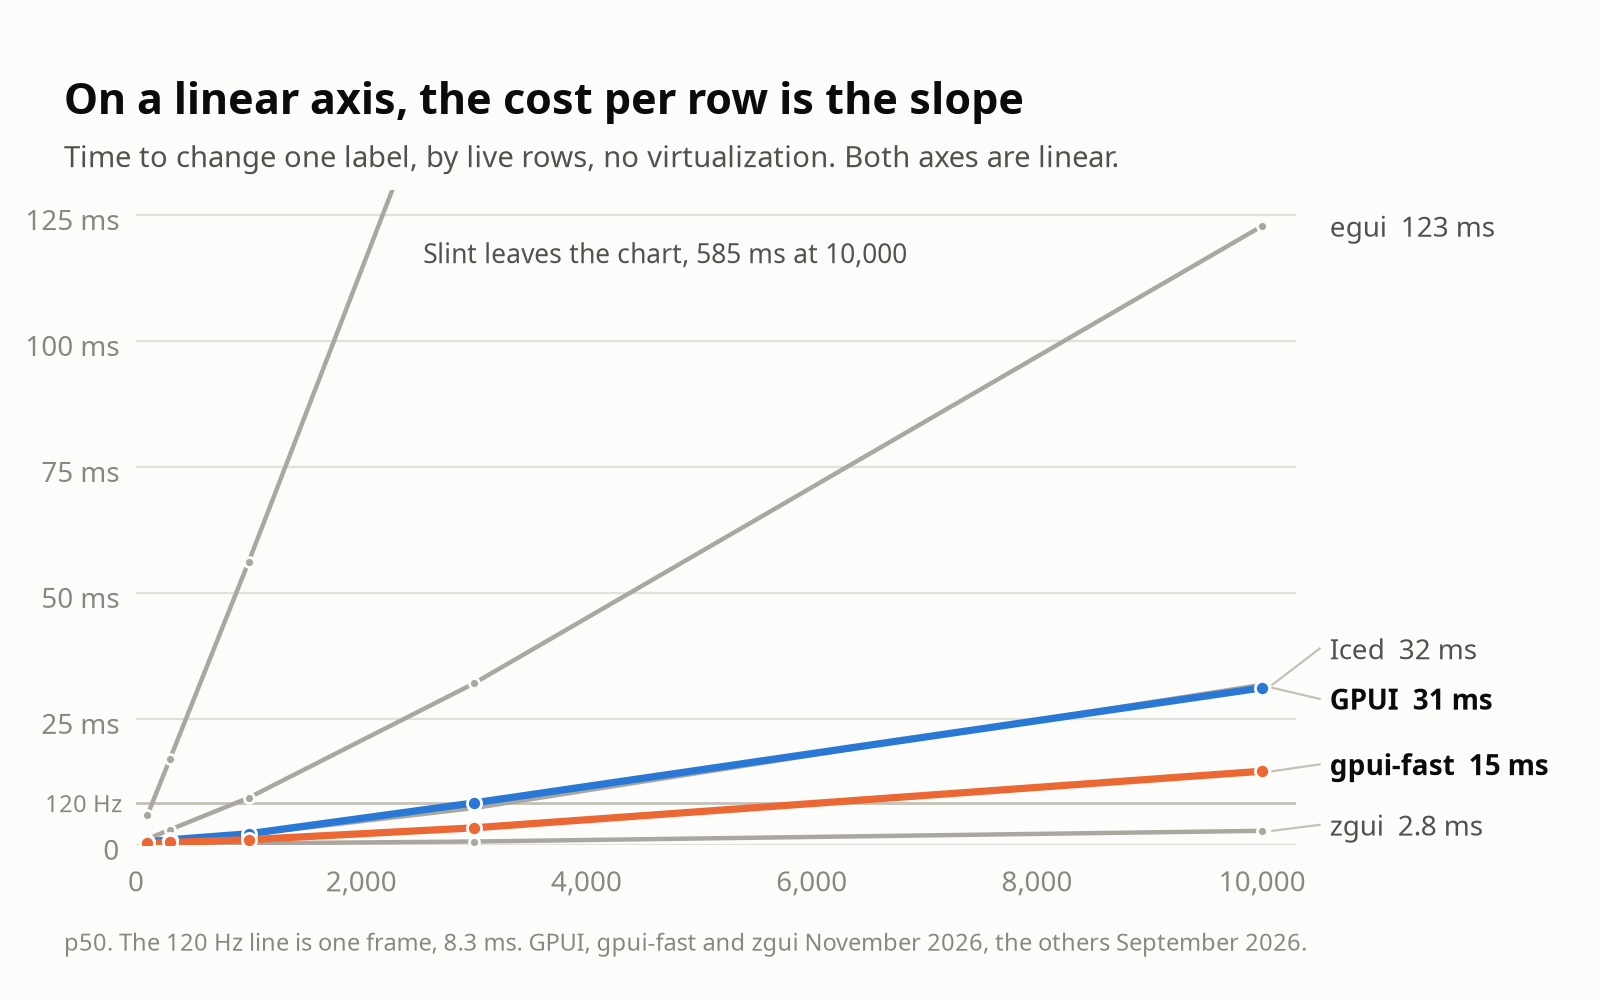 Figura: Crecimiento lineal del tiempo de fotograma frente a las filas activas en GPUI. Nótese que, aun con caché por fila, el coste escala linealmente con el tamaño del árbol. Fuente: blog.zortax.de
Si el desarrollador implementa manualmente guardas de igualdad en cada celda, el tiempo por fotograma se reduce drásticamente de 7,9 milisegundos a 0,9 microsegundos. Este abismo de rendimiento evidencia la limitación intrínseca de las vistas puramente funcionales. Obligar al programador a escribir comprobaciones de igualdad para cada nodo traiciona la promesa de un framework declarativo. Al carecer de un mecanismo de seguimiento fino, el sistema no tiene otra alternativa que descender de arriba abajo desde la raíz para cotejar el árbol ante cualquier mutación.
El desacoplamiento entre la granularidad de la actualización de datos y el redibujado de la vista es el gran dilema del modelo puramente funcional. Bajo el paradigma render(state), el framework sabe que el estado ha cambiado, pero ignora quién lo está leyendo. Para garantizar la consistencia, el pipeline de renderizado está obligado a inspeccionar cada nodo. Lo que se ahorra en declaraciones de dependencias al picar código, se paga en cada fotograma como ciclos de CPU dedicados a la inspección.
El almacenamiento en caché no logra eliminar el coste del recorrido completo
Para combatir el coste de las comprobaciones globales, el equipo de Zed introdujo un mecanismo de caché por retención en la rama experimental gpui-fast. En la misma prueba con 3.000 filas, el tiempo de actualización de una sola etiqueta cayó de 8,4 a 3,4 milisegundos. Aunque supone una reducción del 60 %, en ese fotograma solo se redibujaron en realidad 3 vistas y se recalculó la disposición de 1 elemento. Emplear 3,4 milisegundos en posicionar un único elemento demuestra que gran parte del cálculo se sigue perdiendo en recorrer el árbol de componentes.
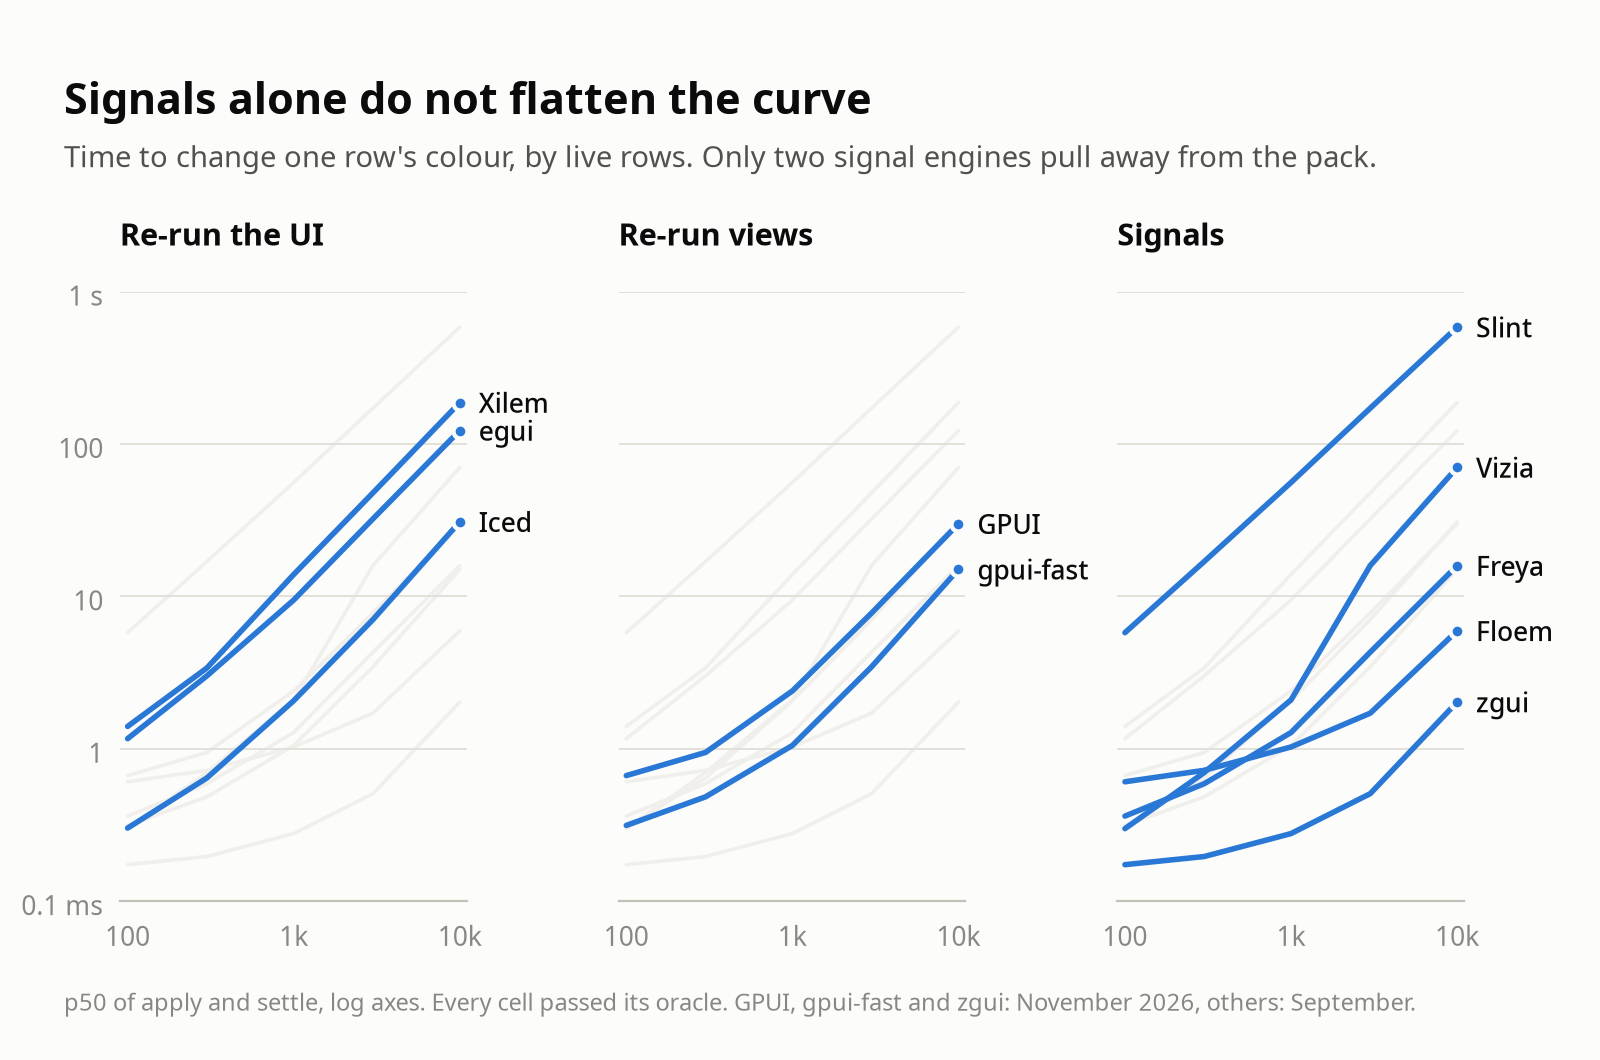 Figura: Tiempos de ejecución según la propiedad del estado y la estrategia de retención. Obsérvese la penalización de la retención bajo un modelo compartido. Fuente: blog.zortax.de
Al trasladar la prueba a una interfaz multipanel con 60 paneles, la estrategia de caché tropieza con nuevos obstáculos. Cuando el estado pertenece de manera aislada a cada panel, la caché ahorra un 83 % del tiempo en mutaciones individuales. Sin embargo, al unificar los datos en un modelo global compartido, la caché hace que el renderizado sea un 11 % más lento. Cuando múltiples paneles acceden al estado compartido simultáneamente, las comprobaciones de invalidación y las comparaciones de hashes devoran las ventajas de reutilizar vistas.
Las mediciones oficiales de Zed reflejan que la retención introduce una ligera pérdida de rendimiento del 1 % al 3 % en cargas de trabajo cotidianas. Los desarrolladores admiten abiertamente que las ganancias en escenarios reales proceden de otras optimizaciones en el pipeline. Los microbenchmarks rara vez se trasladan de forma directa a aplicaciones reales. La caché de vistas gruesa no sustituye a un grafo de dependencias exacto; comprobar la propia caché consume valiosos ciclos de CPU.
Otros frameworks en Rust sufren el mismo dilema de reconstrucción total
El recorrido completo del árbol no es exclusivo de GPUI. Iced, basado en la Arquitectura Elm, choca contra la misma pared. En la prueba idéntica de 3.000 filas, modificar una sola etiqueta hace que Iced reasigne 39.023 componentes en un solo fotograma, consumiendo 7,3 milisegundos. Incluso envolviendo cada fila en un contenedor lazy, el tiempo solo baja a 5,7 milisegundos, ya que calcular los hashes de las claves en todo el árbol sigue siendo obligatorio.
Los ejemplos oficiales de Iced sugieren usar un contador incremental version: u8 para indicar qué datos han cambiado. En el fondo, esto no es más que un dirty flag con otro nombre: un retroceso a la sincronización manual del estado. Además, la reconstrucción total infla la arquitectura de mensajes en proyectos complejos. Por ejemplo, cosmic-files define 136 variantes de mensajes principales y 73 variantes de pestañas, dispersando la lógica de sincronización en decenas de ramas de pattern matching.
El compilador asegura que el pattern matching sea exhaustivo, pero no puede verificar la coherencia de los datos entre distintas ramas. No obstante, con virtualización del viewport, Iced comprime el tiempo de fotograma a 0,19 milisegundos, situándose en la cima del rendimiento. Cuando los elementos activos en pantalla están acotados físicamente, el coste de la reconstrucción total es absorbido por el hardware moderno. La tensión estructural de los modelos puramente funcionales estalla sobre todo ante flujos masivos de datos sin virtualizar.
La web converge hacia Signals para el seguimiento de grano fino
Ante el coste de recorrer el árbol al completo, el ecosistema frontend web ha convergido de forma decidida hacia el modelo de señales (Signals). De Angular y Vue a Solid, los frameworks contemporáneos han adoptado la ejecución basada en grafos reactivos. El equipo de Svelte abrazó las señales en sus últimas versiones, admitiendo con franqueza que «al final, Knockout siempre tuvo la razón».
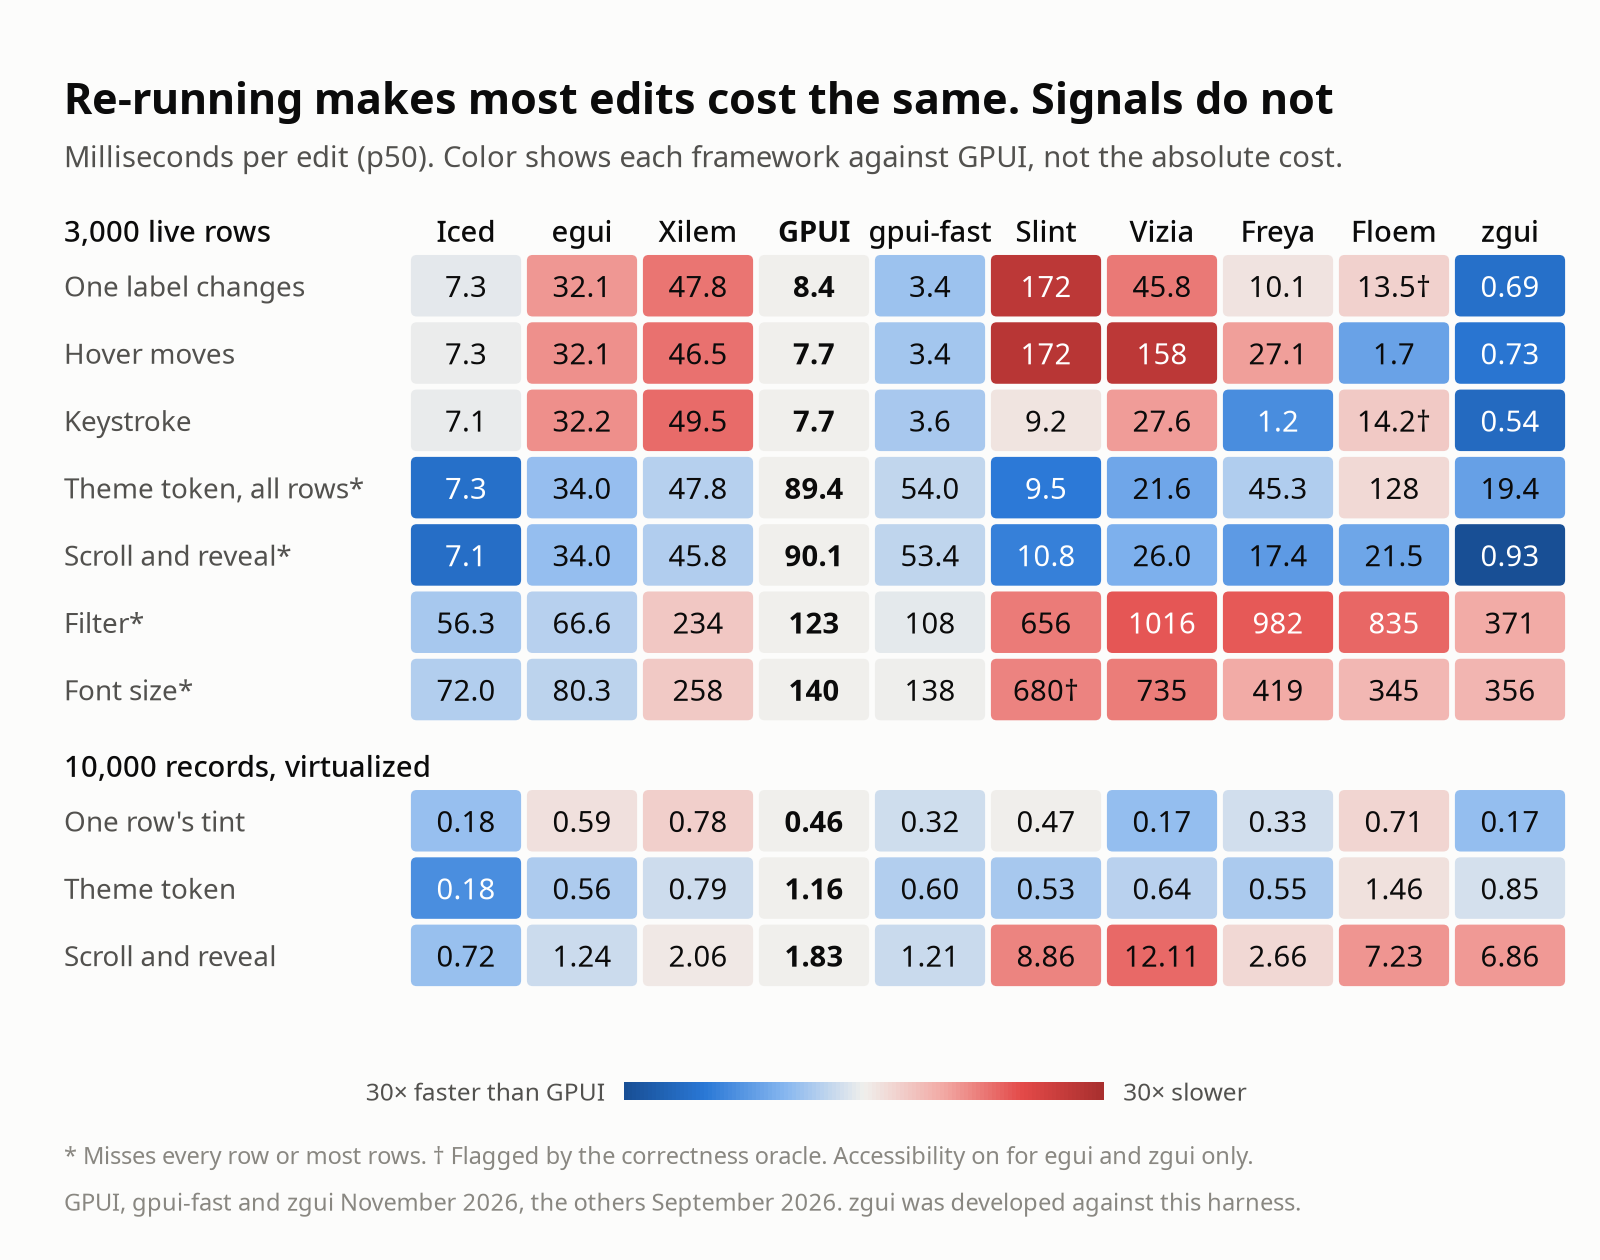 Figura: Comparación entre cinco modelos de estado para escritorio y frontend. Obsérvese cómo el modelo de señales a la derecha se ejecuta una sola vez y actualiza directamente closures locales. Fuente: blog.zortax.de
Los primeros compases de Redux mostraron una evolución similar. Tratar el estado como una base de datos global provocaba que cada acción recalculase todos los selectores. Ese cuello de botella forzó la transición hacia modelos atómicos de grano fino. React, que insiste en rerenderizar el árbol de componentes completo, ha quedado como una excepción aferrada a las funciones puras.
El ecosistema de escritorio en Rust está explorando caminos similares. El framework Vizia migró en marzo de 2026 de un modelo de lentes a un sistema de señales, conservando la gestión centralizada pero añadiendo reactividad local. Proyectos como Floem o zgui reducen la función de renderizado a un constructor topológico de un solo uso. Los nodos hoja capturan señales mediante closures y modifican el estado de forma directa en el nodo cuando este cambia, puenteando por completo la jerarquía del árbol de vistas.
Compromisos de ingeniería frente a dogmas absolutos
Las métricas del benchmark deben interpretarse dentro de su contexto de ingeniería. El autor del test, zortax, desarrolla actualmente el framework zgui guiado por señales y realizó la adaptación de GPUI a wgpu. Su prueba está diseñada para listas largas sin virtualización, el caso extremo más desfavorable para las vistas puramente funcionales.
La comunidad técnica ha debatido ampliamente estos resultados. Varios ingenieros recuerdan que el software de CAD, el dibujo vectorial y las aplicaciones de audio llevan décadas funcionando de forma impecable bajo el modo inmediato (immediate mode). El modo inmediato y las vistas puramente funcionales simplifican al máximo la gestión del ciclo de vida y evitan el coste en closures y memoria que imponen los grafos de dependencias reactivos.
El análisis de GPUI abarca también la eficiencia energética. Diversos desarrolladores señalan un consumo de energía relativamente elevado en reposo, impulsando alternativas como sidestep. Por contra, egui demuestra cómo una abstracción mínima y soporte para WebAssembly permiten ejecutar herramientas de escritorio complejas de forma liviana dentro del navegador. Cada arquitectura traza su frontera entre el rendimiento bruto y la sobrecarga cognitiva del desarrollador.
En el desarrollo de interfaces no existen abstracciones gratuitas. La capacidad expresiva del modelo de estado define el techo de rendimiento del sistema. Definir las vistas como funciones puras sin un grafo de dependencias convierte el recorrido completo del árbol en un peaje ineludible. Lo que el programador ahorra al no declarar dependencias en el código, se termina pagando con creces frente al implacable presupuesto de cada fotograma.
Enlaces de referencia:
- A Critique of GPUI
- Debate en Hacker News