Modifier un seul libellé au sein d’une liste de 3 000 lignes coûte à GPUI 8,4 millisecondes de rendu natif. Sur un écran cadencé à 120 Hz, le budget alloué à chaque image n’est que de 8,3 millisecondes. Une infime mise à jour textuelle suffit donc à consumer l’intégralité d’une trame. Si l’on recourt à des éléments bruts dépourvus de cache de vue, cette durée s’envole jusqu’à 92 millisecondes.
Les frameworks d’interface modernes modélisent volontiers la vue sous la forme d’une fonction pure de l’état afin d’offrir une API déclarative limpide. Si cette approche évite la synchronisation manuelle des nœuds, elle brise le maillon nécessaire à l’inférence de dépendances fines. Pour les frameworks de bureau, la compétition se déplace désormais sur la capacité de leur modèle d’état à exprimer un graphe de dépendances réactif. Sans suivi des dépendances de lecture, la moindre modification locale dégénère en un coûteux parcours exhaustif de l’arbre de composants.
Un libellé modifié en 8,4 ms : la vue purement fonctionnelle inspecte tout l’arbre
L’éditeur Zed a bâti sa renommée sur une vélocité native remarquable. Pourtant, les tests de charge sur de longues listes révèlent des goulets d’étranglement architecturaux. Un banc d’essai conçu par le développeur zortax simule une liste de 3 000 lignes dotées d’un cache de vue individuel. Modifier ne serait-ce qu’un seul libellé réclame 8,4 millisecondes de réconciliation à GPUI, un coût qui croît de manière strictement linéaire avec le nombre de lignes.
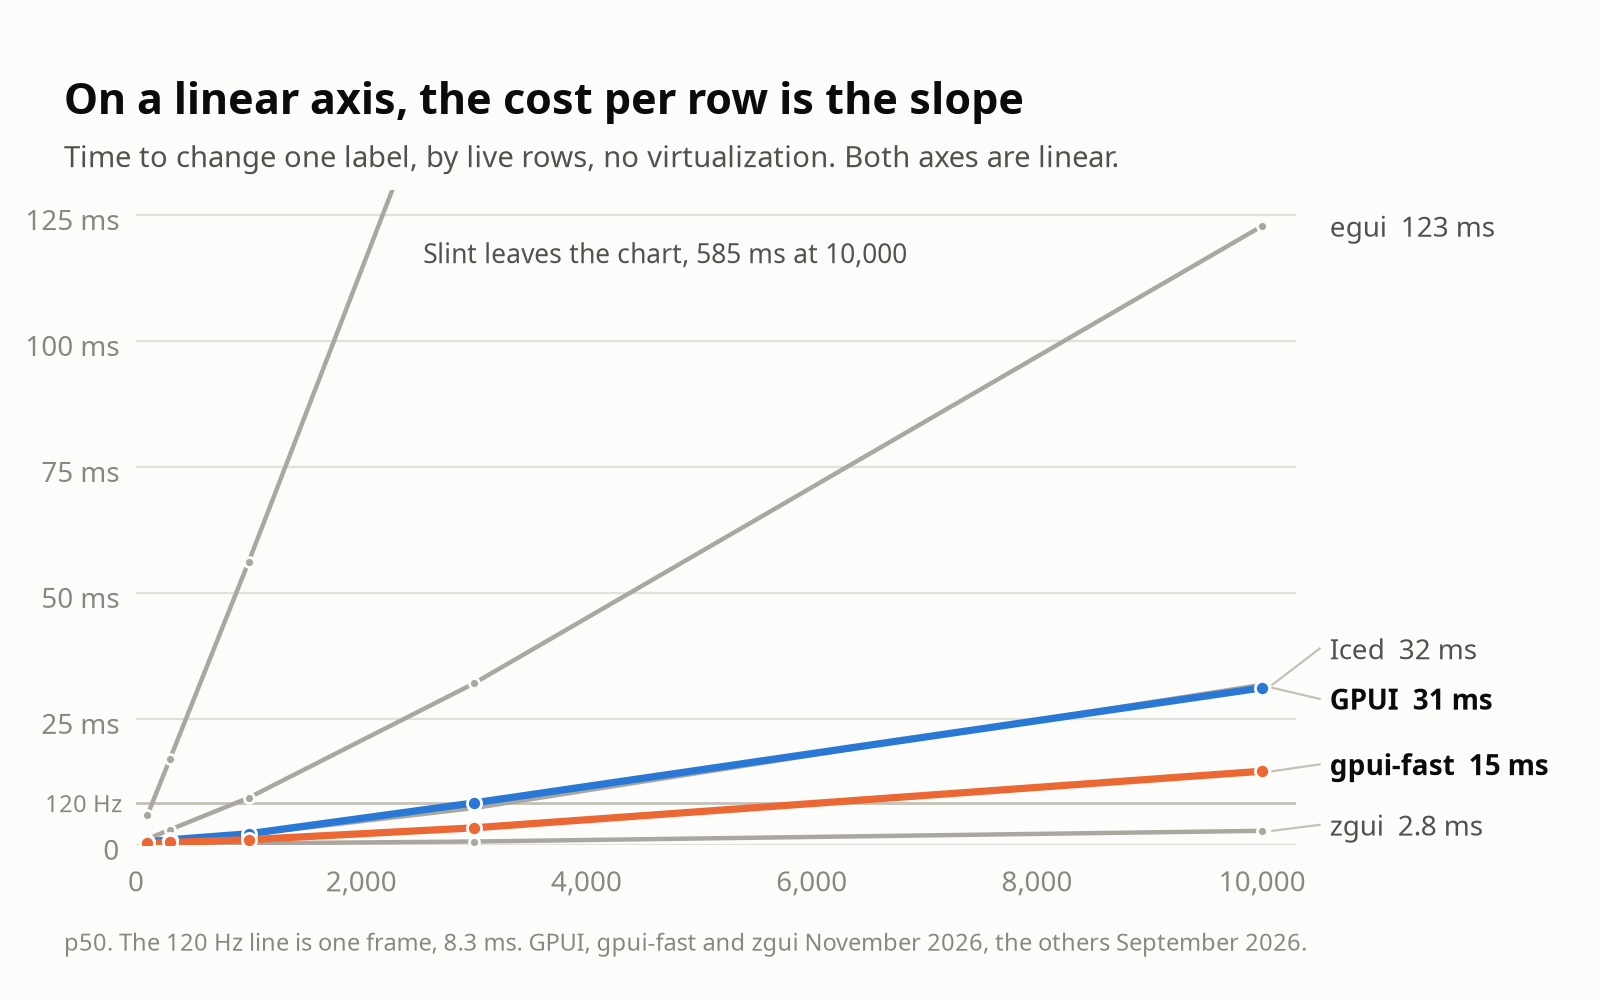 Figure : Relation linéaire entre lignes actives et durée d’une trame sous GPUI. Même avec un cache par ligne, le coût de mise à jour progresse linéairement avec la taille de l’arbre. Source : blog.zortax.de
Si le développeur prend soin d’écrire manuellement des gardes d’égalité sur chaque cellule, le temps d’exécution s’effondre de 7,9 millisecondes à 0,9 microseconde. Un tel écart met en évidence le piège inhérent aux vues purement fonctionnelles. Contraindre le développeur à implémenter des vérifications d’égalité à la main sur chaque nœud contredit la promesse même du déclaratif. Faute de suivi fin intégré au framework, le moteur n’a d’autre choix que de parcourir l’arbre de haut en bas depuis la racine à la moindre mutation d’état.
Le décalage entre la granularité des mises à jour de données et celle du rafraîchissement visuel constitue le nœud gordien du modèle fonctionnel. Sous le paradigme render(state), le framework sait que l’état a changé, mais ignore quels nœuds le consomment. Pour assurer la cohérence finale, le pipeline de rendu doit inspecter chaque élément. Ce que l’on économise en déclarations de dépendances lors de l’écriture du code se paie chaque trame en cycles processeur dédiés au parcours de l’arbre.
La mise en cache ne saurait éliminer le coût du parcours exhaustif
Afin d’atténuer la charge des vérifications globales, l’équipe de Zed a introduit un mécanisme de rétention (retention cache) au sein de la branche expérimentale gpui-fast. Sur la même liste de 3 000 lignes, le temps d’actualisation d’un libellé est ainsi passé de 8,4 millisecondes à 3,4 millisecondes. Bien qu’il s’agisse d’un gain de 60 %, seuls 3 composants ont été redessinés et 1 élément repositionné lors de cette trame. Consacrer 3,4 millisecondes à la disposition d’un unique élément prouve que l’essentiel de la puissance de calcul s’évapore toujours dans les chemins de ronde de l’arbre de composants.
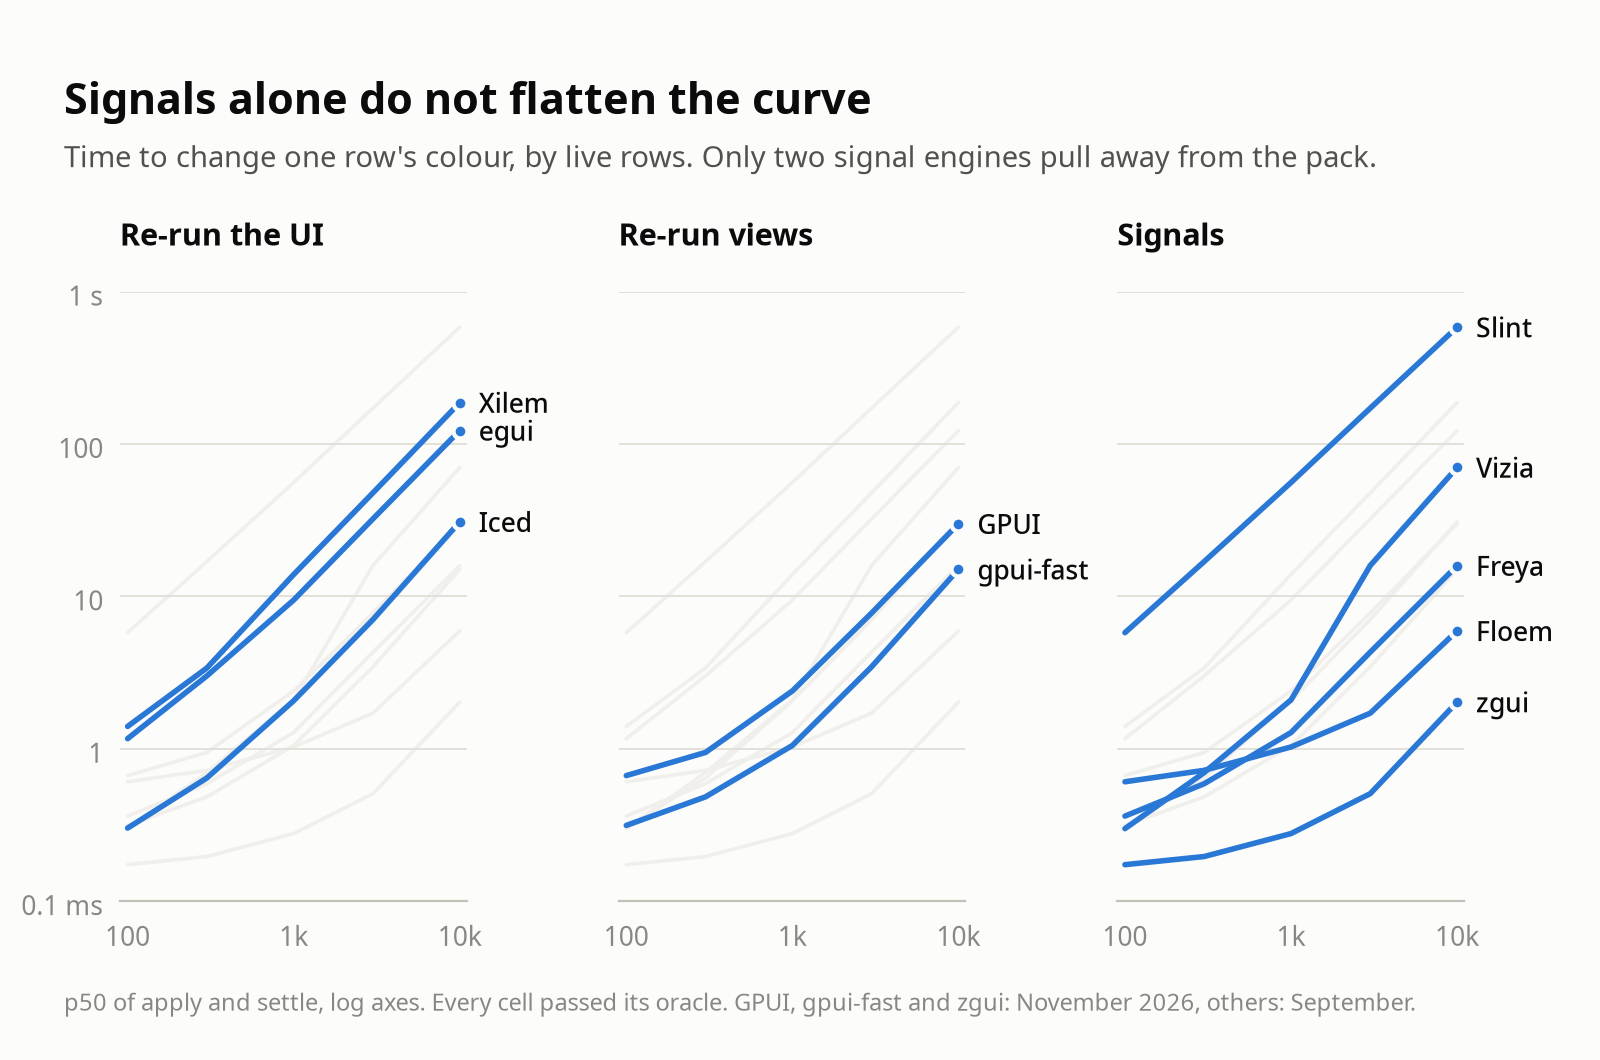 Figure : Temps d’exécution selon la possession de l’état et la stratégie de rétention. Remarquez la pénalité induite par la rétention sous un modèle d’état partagé. Source : blog.zortax.de
Lorsque l’on étend le scénario à une interface multi-volets comportant 60 panneaux, la stratégie de cache se heurte à de nouveaux écueils. Dès lors que l’état est géré localement par chaque panneau de façon étanche, le cache permet d’économiser 83 % du temps sur une modification isolée. En revanche, si les données sont mutualisées dans un modèle global partagé, le cache ralentit le rendu de 11 % pour la même trame. Lorsque plusieurs panneaux lisent simultanément un état partagé, le coût d’invalidation du cache et les comparaisons de hachages surpassent les bénéfices du réemploi des vues.
Les mesures officielles publiées par Zed confirment que la rétention induit une légère baisse de performance de 1 % à 3 % en charge de travail courante. Les développeurs admettent d’ailleurs volontiers que les gains réels observés sur l’application proviennent d’autres optimisations du pipeline. Les conclusions de microbenchmarks ne se transposent pas directement aux logiciels de production. Un cache de vue à gros grain ne remplace pas un graphe de dépendances exact, et vérifier le cache consomme lui-même de précieux cycles CPU.
Des frameworks frères confrontés au même dilemme de reconstruction intégrale
Le parcours exhaustif de l’arbre ne concerne pas uniquement GPUI. Iced, fondé sur l’architecture Elm, rencontre le même obstacle. Sur le même test de 3 000 lignes, la modification d’un libellé contraint Iced à réallouer 39 023 composants en une seule trame, engloutissant 7,3 millisecondes. Même en encapsulant chaque ligne dans un wrapper lazy, la durée ne descend qu’à 5,7 millisecondes, car le calcul des empreintes de hachage sur l’ensemble de l’arbre reste incontournable.
Les tutoriels officiels d’Iced préconisent d’incrémenter un compteur version: u8 pour signaler les données altérées. Dans les faits, cela s’apparente à réintroduire des dirty flags sous un autre nom, marquant un retour à la synchronisation manuelle. Le modèle de reconstruction intégrale fait également exploser la complexité du routage des messages dans les applications ambitieuses. À titre d’exemple, cosmic-files dénombre 136 variantes de messages racine et 73 variantes d’onglets, dispersant la logique de mise à jour au fil d’innombrables branches de filtrage par motif (pattern matching).
Le compilateur garantit l’exhaustivité du filtrage par motif, mais ne peut en aucun cas valider la cohérence logique de la maintenance des données d’une branche à l’autre. Cependant, dans un contexte de virtualisation de viewport, le temps de trame d’Iced tombe à 0,19 milliseconde, figurant parmi les solutions les plus rapides. Dès lors que les éléments actifs à l’écran sont physiquement circonscrits, le coût de la reconstruction intégrale est absorbé sans peine par le matériel. La tension inhérente aux modèles purement fonctionnels se manifeste avant tout face à des flux de données massifs non virtualisés.
Les frameworks web convergent unanimement vers les Signals
Devant le coût prohibitif du parcours d’arbre complet, l’écosystème web s’est converti en quelques années au modèle des signaux (Signals). D’Angular à Vue en passant par Solid, les frameworks modernes ont basculé vers une exécution articulée autour de graphes réactifs. L’équipe de Svelte a elle-même rallié les signaux dans ses versions récentes, observant avec lucidité que « Knockout avait vu juste depuis le début ».
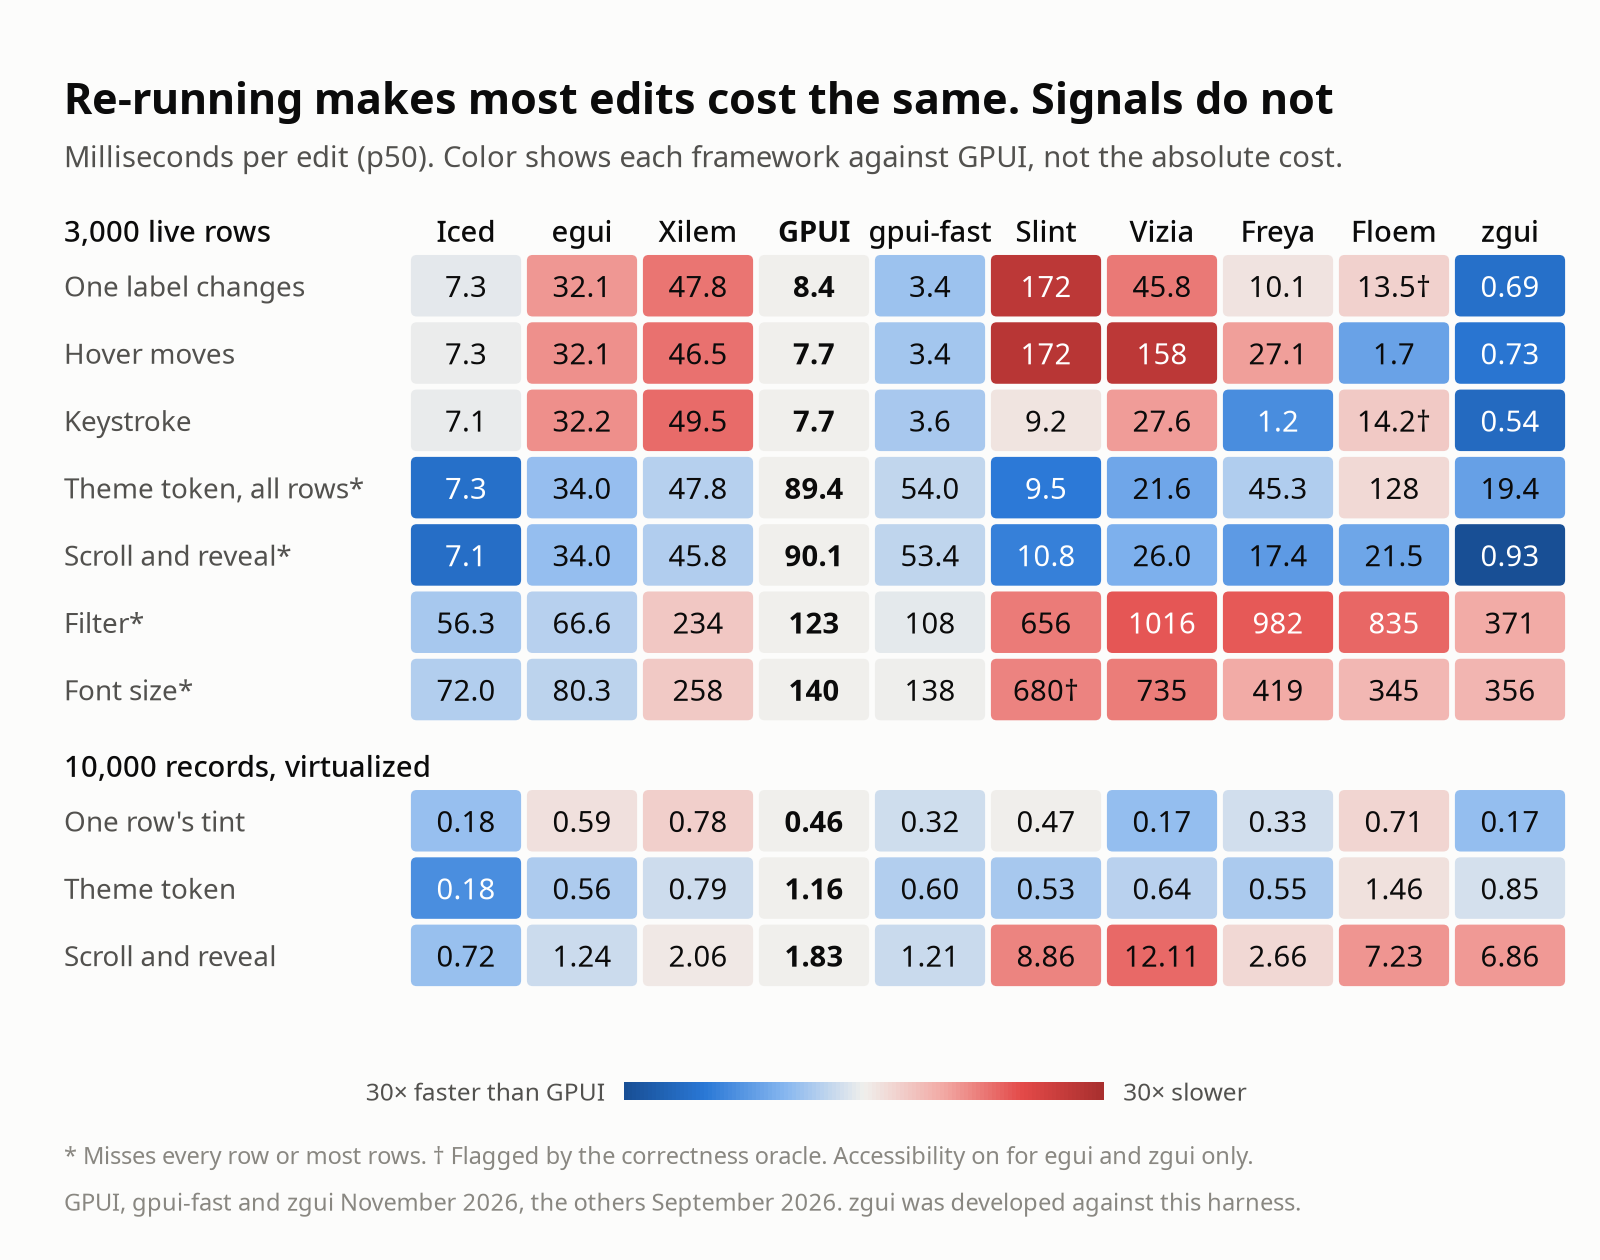 Figure : Confrontation de cinq grands modèles d’état pour desktop et web. Observez comment le modèle à signaux à exécution unique met directement à jour les fermetures locales. Source : blog.zortax.de
L’histoire de Redux à ses débuts reflète la même trajectoire. Lorsque l’état était perçu comme une base de données globale, chaque action déclenchait le recalcul de l’ensemble des sélecteurs. Cet étranglement a accéléré la transition vers des modèles atomiques fins. React, qui persiste à recalculer l’arbre complet de composants, fait désormais figure d’exception attachée aux fonctions pures.
L’écosystème Rust pour le bureau explore des voies comparables. Le framework Vizia a abandonné les lentilles en mars 2026 au profit d’une architecture à signaux, préservant une organisation centralisée tout en débloquant la réactivité locale. D’autres projets, comme Floem et zgui, relèguent la fonction de rendu au rang de constructeur de topologie exécuté une seule fois. Les nœuds terminaux capturent les signaux via des fermetures (closures) et appliquent directement les mutations sur place lors des changements d’état, court-circuitant ainsi l’ordonnancement hiérarchique de l’arbre de vues.
Des compromis d’ingénierie plutôt que des dogmes absolus
Les chiffres issus des bancs d’essai doivent être remis dans leur contexte technique. L’auteur des tests, zortax, développe lui-même zgui (un framework piloté par signaux) et a réalisé le portage wgpu de GPUI. Son banc d’essai évalue une liste longue sans virtualisation, ce qui représente le pire cas de figure possible pour des vues purement fonctionnelles.
La communauté technique a largement débattu de ces conclusions. De nombreux ingénieurs soulignent que les logiciels de CAO, le dessin vectoriel et les stations audio fonctionnent depuis des décennies avec une remarquable stabilité sur le principe du mode immédiat (immediate mode). Le mode immédiat et les vues fonctionnelles pures simplifient considérablement la gestion du cycle de vie des composants, tout en évitant la surcharge en mémoire et en fermetures inhérente aux graphes de dépendances réactifs.
Les débats autour de GPUI touchent également à l’efficacité énergétique du matériel. Plusieurs développeurs constatent une consommation électrique non négligeable à l’état de repos, incitant la communauté à explorer des pistes comme sidestep. À l’opposé, egui prouve qu’une abstraction minimale couplée au support de WebAssembly permet d’exécuter des outils de bureau complexes de façon très légère dans un simple navigateur. Chaque architecture négocie son propre équilibre entre rendement maximal et charge cognitive pour le développeur.
Il n’y a pas d’abstraction gratuite dans la conception d’interfaces. L’expressivité du modèle d’état définit le plafond de performance d’un système. Réduire le rendu à des fonctions pures sans graphe de dépendances fait du parcours d’arbre un tribut physique inévitable. Les déclarations de dépendances épargnées lors de l’écriture du code finissent inexorablement par être réclamées au détriment du budget de trame.
Liens de référence :
- A Critique of GPUI
- Discussion sur la communauté Hacker News