端到端响应 70ms,比前沿闭源模型快 193 倍,输出端计费为零。这是一个不生成任何文本的语言模型,在发布 48 小时内引发了至少 6 个第三方项目的代码复刻。
2026年9月15日,由前 OpenAI 研究员 Diogo Almeida 创立的 TypeSafe AI 发布了首个 System One 模型 Jev。Jev 摒弃了生成字符串再解析的旧接口,改为输入非结构化状态,输出类型安全的概率分布。Vercel 官方数据显示,Jev 成为其 AI Gateway 历史上被采用最快的模型。
跳出自回归生成黑盒
大语言模型最耗时且不可控的环节,是逐个 token 的自回归生成。工程界早就苦于文本解析的脆弱性,每次让模型输出特定格式的 JSON 都会面临格式破损或幻觉的风险。Jev 抛弃了自回归过程,转而并行输出全部备选答案的概率。
它的命名源于丹尼尔·卡尼曼《思考,快与慢》中的系统 1。这类直觉式的快速思考不需要长篇大论的推理,只需要在瞬间给出本能判断。Jev 把延迟压缩到了 70ms 至 500ms,让 AI 第一次能像普通函数一样,嵌进有严格延迟保证的软件工作流里。
因为类型安全的取值集合是事先定义的,开发者直接拿到合规的概率与置信度。官方宣称这种机制让类型错误在数学上不可能发生,架构层面也杜绝了传统意义上的文本幻觉。用空间换时间的概率输出,直接杀死了文本解析过程中的不确定性。
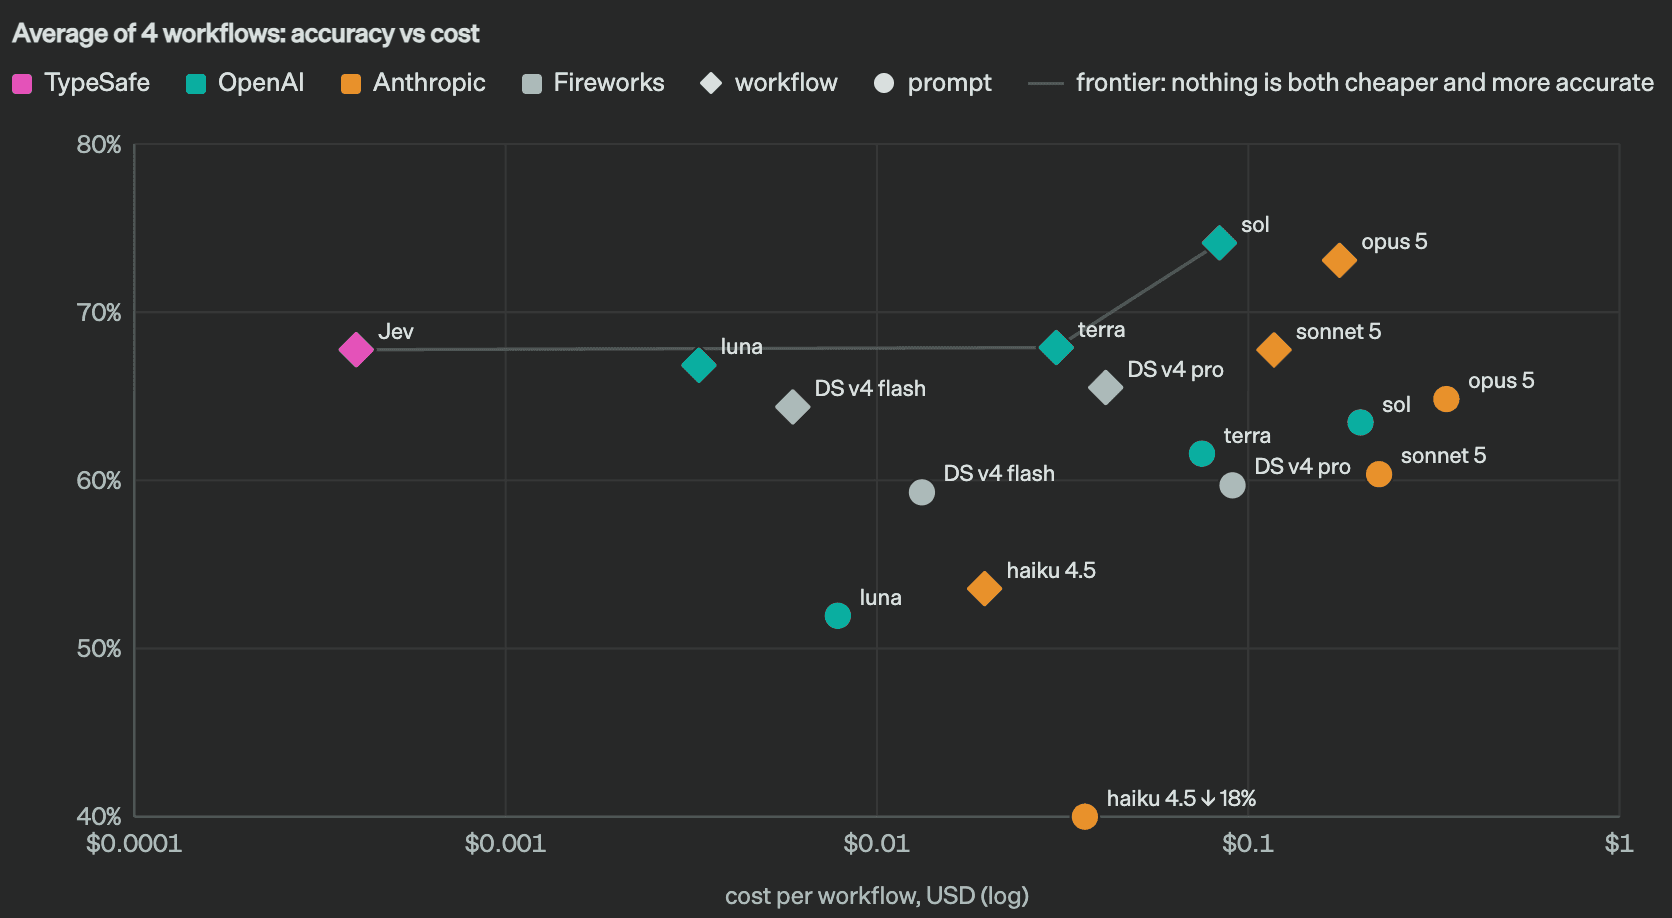 图:Jev 在两个数量级上占据 Pareto 前沿。来源:TypeSafe AI 官方博客
杰文斯悖论触发算力下沉
模型类名取自系统 1,而 Jev 这个名字则取自威廉·斯坦利·杰文斯。这暗指着著名的杰文斯悖论,智能判断的单价每下降一个数量级,跑通的商业用例就会多出一个数量级。
它的定价策略击穿了行业的底线。模型输入每 10 亿 token 仅收费 42 美元,而输出端因为不生成新 token 而计费为零。这种成本结构打破了过往依赖生成长度计费的商业模式,直接瞄准了海量数据清洗、实时流量分类和高频路由调度等长尾场景。
过去受限于算力成本而无法部署 AI 的边缘计算节点,现在有了铺设微型分类器的账面依据。降低单次判断的算力损耗,换来的是整个互联网流量路由的智能化改造。
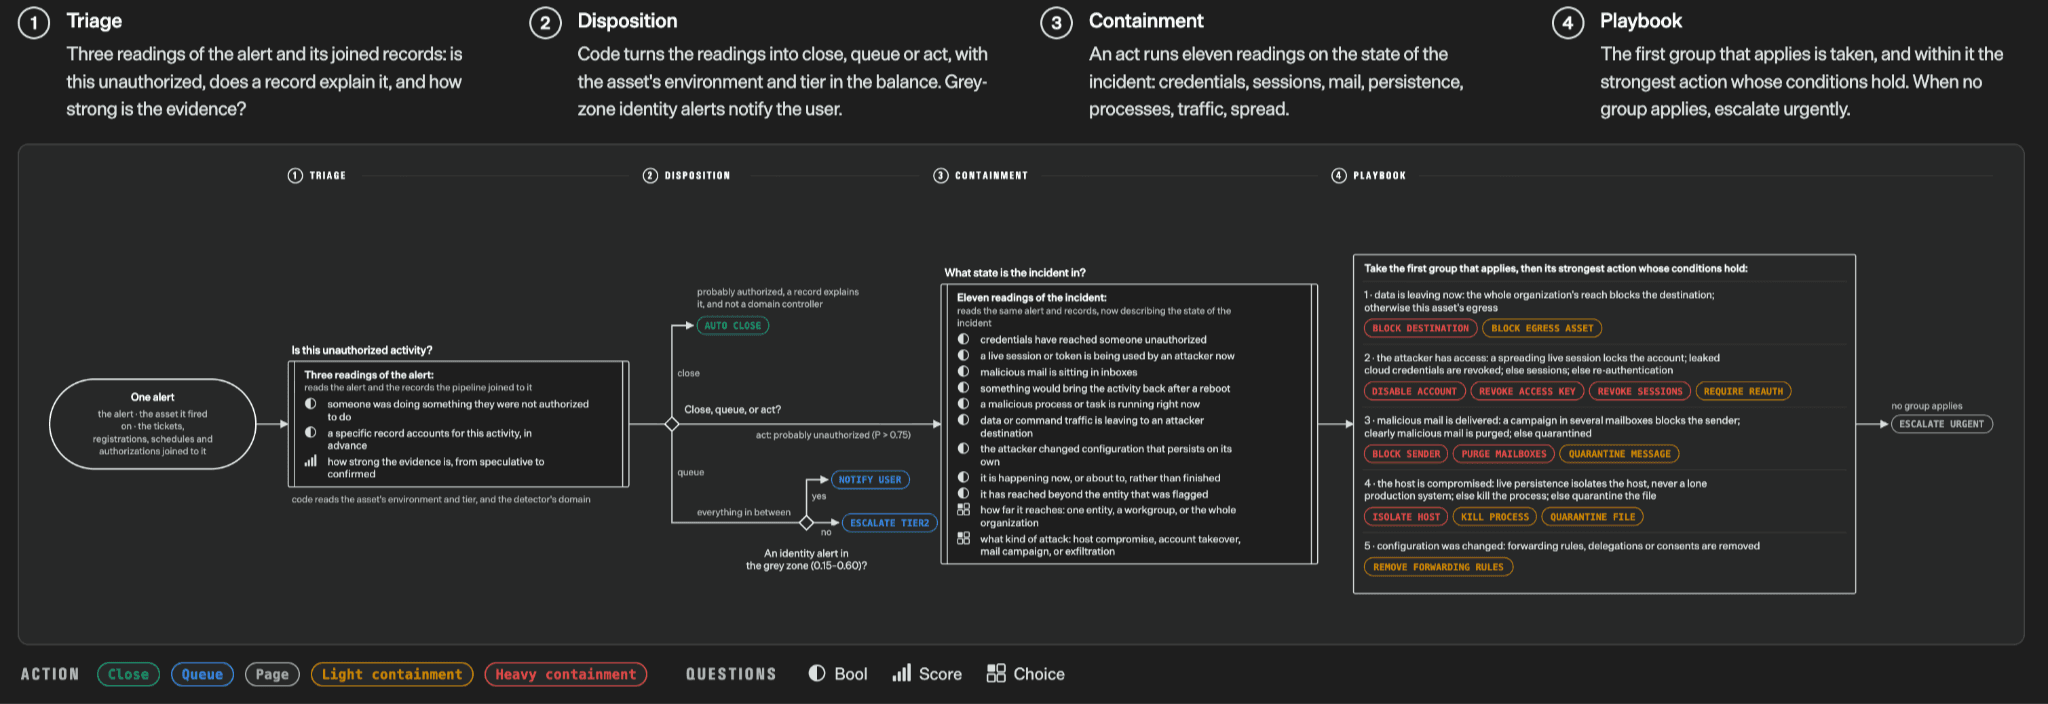 图:官方发布的最简 workflow 结构示意:把一次判断拆成多个独立问题。来源:TypeSafe AI 官方博客
二十五行代码扒下范式外衣
概念包装拉满了期待,但社区的技术解构来得更生猛。Hacker News 很快把 Jev 的架构扒得一干二净。发布当天有三篇帖子冲上首页,其中《Jev in 25 Lines of Python》拿下 197 分,《Will OpenAI Eat Jev’s Lunch》拿到 296 分,针对它的 JevBench 基准测试也获得了 111 分。
Latent Space 的统计显示,早期克隆项目在 48 小时内涌现了 6 个。这些项目包括 openjev.com、ekzhang 开发的 openjev-sglang 以及 OpenJev on DiffusionGemma。开发者 NobodyWho 用一个 Qwen3-0.6B 的 GGUF 模型搭配 llama.cpp 的 logits_all 接口,仅用 25 行 Python 代码就写出了对应的开源实现。
他们提取标签 token 的单步 logits 做对数归一化,直接让开源模型输出分类概率。在这个测试样例中,模型精准给出了 Legitimate 0.031、Spam 0.084、Phishing 0.885 的概率分布。单步分类架构在代码层毫无秘密,普通的本地模型足以做到高频响应且数据不出机器。
概率校准挡住开源克隆
Arcturus Labs 的深度分析点出了最关键的技术现实。OpenAI 从 tool calling 时代起就在把单个 token 当微型分类器用。无论是判断是否调用工具、调用哪个工具,还是用特定标记判断是否结束对话,基础机制同源。
Jev 在模型架构上没有秘密,TypeSafe 真正的技术壁垒在于 RLCD 训练流程。传统的 RLHF 优化的是人类偏好,RLVR 优化的是可验证奖励,而 RLCD 专门用来优化校准过的决策概率。
单步分类的调用代码人人都能写,但把海量数据的输出概率稳住在正确区间,需要巨大的工程积淀。Jev 的核心做法是对单步 logprobs 的再加工,模型输出的概率在分布外输入时偶尔会偏离真相。没有 RLCD 在后方的支撑,简单的概率输出很容易在复杂对话中退化为随机数。
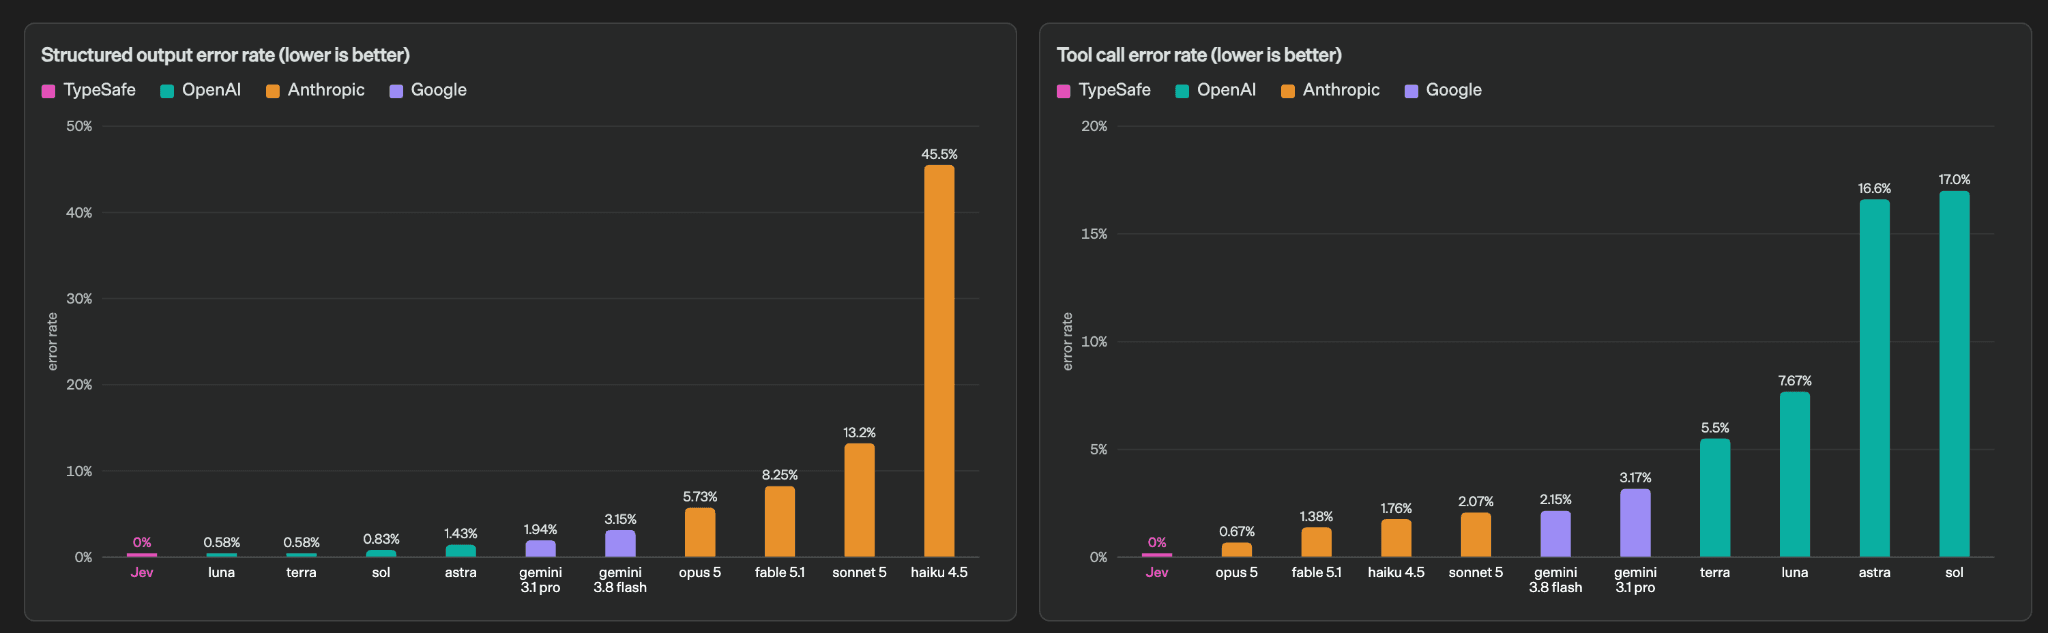 图:官方幻觉率与类型安全对比图。来源:TypeSafe AI 官方博客
赢家留在数据壁垒里
围绕技术壁垒的分歧在社区发酵。支持方看重 100ms 级别延迟解锁的实时应用与海量 map-reduce 场景,认为 AI 终于以函数的形态落地。质疑方则指出单步分类技术在 2025 年就已出现,Jev 宣称的零类型错误率掩盖不了模型判断出错的业务风险。
创始人 Diogo Almeida 曾在 OpenAI 参与让模型遵循指令的研究,这套经验被平移到了概率校准上。面对外界的连番质疑,Diogo 的回应非常直接,他表示只要模型质量依然重要,他们就会在很长一段时间里占据优势位置。
单步分类架构在 48 小时内被迅速解构,打破了范式创新能构筑高墙的错觉。前沿竞争的核心已经转移,一旦模型不再把算力浪费在生成无意义文本上,真正的较量就落回到了海量数据里的概率校准工程上。
参考链接:
- Introducing System One Models and Jev
- Jev in 25 Lines of Python
- Will OpenAI Eat Jev’s Lunch?
- Hacker News: Jev in 25 Lines of Python