跑分狂飙近一半,主频却卡在 5GHz 附近原地踏步
2016 分,2426 分,2969 分,这是在 Geekbench 6 测试平台上,连续三代 AMD 桌面处理器单核跑分留下的切片。如果仔细对比 Ryzen 7 5800X3D 到 9800X3D 的成绩单,你会发现一个违背直觉的现象。在 2022 到 2024 这短短两年的时间窗口里,同一条产品线的单核性能跃升了百分之四十七,多核性能更是涨了百分之五十八。
面对如此巨大的性能跨度,按照过去的行业经验,必然伴随着时钟频率的大幅拉升。但查阅规格表后,数据却走向了另一个方向。从 Zen 3 架构到 Zen 5 架构,最大加速频率仅仅从 4.5GHz 爬升到了 5.2GHz,基准频率也只从 3.4GHz 提到了 4.7GHz。
百分之十五的频率涨幅,显然填补不了近一半的性能缺口。主频被牢牢锁死在 5GHz 门外,是因为芯片散热和漏电控制已经触碰到了物理红线。当运行频率越过 5GHz,为了维持信号稳定所需的电压会呈非线性上升,微观尺度下的漏电流和发热量足以让硅片陷入过热降频的死循环。
这组对比数据撕破了旧时代的叙事逻辑:单核性能的增长已经不再依赖于更高的时钟频率。 既然芯片流水线的运转速度无法继续加快,工程师唯一的解法就是把整条生产线拆掉重建,将其拓宽到前所未有的规模。
把指令车道修宽,单核塞进五十亿个新晶体管
当纵向的频率红利消耗殆尽,横向拓宽架构成为了维持算力增长的唯一出路。从 Zen 3 到 Zen 5,每一颗处理器的晶体管预算都在持续膨胀。芯片的总晶体管数量从约一百一十亿颗激增至一百六十亿颗,硬是砸出了百分之五十的规模增量。
这些多出来的五十亿个晶体管避开了单纯堆叠缓存的老路,实打实地砸进了核心的计算逻辑中。在微架构的指令抓取和解码前端,最直观的改变是指令发射宽度的提升。Zen 3 架构每个时钟周期最多只能向后端发射六条指令,而到了 Zen 5,这个数据被拉高到了八条。
将解码宽度从六提升到八,并非多接几条数据线那么简单。x86 指令集的长度是可变的,解码器必须在不知道上一条指令在哪里结束的情况下,同时预测和分割连续的八条指令。这种庞大的预测电路,本身就会吃掉可观的晶体管面积。
后端的整数运算单元数量同样迎来了扩建。此前的架构中,四个整数算术逻辑单元承担了主要的计算任务,如今这个规模被增加到了六个。这代表在同一个时钟周期内,芯片可以同时处理更多的基础运算,整体执行管线的吞吐能力自然水涨船高。
 图:一块 AMD Ryzen 处理器与配套主板。来源:Wikimedia Commons,CC0
吞下四百条乱序指令,调度器视野扩张一倍
拥有更宽的执行通道只是第一步,真正的工程挑战在于如何确保这些新增的通道不会陷入空转。现代处理器全部依赖乱序执行机制,它们会提前拆解后方的代码,寻找没有互相依赖关系的任务并提前计算。这种预判未来的能力,直接决定了多出来的整数单元是在全力输出,还是在白白耗电。
决定这层预判视野范围的核心部件,是名为重排序缓冲区的硬件结构。在 Zen 3 时代,这个缓冲区只能容纳两百五十六条指令。当代码逻辑稍微复杂,或者遇到长延迟的内存读取时,调度器就会因为视野受限而找不到足够多的独立任务,导致执行单元被迫闲置停工。
到了 Zen 5,重排序缓冲区的容量被一口气扩充到了四百四十八项。这个庞大的结构允许处理器一次性吞下将近五百条处于飞行状态的指令,并在其中进行复杂的依赖性分析。调度器终于有了充足的周旋余地,能够从庞杂的代码流中翻拣出可以并行处理的计算任务。
当指令窗口大到这种程度,每一次遇到缓存未命中、需要去主存读取数据而耗费上百个时钟周期时,芯片就不会干等。调度器能从这四百多项的候选池里找到大量不依赖该数据的其他任务,把这些空白的等待时间全部填满。
| 处理器代号 | 架构 | 发布年份 | 单核得分 | 最大加速频率 | 整数计算单元数量 | 缓冲区容量 |
|---|---|---|---|---|---|---|
| Ryzen 7 5800X3D | Zen 3 | 2022 | 2016 分 | 4.5 GHz | 4 个 | 256 项 |
| Ryzen 7 7800X3D | Zen 4 | 2023 | 2426 分 | 5.0 GHz | 4 个 | 320 项 |
| Ryzen 7 9800X3D | Zen 5 | 2024 | 2969 分 | 5.2 GHz | 6 个 | 448 项 |
数据通道翻倍,让运算单元永远不用停下等数据
计算能力和调度窗口的膨胀,必然会对存储子系统提出异常苛刻的要求。如果数据搬运的速度跟不上指令消耗的速度,再宽的执行单元也会陷入无尽的饥饿状态。因此,扩大各级缓存并拓宽内部数据总线,就成了配合前端算力的必须动作。
最核心的 L1 数据缓存从三十二千字节提升到了四十八千字节,而每核心独享的 L2 缓存更是直接从五百一十二千字节翻倍到了一兆字节。这些紧贴运算核心的高速存储器,确保了大部分热点数据都能在极短的时钟周期内被迅速提取,大幅降低了去主存捞取数据的频率。
在浮点和向量运算领域,数据通道的拓宽呈现出更加粗暴的特征。Zen 3 和 Zen 4 架构使用的是四个二百五十六位的运算单元,到了 Zen 5,AMD 直接换上了四个完整的五百一十二位运算核心。宽度的翻倍让一条指令就能同时处理十六个单精度浮点数,在处理科学计算或本地大模型推理任务时效率有着立竿见影的提升。
为了喂饱这头吞吐量翻倍的算力怪兽,访存通道也进行了同等规模的升级。新的架构允许每个时钟周期执行两次加载和一次存储操作。巨大的总线带宽配合翻倍的缓存容量,终于让数据供应的速度跟上了计算单元膨胀的步伐。
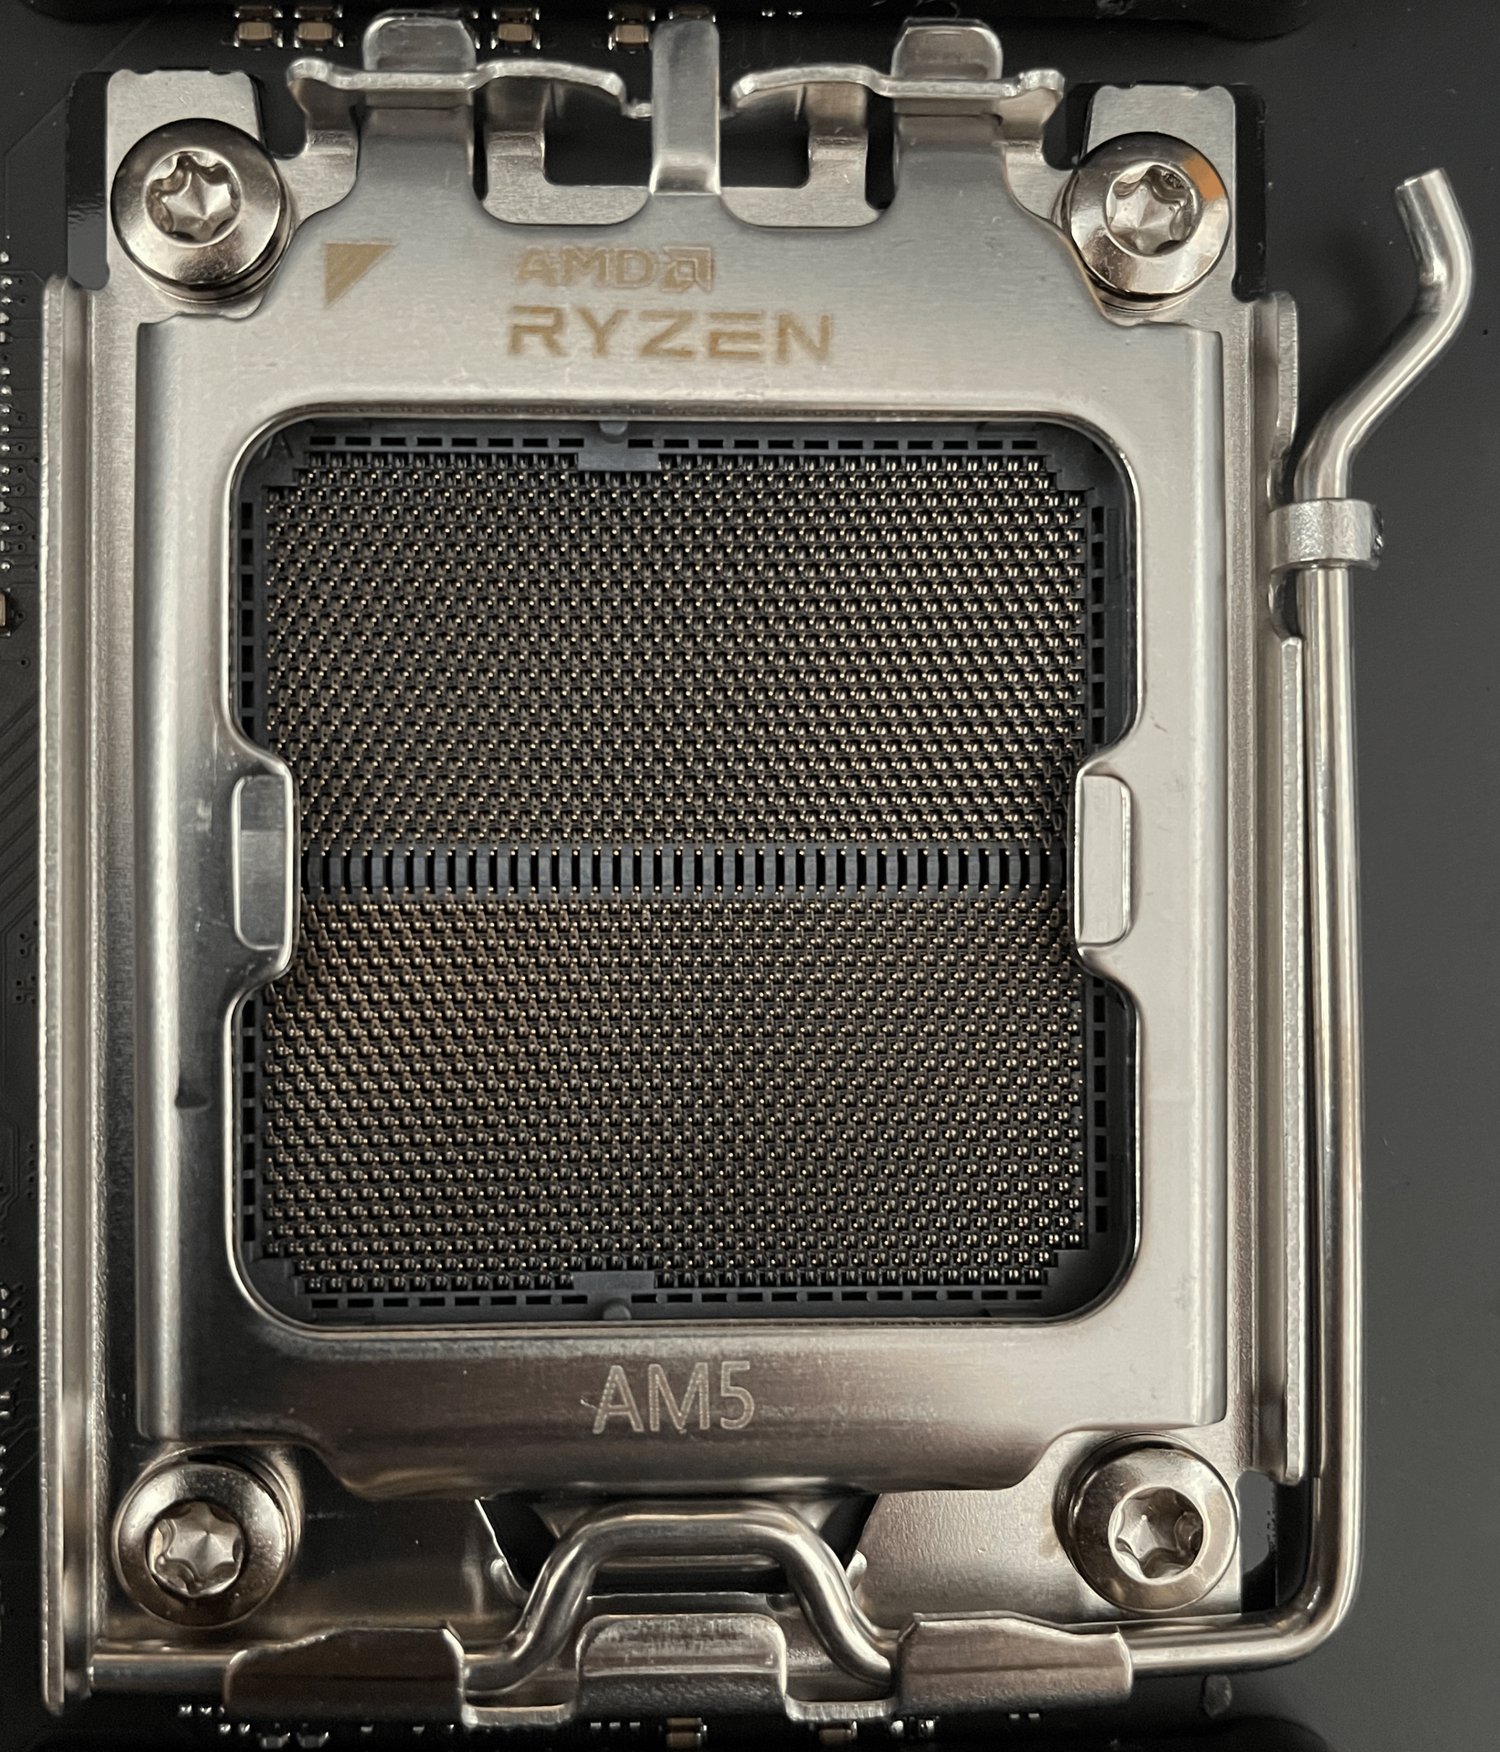 图:AMD AM5 处理器插槽。来源:Wikimedia Commons,CC BY-SA 4.0
用晶体管规模换取速度,发热的代价由谁来扛
依靠堆砌物理规模来获取性能的路线,带来的是实打实的物理成本。增加五十亿个晶体管,导致即使在不追求极限高频的情况下,芯片的静态漏电率和活跃功耗也会维持在一个居高不下的水平。微观层面的热密度正在急剧上升,传统的风冷散热器越来越难以压制这些瞬间爆发的热量。
芯片设计师实际上是将物理散热的巨大压力,连同高昂的制造面积成本一起转嫁给了主板供电和散热系统。更现实的问题在于,变宽的执行单元和庞大的指令窗口,只有在软件真正具备并行潜力时才能转化为跑分上的胜利。如果一段代码严格遵循串行逻辑,这些多出来的算力单元就只能是闲置且发热的硅片。
在这三年的时间里,英特尔与 AMD 的竞争一度陷入了堆积核心数量的拉锯战中,但单纯增加核心数并不能提升单线程任务的响应速度。AMD 选择在核心内部做文章,用微架构的强行拓宽来拉升单核上限,直接扭转了此前行业内一味增加核心数量的设计惯性。
芯片停滞的论调并不准确,它只是换了一条演进路径。当主频不再是衡量性能的唯一标尺时,单核计算的门槛实际上被更为庞大复杂的架构设计垫高了。根据目前的工程传闻,下一代基于 Zen 6 架构的服务器产品已经瞄准了二百五十六个核心和惊人的一吉字节 L3 缓存。在这条依靠堆砌晶体管和横向拓宽的路上,算力的增长依然会继续,但每一次性能跃升背后,都需要用户用更强悍的散热和更沉重的功耗账单来买单。
参考链接:
- How did AMD Ryzen get 50% faster in two years?
- HN 讨论 (item?id=49758709)