スコアは5割急伸もクロックは5GHz近辺で足踏み
2,016点、2,426点、2,969点。これはGeekbench 6のベンチマークプラットフォームにおいて、AMDのデスクトップ向けプロセッサが3世代にわたって刻んだシングルコアスコアの推移だ。Ryzen 7 5800X3Dから9800X3Dへの進化を精査すると、従来の直感に反する驚くべき現象に突き当たる。2022年から2024年というわずか2年の間に、同一ラインの製品でありながらシングルコア性能が47%向上し、マルチコア性能に至っては58%も跳ね上がっているのだ。
過去の半導体業界の常識に照らし合わせれば、これほど劇的な性能向上には動作クロックの大幅な引き上げが不可欠だったはずである。しかし仕様表を紐解くと、データは全く別の現実を示している。Zen 3アーキテクチャからZen 5アーキテクチャにかけて、最大ブーストクロックは4.5GHzから5.2GHzへとわずか15%の上昇にとどまり、ベースクロックも3.4GHzから4.7GHzへの引き上げにとどまった。
わずか15%のクロック上昇では、5割近い性能差を到底埋めることはできない。動作周波数が5GHz台前半で頭打ちになっているのは、半導体の放熱とリーク電流制御が物理的な限界線に達しているためだ。クロックが5GHzを超えると、信号の安定性を維持するために必要な電圧が指数関数的に増大する。微細化が進んだシリコンではリーク電流と熱密度が急増し、プロセッサはあっという間にサーマルスロットリングによる性能低下の悪循環へと陥ってしまう。
この対比データは、従来の開発神話が崩壊したことを告げている。シングルコア性能の伸びは、もはや高クロック化には依存していない。 パイプラインをこれ以上高速回転させられない以上、エンジニアに残された唯一の解法は、製造ラインそのものを根本から再設計し、かつてない規模へと「横に広げる」ことだった。
命令レーンを拡張:コア内部へ50億個の新トランジスタを投入
縦方向の周波数向上が限界を迎えたとき、アーキテクチャの水平方向への拡張こそが計算力を伸ばし続ける唯一の活路となった。Zen 3からZen 5にかけて、AMDはプロセッサ1基あたりのトランジスタ予算を一貫して拡大し続けた。チップ全体のトランジスタ総数は約110億個から約160億個へと急増し、実に50%もの規模拡大を成し遂げている。
追加された50億個ものトランジスタは、単に大容量キャッシュを積むという安易な道を選ばず、その大部分がコア内部の実行ロジックへと惜しみなく投入された。命令フェッチおよびデコードのフロントエンドにおいて最も顕著な変化は、ディスパッチ幅の拡大である。Zen 3アーキテクチャでは1クロックサイクルあたり最大6命令しかバックエンドへ供給できなかったが、Zen 5ではこれが8命令へと引き上げられた。
デコード幅を6から8へ拡大することは、単に配線を増やすような単純な話ではない。x86命令セットは可変長であるため、デコーダは「直前の命令がどこで終わるか」を事前に確定できない状態で、連続する8つの命令を同時に予測・分割しなければならない。この極めて巨大な予測回路自体が、膨大なシリコン面積とトランジスタを消費する。
バックエンドの整数演算ユニット数も同様に大幅拡張された。従来のアーキテクチャでは4基の整数算術論理演算ユニット(ALU)が主要な計算を担っていたが、Zen 5ではこれが6基へと増強された。同一クロックサイクル内でより多くの基本演算を並行処理できるようになり、パイプライン全体の実行スループットが大幅に底上げされたのである。
 図:AMD Ryzenプロセッサと対応マザーボード。出典:Wikimedia Commons, CC0
400命令超を飲み込む:スケジューラの視野を2倍近くへ拡大
実行パイプラインを広げることは第一歩に過ぎず、真の工学的挑戦は「増設した演算ユニットをいかに遊休させないか」にある。現代の高性能プロセッサは例外なくアウトオブオーダー(OoO)実行に依存しており、先々のコードをあらかじめ解析して依存関係のないタスクを見つけ出し、前倒しで計算を進める。この先読み能力の巧拙こそが、増設された整数ユニットをフル稼働させられるか、単に電力を浪費するだけになるかを左右する。
この先読みの視野範囲を決定づける中核コンポーネントが、リオーダーバッファ(ROB)と呼ばれるハードウェア構造だ。Zen 3世代のROB容量は256命令にとどまっていた。コードの分岐構造が複雑化したり、レイテンシの長いメモリアクセスが発生したりすると、スケジューラの視野狭窄によって十分な独立タスクが見つけられず、実行ユニットの待機(ストール)を招いていた。
これに対し、Zen 5ではリオーダーバッファの容量が一気に448エントリへと拡張された。この巨大な構造により、プロセッサは実行途中の命令を500件近く同時に保持し、その中で高度な依存関係解析を実行できるようになった。スケジューラは十分な探索余力を得て、複雑に入り組んだコードストリームから並行処理可能な計算タスクを確実に拾い出せるようになった。
命令ウィンドウがここまで拡大すると、キャッシュミスによってメインメモリからデータを読み出すために数百サイクルを要する場合でも、コアが手をこまねいて停止することはない。スケジューラは400件超の待機プールから当該データに依存しない別タスクを次々と見つけ出し、空き時間を演算処理で埋め尽くすことができる。
| プロセッサ型番 | アーキテクチャ | 発売年 | シングルコアスコア | 最大ブーストクロック | 整数演算ユニット数 | バッファ容量 |
|---|---|---|---|---|---|---|
| Ryzen 7 5800X3D | Zen 3 | 2022年 | 2,016点 | 4.5 GHz | 4基 | 256エントリ |
| Ryzen 7 7800X3D | Zen 4 | 2023年 | 2,426点 | 5.0 GHz | 4基 | 320エントリ |
| Ryzen 7 9800X3D | Zen 5 | 2024年 | 2,969点 | 5.2 GHz | 6基 | 448エントリ |
データ経路の倍増:演算ユニットを「データ待ち」にさせない仕組み
演算能力とスケジューリングウィンドウの拡張は、必然的にメモリサブシステムへ極めて厳しい要求を突きつける。データの搬送速度が命令の消費速度に追いつかなければ、いくら実行ユニットを広げても深刻なデータ飢餓に陥ってしまう。そのため、キャッシュ階層の増強と内部データバスの拡幅は、フロントエンドの処理能力向上に不可欠な連動施策となる。
コア直結のL1データキャッシュは32KBから48KBへと拡大され、各コア専用のL2キャッシュは512KBから1MBへと倍増した。演算コアに隣接するこれらの超低遅延メモリは、頻繁にアクセスされるホットデータの大部分を数サイクル以内で即座に取り出すことを可能にし、主記憶へアクセスしに行く頻度を劇的に引き下げている。
浮動小数点およびベクトル演算の領域では、データ経路の拡幅はさらに徹底している。Zen 3およびZen 4では4基の256ビットSIMD演算ユニットが用いられていたが、Zen 5においてAMDは4基すべてを完全な512ビット演算ユニットへと換装した。幅の倍増により、1命令で16個の単精度浮動小数点数を一挙に処理できるようになり、科学技術計算やローカルLLMの推論処理において即効性のある高速化をもたらしている。
スループットが倍増したこの演算モンスターを飢えさせないため、メモリアクセス経路も同等のスケールで強化された。新アーキテクチャでは1サイクルあたり2回の512ビットロードと1回の512ビットストアを並行実行できる。巨大なバス帯域と倍増したキャッシュ容量の組み合わせにより、データの供給速度が計算ユニットの拡大ペースについに追いついた。
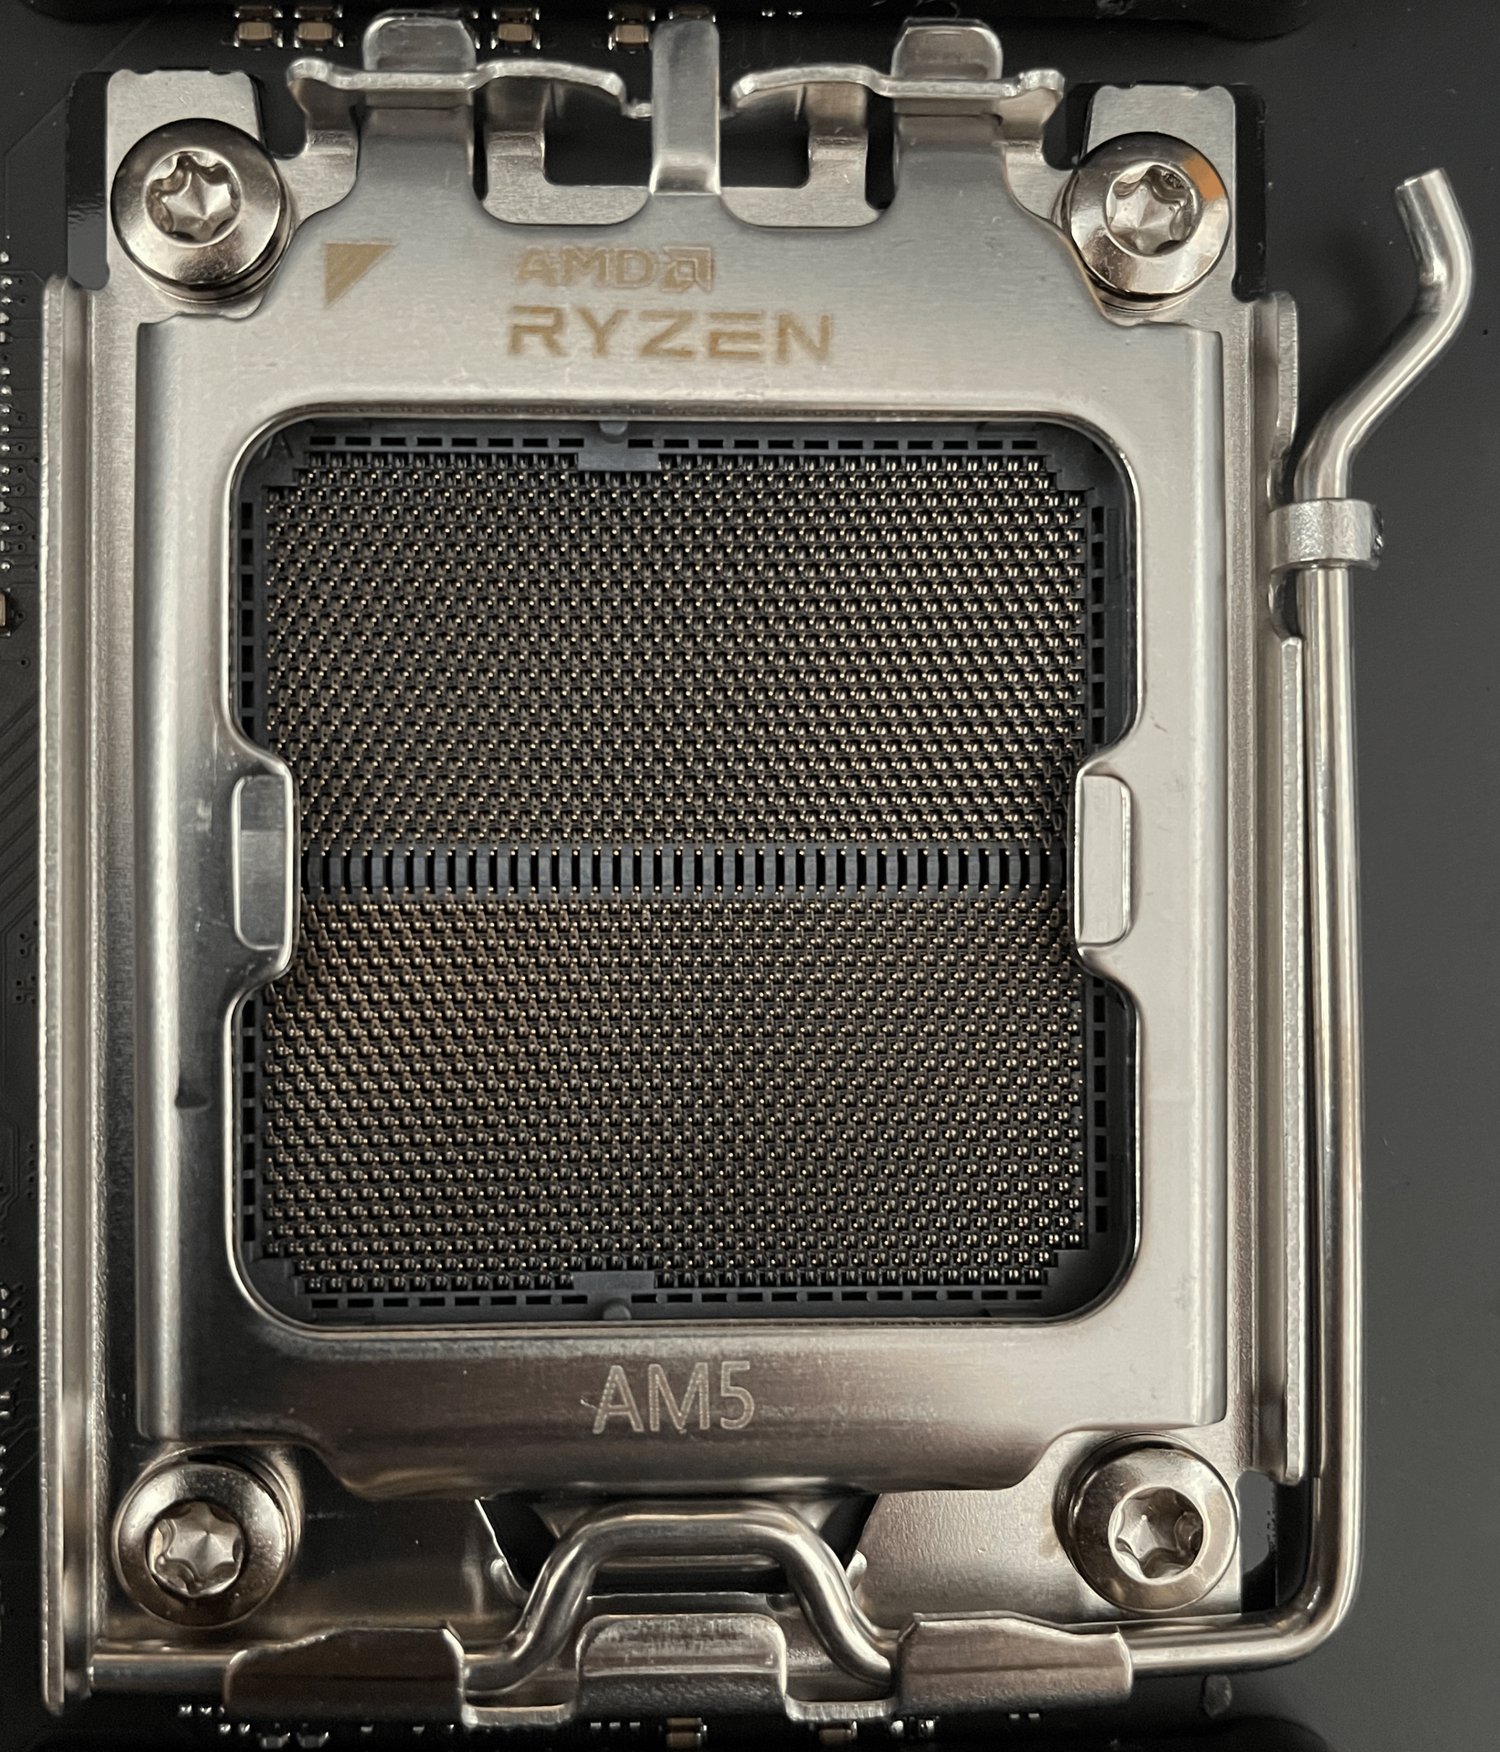 図:AMD AM5プロセッサソケット。出典:Wikimedia Commons, CC BY-SA 4.0
トランジスタ規模で稼ぐ速度:増大する発熱のツケは誰が払うのか
物理的な回路規模を積み上げることで性能を引き出すアプローチには、確実に物理的な代償が伴う。50億個のトランジスタ追加により、極端な高クロックを追求しなくとも、チップの静的リーク電力と動作時消費電力は高止まりを続ける。シリコンダイ上の局所的な熱密度は急激に上昇しており、従来の空冷クーラーでは瞬間的な急発熱を受け止めきれなくなりつつある。
チップ設計者は、熱処理の莫大な負担と高価な製造ダイ面積のコストを、マザーボードの電源回路(VRM)や冷却システムへと転嫁した格好だ。さらに現実的な問題として、太くなった実行レーンや巨大な命令ウィンドウは、ソフトウェア側に並列化の余地があって初めてベンチマークスコアの向上へと結びつく。完全に直列的なシーケンシャル処理にとどまるコードでは、増設された演算ユニットは稼働せず、ただ電力を消費して熱を発するだけのシリコンの塊になってしまう。
過去数年間にわたり、IntelとAMDの競争はコア数を競い合う消耗戦の様相を呈していたが、単にコア数を増やしたところでシングルスレッド処理の応答速度は上がらない。AMDはコア内部にメスを入れ、マイクロアーキテクチャの強引なワイド化によってシングルコアの限界値を引き上げることで、コア数偏重だった業界の設計慣性を打破した。
「CPUの進化は停滞した」という見方は正しくない。進化の道筋が切り替わっただけだ。動作クロックが性能向上の唯一の指標でなくなった今、シングルコア処理の進化のハードルは、より巨大で複雑なアーキテクチャ設計によって押し上げられている。次世代のZen 6アーキテクチャを採用するサーバー向け製品では、256コアと驚異的な1GBのL3キャッシュが計画されていると噂される。トランジスタを積み上げアーキテクチャをワイド化するこの道において、計算力の成長は今後も続くだろう。だがその飛躍のたびに、ユーザーはより強固な冷却装置と重い電力代という対価を支払うことになる。
参考リンク:
- How did AMD Ryzen get 50% faster in two years?
- HN 議論 (item?id=49758709)