벤치마크 점수는 50% 치솟았지만, 클럭은 5GHz 언저리에서 제자리걸음
2,016점, 2,426점, 2,969점. 이는 긱벤치 6(Geekbench 6) 벤치마크 플랫폼에서 3세대에 걸친 AMD 데스크톱 프로세서가 기록한 싱글코어 점수들이다. Ryzen 7 5800X3D부터 9800X3D까지의 성적표를 찬찬히 들여다보면 직관을 거스르는 기현상이 눈에 띈다. 2022년부터 2024년까지 불과 2년이라는 짧은 시간 동안, 동일한 라인업의 싱글코어 성능이 무려 47% 향상되었으며 멀티코어 성능은 58%나 뛰어올랐다.
반도체 업계의 오랜 경험에 비추어 볼 때, 이토록 거대한 성능 도약에는 반드시 동작 주파수의 대대적인 상승이 뒤따라야 마땅했다. 하지만 세부 사양표를 확인해 보면 데이터는 정반대 방향을 가리킨다. Zen 3 아키텍처에서 Zen 5 아키텍처에 이르기까지 최대 부스트 클럭은 4.5GHz에서 5.2GHz로 고작 15% 상승하는 데 그쳤고, 베이스 클럭 역시 3.4GHz에서 4.7GHz로 올랐을 뿐이다.
15%의 클럭 상승으로는 50%에 달하는 엄청난 성능 격차를 설명할 수 없다. 동작 속도가 5GHz 문턱 부근에 묶여 있는 까닭은 칩의 발열 해소와 누설 전류 제어가 이미 물리적 한계선에 부딪혔기 때문이다. 동작 주파수가 5GHz를 넘어서면 신호 안정성을 유지하기 위해 요구되는 전압이 비선형적으로 치솟는다. 미세 공정 실리콘에서 발생하는 누설 전류와 열 밀도는 순식간에 프로세서를 쓰로틀링(과열 방지 성능 저하)의 악순환에 빠뜨린다.
이 비교 데이터는 기존의 발전 패러다임이 종말을 고했음을 여실히 보여준다. 싱글코어 성능 향상은 이제 더 이상 높은 동작 클럭에 의존하지 않는다. 프로세서 파이프라인의 회전 속도를 더 이상 높일 수 없게 되자, 엔지니어들이 선택한 유일한 돌파구는 파이프라인 자체를 완전히 해체하고 유례없는 규모로 넓히는 것이었다.
명령어 차선을 넓히다: 코어 내부에 50억 개의 새 트랜지스터 투입
주파수 상승이라는 수직적 혜택이 고갈되자, 아키텍처를 수평적으로 넓히는 것만이 연산 성능을 지속적으로 끌어올릴 수 있는 유일한 출구가 되었다. Zen 3에서 Zen 5로 넘어가는 동안 AMD는 프로세서 하나에 할당되는 트랜지스터 예산을 끊임없이 늘렸다. 전체 트랜지스터 수는 약 110억 개에서 약 160억 개로 급증해, 물리적 규모가 50%나 확장되었다.
새롭게 추가된 50억 개의 트랜지스터는 단순히 캐시 메모리를 무작정 늘리는 손쉬운 길 대신, 연산 코어 내부의 실행 로직에 집중 투입되었다. 명령어 인출 및 디코딩 프론트엔드에서 가장 두드러진 변화는 디스패치(발행) 폭의 확장이다. Zen 3 아키텍처에서는 클럭 사이클당 백엔드로 보낼 수 있는 명령어가 최대 6개였으나, Zen 5에서는 이를 8개로 끌어올렸다.
디코딩 폭을 6개에서 8개로 늘리는 작업은 단순히 배선을 늘리는 수준의 일이 아니다. x86 명령어 세트는 길이가 가변적이기 때문에, 디코더는 이전 명령어가 어디서 끝나는지 모르는 상태에서 연속된 8개의 명령어를 동시에 예측하고 분할해야 한다. 이러한 거대한 예측 회로 자체가 엄청난 면적과 트랜지스터를 집어삼킨다.
백엔드의 정수 연산 유닛 역시 대폭 늘어났다. 이전 아키텍처에서는 4개의 정수 산술 논리 연산 장치(ALU)가 연산 작업을 도맡았으나, Zen 5에서는 6개로 증설되었다. 이는 동일한 클럭 사이클 내에서 프로세서가 더 많은 기본 연산을 동시에 처리할 수 있음을 의미하며, 실행 파이프라인 전체의 처리량을 자연스럽게 끌어올렸다.
 그림: AMD Ryzen 프로세서와 메인보드 플랫폼. 출처: Wikimedia Commons, CC0
400개 이상의 비순차 명령어를 소화: 스케줄러의 시야를 두 배로 확장
실행 통로를 넓히는 것은 첫걸음에 불과하며, 진짜 엔지니어링 과제는 새로 증설된 유닛들이 놀지 않고 쉬지 않고 돌아가도록 보장하는 데 있다. 현대의 고성능 프로세서는 모두 비순차적 실행(OoO) 메커니즘에 의존하여, 뒤이어 올 코드들을 미리 분석하고 상호 의존성이 없는 작업을 찾아내 앞당겨 처리한다. 이러한 미래 예측 능력이 확보되어야만 늘어난 정수 유닛이 전력을 낭비하지 않고 풀가동될 수 있다.
이러한 예측 시야의 범위를 결정하는 핵심 장치가 바로 재정렬 버퍼(ROB, Reorder Buffer)다. Zen 3 시절에는 이 버퍼의 용량이 256개 명령어에 불과했다. 코드 구조가 조금만 복잡해지거나 지연 시간이 긴 메모리 접근이 발생하면, 스케줄러의 시야가 좁아 독립적인 작업을 충분히 찾아내지 못했고 연산 유닛은 멈춰 설 수밖에 없었다.
하지만 Zen 5에 이르러 재정렬 버퍼의 용량은 한 번에 448개 항목으로 확장되었다. 이 거대한 구조를 통해 프로세서는 비행 중(in-flight) 상태인 약 500개의 명령어를 한꺼번에 담아두고 복잡한 종속성을 분석할 수 있게 되었다. 스케줄러는 비로소 충분한 탐색 공간을 확보하여 복잡하게 얽힌 코드 스트림에서 병렬 처리 가능한 연산 작업을 능숙하게 솎아낼 수 있게 되었다.
명령어 윈도우가 이 정도로 커지면, 캐시 미스가 발생해 메인 메모리에서 데이터를 가져오느라 수백 사이클을 허비해야 하는 상황이 닥쳐도 코어는 멍하니 기다리지 않는다. 스케줄러는 400여 개가 넘는 대기 풀에서 해당 데이터와 무관한 다른 작업들을 신속히 찾아내, 긴 대기 시간을 빈틈없이 연산 작업으로 채워 넣는다.
| 프로세서 모델 | 아키텍처 | 출시 연도 | 싱글코어 점수 | 최대 부스트 클럭 | 정수 연산 유닛 수 | 버퍼 용량 |
|---|---|---|---|---|---|---|
| Ryzen 7 5800X3D | Zen 3 | 2022년 | 2,016점 | 4.5 GHz | 4개 | 256개 항목 |
| Ryzen 7 7800X3D | Zen 4 | 2023년 | 2,426점 | 5.0 GHz | 4개 | 320개 항목 |
| Ryzen 7 9800X3D | Zen 5 | 2024년 | 2,969점 | 5.2 GHz | 6개 | 448개 항목 |
데이터 통로 2배 확장: 연산 유닛이 데이터를 기다리며 멈추지 않도록
연산 유닛과 스케줄링 윈도우의 확장은 필연적으로 메모리 서브시스템에 가혹한 성능을 요구한다. 데이터를 실어 나르는 속도가 명령어를 소모하는 속도를 따라가지 못하면, 실행 통로가 아무리 넓어도 연산 유닛은 극심한 데이터 기아 상태에 빠지게 된다. 따라서 캐시 계층을 키우고 내부 데이터 버스를 넓히는 것은 프론트엔드 연산 능력의 확장에 발맞추기 위한 필수 조치다.
코어에 가장 인접한 L1 데이터 캐시는 32KB에서 48KB로 늘어났으며, 코어별 전용 L2 캐시는 512KB에서 1MB로 두 배 증가했다. 연산 코어 바로 옆에 배치된 이 초고속 메모리들은 자주 쓰이는 핫 데이터를 단 몇 사이클 만에 즉각 꺼내올 수 있게 하여 메인 메모리로 원정을 떠나는 횟수를 획기적으로 줄여준다.
부동소수점 및 벡터 연산 영역에서 데이터 통로의 확장은 더욱 공격적이다. Zen 3와 Zen 4 아키텍처는 4개의 256비트 SIMD 연산 유닛을 사용했으나, Zen 5에 이르러 AMD는 4개의 온전한 512비트 연산 유닛으로 전격 교체했다. 폭이 두 배로 넓어지면서 단일 명령어 하나로 16개의 단정밀도 부동소수점을 동시에 처리할 수 있게 되었으며, 과학 계산이나 로컬 거대 언어 모델(LLM) 추론 작업에서 눈부신 효율성 향상을 가져왔다.
처리량이 두 배로 불어난 이 연산 괴수를 굶기지 않기 위해 메모리 접근 경로 역시 동일한 규모로 업그레이드되었다. 새로운 아키텍처는 클럭 사이클당 2회의 512비트 로드(Load)와 1회의 512비트 스토어(Store) 작업을 동시에 수행할 수 있다. 방대한 버스 대역폭과 두 배로 커진 캐시 용량이 결합되면서, 마침내 데이터 공급 속도가 거대해진 연산 유닛의 소모 속도를 온전히 따라잡을 수 있게 되었다.
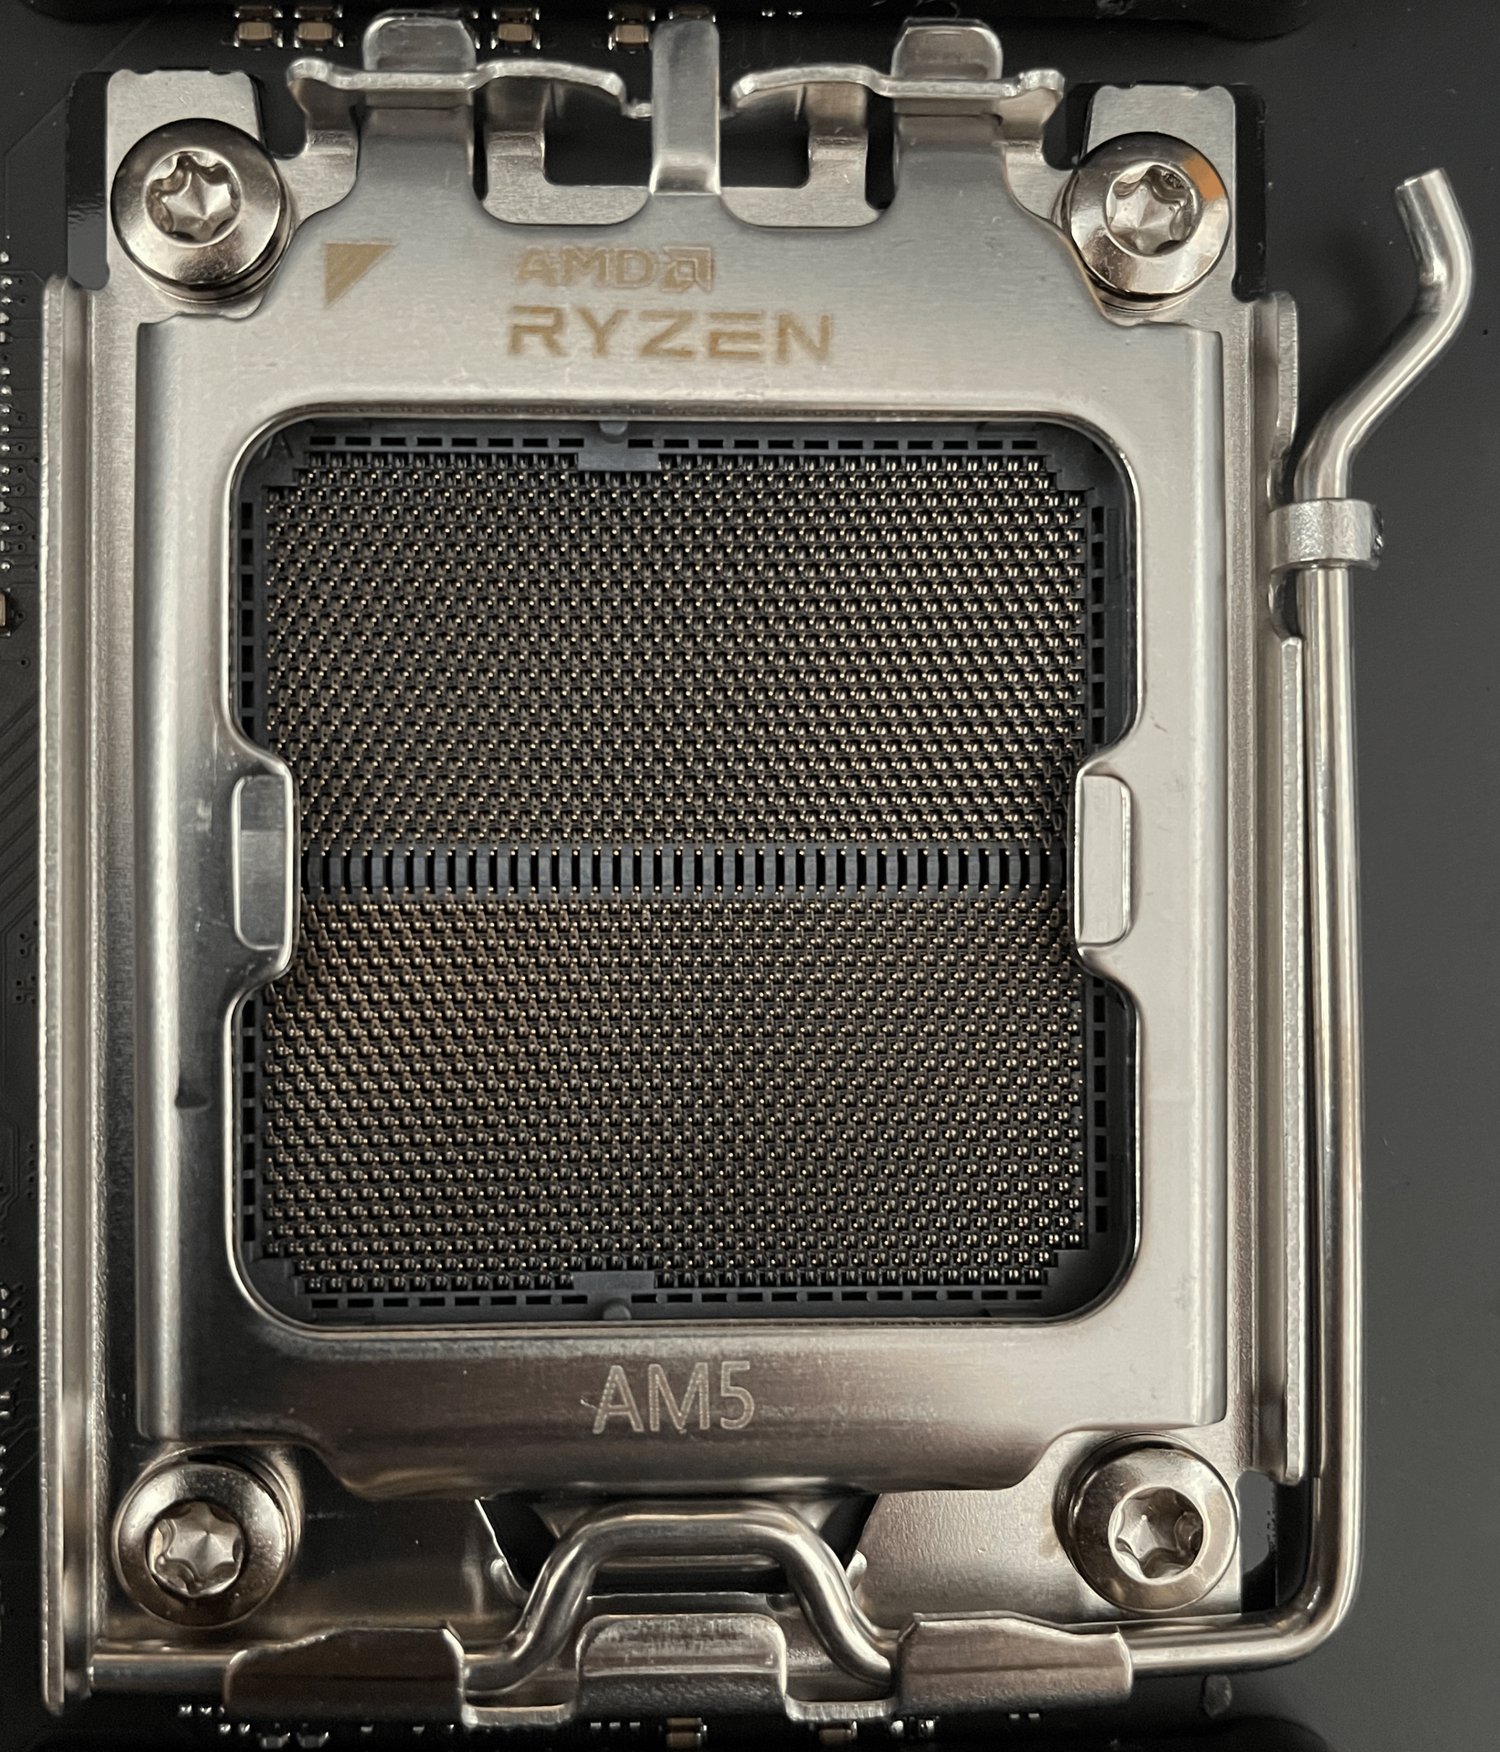 그림: AMD AM5 프로세서 소켓. 출처: Wikimedia Commons, CC BY-SA 4.0
물리적 규모와 맞바꾼 속도: 치솟는 발열의 대가는 누가 치르는가
물리적 규모를 쏟아부어 성능을 끌어올리는 방식에는 막대한 대가가 따른다. 50억 개의 트랜지스터가 추가되면서, 비록 극한의 고클럭을 지양하더라도 정적 누설 전류와 동작 전력 소모는 높은 수준을 유지하게 된다. 실리콘 다이 위의 국소적인 열 밀도가 급격히 치솟으면서, 기존의 평범한 공랭 쿨러로는 순간적으로 뿜어져 나오는 열기를 억제하기가 점점 더 어려워지고 있다.
칩 설계자들은 막대한 발열 제어 부담과 고가의 다이 면적 비용을 메인보드 전원부(VRM)와 고성능 쿨링 시스템으로 떠넘긴 셈이다. 더욱 현실적인 문제는, 넓어진 실행 유닛과 거대한 명령어 윈도우는 소프트웨어가 충분한 병렬 처리 잠재력을 지니고 있을 때만 벤치마크 점수 향상으로 이어진다는 점이다. 순수하게 직렬적인 로직으로 작성된 소프트웨어를 실행할 때는, 늘어난 연산 유닛들이 그저 멍하니 전력을 소모하며 열만 뿜어내는 실리콘 조각에 불과하다.
지난 몇 년 동안 인텔과 AMD의 경쟁은 코어 개수를 늘리는 소모전에 치우쳐 있었다. 하지만 단순히 코어 수를 늘린다고 해서 단일 스레드 작업의 응답 속도가 빨라지지는 않는다. AMD는 코어 내부를 과감하게 뜯어고쳐 마이크로아키텍처를 대폭 확장함으로써 싱글코어 성능의 상한선을 끌어올렸고, 덮어놓고 코어 수만 늘리던 업계의 관성을 정면으로 뒤흔들었다.
프로세서 발전이 정체되었다는 주장은 현실과 맞지 않다. 발전의 경로가 바뀌었을 뿐이다. 동작 클럭이 더 이상 성능의 유일한 척도가 되지 못하는 시대에, 싱글코어 연산의 벽은 한층 거대하고 복잡해진 아키텍처 설계로 극복되고 있다. 차세대 Zen 6 아키텍처 기반 서버용 프로세서는 이미 256개 코어와 경이로운 1GB L3 캐시를 겨냥하고 있다는 소식이 들려온다. 트랜지스터를 쏟아붓고 아키텍처를 수평 확장하는 이 길 위에서 성능 향상은 멈추지 않겠지만, 그 도약의 순간마다 사용자는 더 강력한 쿨러와 무거워진 전기 요금 청구서라는 대가를 감당해야 할 것이다.
참고 링크:
- How did AMD Ryzen get 50% faster in two years?
- HN 토론 (item?id=49758709)