Des scores en hausse de moitié, une fréquence bloquée autour des 5 GHz
2 016 points, 2 426 points et 2 969 points : telle est la progression des scores monocœurs enregistrés par trois générations successives de processeurs de bureau AMD sur le banc Geekbench 6. En comparant le Ryzen 7 5800X3D au 9800X3D, on se heurte à un constat qui défie l’intuition habituelle. Sur une fenêtre temporelle de deux ans seulement, entre 2022 et 2024, les performances monocœurs d’une même gamme ont bondi de 47 %, tandis que le score multicœur progressait de 58 %.
Selon l’expérience accumulée par l’industrie, un tel saut de performances devait nécessairement s’accompagner d’une flambée des fréquences d’horloge. Or, l’examen attentif des fiches techniques révèle une trajectoire tout autre. De l’architecture Zen 3 à Zen 5, la fréquence turbo maximale n’est passée que de 4,5 GHz à 5,2 GHz, et la fréquence de base de 3,4 GHz à 4,7 GHz.
Une hausse de fréquence de 15 % ne saurait combler à elle seule un déficit de puissance de près de 50 %. Si les fréquences stagnent aux portes des 5 GHz, c’est que la dissipation thermique et les courants de fuite se heurtent à de stricts murs physiques. Au-delà de 5 GHz, la tension nécessaire pour maintenir l’intégrité du signal augmente de manière exponentielle ; à l’échelle microscopique, fuites de courant et densité thermique enferment le silicium dans la spirale mortifère du bridage thermique (thermal throttling).
Ces données sonnent le glas d’un vieux dogme : le gain de performances monocœur ne dépend plus d’une fréquence d’horloge accrue. Ne pouvant plus faire tourner les pipelines plus vite, les architectes n’avaient d’autre choix que de rebâtir la chaîne d’exécution en l’élargissant à une échelle sans précédent.
Élargir les voies d’exécution : cinq milliards de transistors injectés dans le cœur
Lorsque le filon de la montée en fréquence s’est tari, l’élargissement horizontal de l’architecture s’est imposé comme l’unique planche de salut pour continuer à faire progresser la puissance de calcul. De Zen 3 à Zen 5, le budget de transistors alloué à chaque processeur n’a cessé d’enfler : le décompte global est passé d’environ 11 milliards à 16 milliards de transistors, soit une augmentation physique de 50 %.
Ces cinq milliards de transistors supplémentaires n’ont pas simplement servi à empiler davantage de mémoire cache ; ils ont été injectés au cœur même de la logique d’exécution. Au niveau du frontend de récupération (fetch) et de décodage des instructions, la transformation la plus frappante réside dans la largeur d’émission (dispatch width) : alors que Zen 3 ne pouvait acheminer que six instructions par cycle vers le backend, Zen 5 porte cette capacité à huit.
Faire passer la largeur de décodage de six à huit instructions est une prouesse qui dépasse de loin le simple ajout de pistes de communication. Le jeu d’instructions x86 étant de longueur variable, le décodeur doit prédire et segmenter simultanément huit instructions successives sans savoir a priori où s’achève l’instruction précédente. Ces volumineux circuits de prédiction engloutissent à eux seuls une surface de die et un nombre de transistors considérables.
Le backend de calcul entier a bénéficié d’une extension comparable. Dans les architectures précédentes, quatre unités arithmétiques et logiques (ALU) d’entiers traitaient l’essentiel des calculs ; ce nombre a été porté à six. Le processeur peut ainsi traiter simultanément davantage d’opérations élémentaires à chaque cycle, décuplant naturellement le débit effectif du pipeline d’exécution.
 Figure : Un processeur AMD Ryzen et sa carte mère. Source : Wikimedia Commons, CC0
Absorber plus de 400 instructions hors-ordre : la fenêtre de l’ordonnanceur double de volume
Disposer de canaux d’exécution élargis n’est qu’un prérequis ; le véritable défi d’ingénierie consiste à éviter que ces unités supplémentaires ne tournent à vide. Les puces modernes de pointe s’appuient toutes sur l’exécution dans le désordre (Out-of-Order, OoO) : elles dissèquent le flux de code en amont, identifient les tâches exemptes de dépendances et les calculent par avance. C’est cette faculté d’anticipation qui détermine si les ALU d’entiers supplémentaires tournent à plein régime ou dissipent de l’énergie pour rien.
L’organe clé dictant la portée de cette vision prospective est le tampon de réordonnancement (ROB, Reorder Buffer). Sous Zen 3, ce tampon ne pouvait contenir que 256 instructions. Dès que la logique du code se complexifiait ou qu’une lecture mémoire à forte latence intervenait, l’ordonnanceur manquait de visibilité pour trouver des tâches indépendantes, contraignant les unités d’exécution à patienter.
Avec Zen 5, la capacité du tampon de réordonnancement a été portée d’un seul coup à 448 entrées. Cette imposante structure permet au processeur de conserver près de 500 instructions en vol simultanément tout en procédant à de subtiles analyses de dépendance. L’ordonnanceur dispose enfin d’une marge de manœuvre suffisante pour extraire des calculs parallélisables au cœur de flots d’instructions enchevêtrés.
Avec une fenêtre d’instructions aussi vaste, lorsqu’un défaut de cache impose d’attendre des centaines de cycles pour récupérer une donnée en mémoire vive, le cœur ne se fige plus. L’ordonnanceur pioche parmi plus de 400 instructions en attente d’autres tâches décorrélées de cette donnée, occupant sans interruption les cycles d’attente.
| Modèle de processeur | Architecture | Année de sortie | Score monocœur | Fréquence turbo maximale | Unités de calcul entier | Capacité du tampon |
|---|---|---|---|---|---|---|
| Ryzen 7 5800X3D | Zen 3 | 2022 | 2 016 pts | 4,5 GHz | 4 | 256 entrées |
| Ryzen 7 7800X3D | Zen 4 | 2023 | 2 426 pts | 5,0 GHz | 4 | 320 entrées |
| Ryzen 7 9800X3D | Zen 5 | 2024 | 2 969 pts | 5,2 GHz | 6 | 448 entrées |
Canaux de données dédoublés : les unités de calcul ne restent jamais à sec
L’expansion de la puissance de calcul et de la fenêtre d’ordonnancement soumet inévitablement le sous-système mémoire à des contraintes draconiennes. Si le débit de transfert des données ne suit pas le rythme de consommation des instructions, les unités d’exécution les plus larges se retrouvent immédiatement affamées. L’augmentation des mémoires caches et l’élargissement des bus internes constituent donc des adaptations incontournables.
La mémoire cache de données L1 dédiée est passée de 32 Ko à 48 Ko, tandis que le cache L2 propre à chaque cœur a été purement et simplement doublé, passant de 512 Ko à 1 Mo. Ces mémoires ultrarapides collées aux cœurs de calcul garantissent l’extraction des données critiques en un nombre infime de cycles, réduisant drastiquement les allers-retours vers la mémoire vive.
Sur le front des calculs vectoriels et en virgule flottante, la refonte des voies de données s’avère encore plus radicale. Là où Zen 3 et Zen 4 mobilisaient quatre unités de calcul SIMD de 256 bits, Zen 5 a directement intégré quatre unités complètes de 512 bits. Ce doublement de largeur permet à une seule instruction de traiter seize nombres à virgule flottante en simple précision en une seule passe, offrant un gain spectaculaire pour le calcul scientifique et l’inférence locale de modèles de langage.
Pour rassasier ce monstre de calcul au débit décuplé, les canaux d’accès mémoire ont été mis à niveau dans les mêmes proportions. La nouvelle architecture gère simultanément deux lectures (load) et une écriture (store) de 512 bits par cycle. La colossale bande passante du bus, conjuguée au doublement des mémoires caches, assure enfin un acheminement des données au même rythme que l’enflure des unités de calcul.
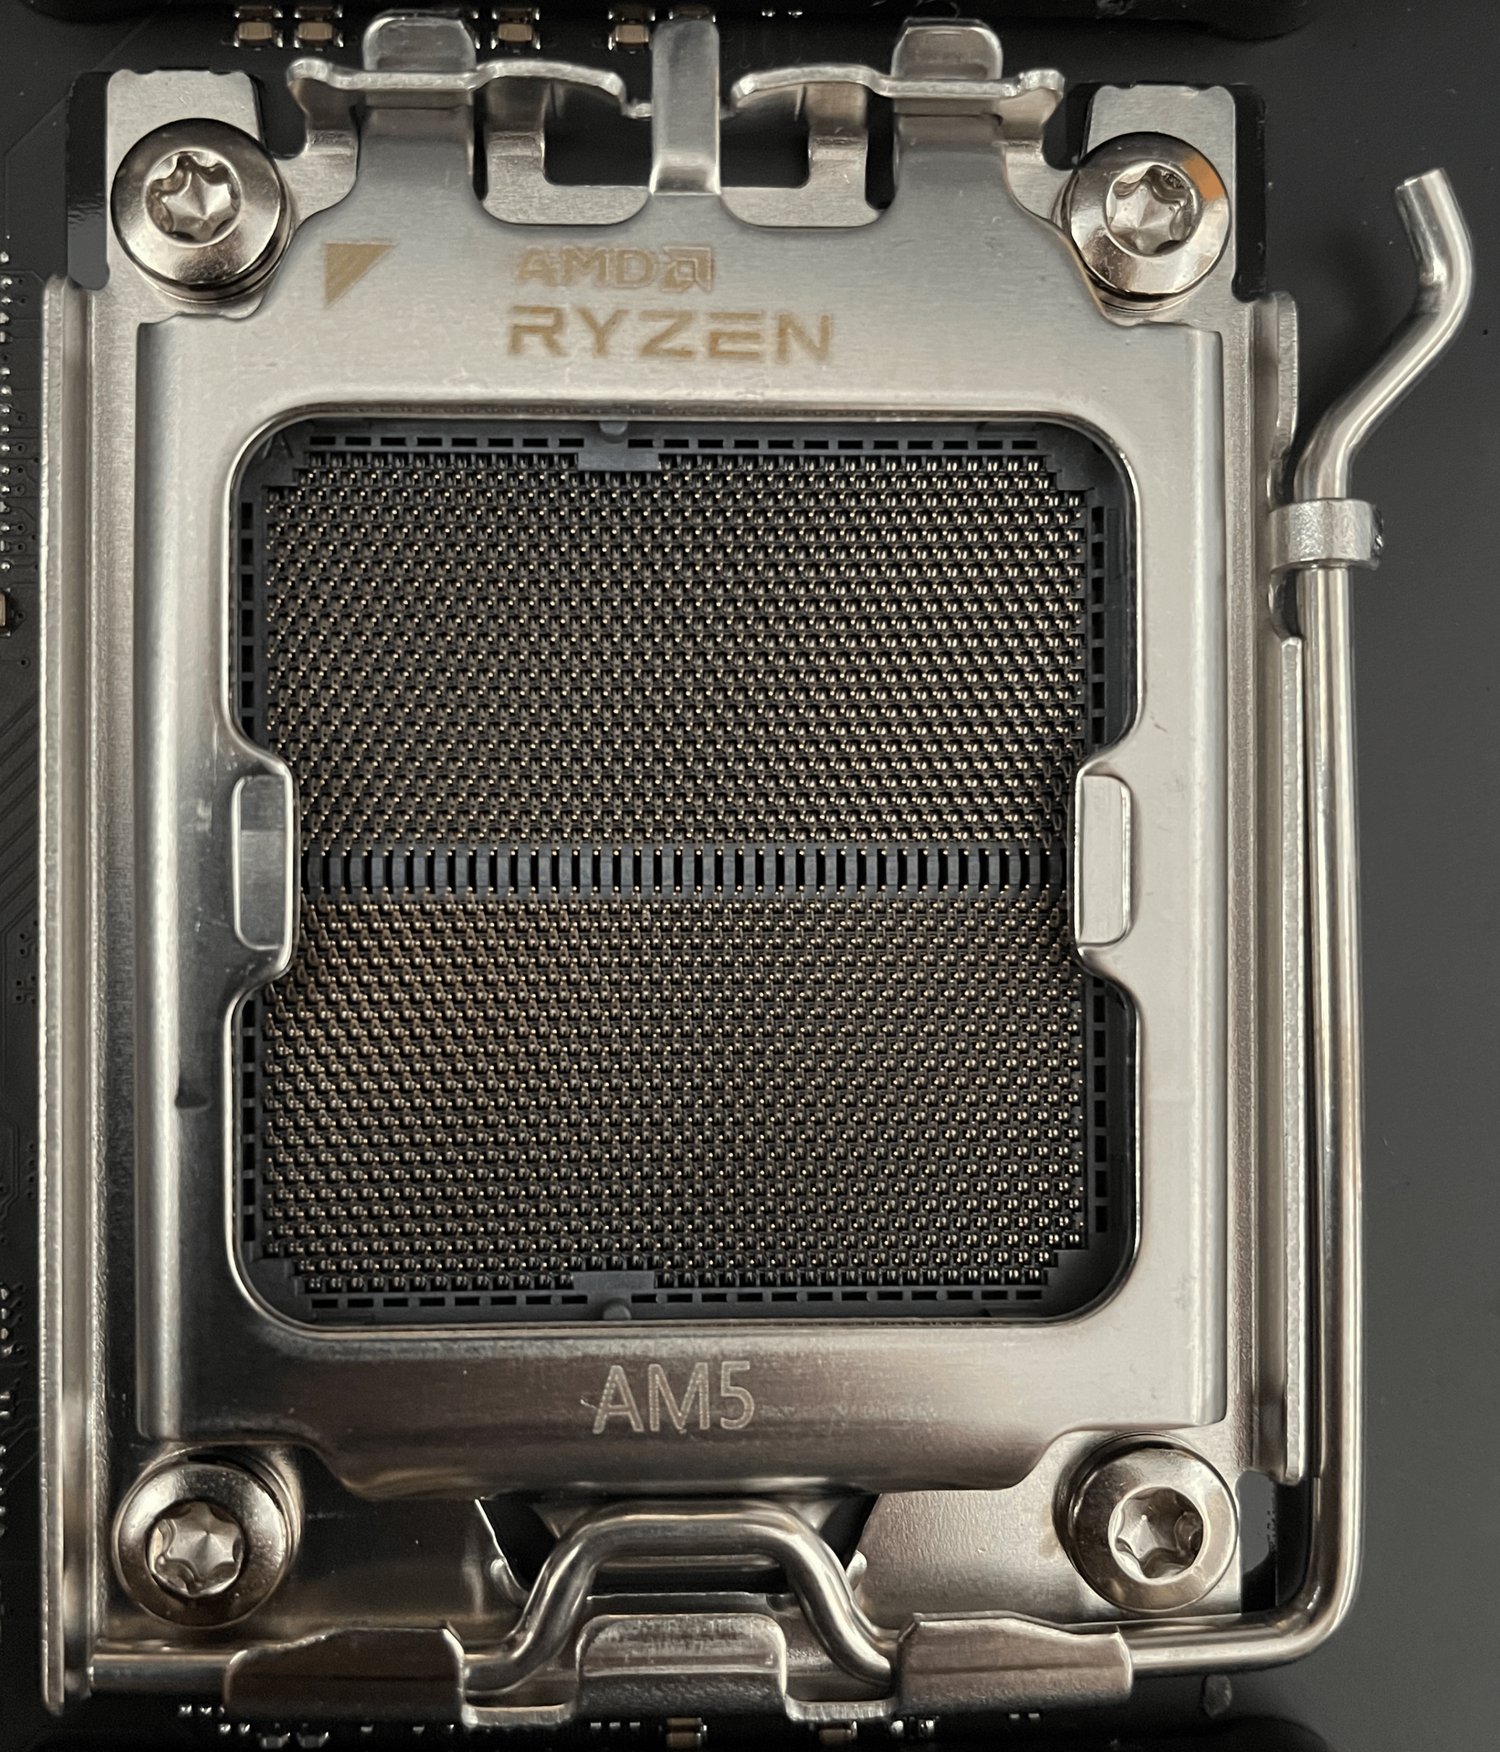 Figure : Le socket de processeur AMD AM5. Source : Wikimedia Commons, CC BY-SA 4.0
Acheter la vitesse au prix du silicium : qui paie la facture thermique ?
Cette quête de performances par l’accroissement des dimensions physiques engendre des coûts bien réels. L’adjonction de cinq milliards de transistors implique que, même sans viser des fréquences extrêmes, les fuites statiques et la consommation active demeurent élevées. La densité thermique à la surface de la puce explose, rendant les ventirads à air classiques de plus en plus impuissants face à ces décharges thermiques soudaines.
En pratique, les concepteurs de puces ont transféré la lourde charge de la dissipation thermique, ainsi que le coût surfacique du silicium, vers les étages d’alimentation des cartes mères (VRM) et les systèmes de refroidissement liquide. Plus concrètement encore, des unités d’exécution élargies et une gigantesque fenêtre d’instructions ne se traduisent par des victoires sur les bancs d’essai que si les logiciels présentent un parallélisme exploitable. Face à un code strictement séquentiel, ces unités additionnelles demeurent oisives, se contentant de dissiper de la chaleur et de consommer du courant.
Durant trois ans, la rivalité entre Intel et AMD a pris des allures de guerre d’usure axée sur la multiplication des cœurs. Or, le simple ajout de cœurs n’accélère nullement la latence d’exécution d’un traitement monotâche. En choisissant d’intervenir à l’intérieur même du cœur et d’élargir agressivement la microarchitecture pour hisser le plafond du monocœur, AMD a brisé la routine d’un empilement aveugle de cœurs.
Le discours sur la stagnation des processeurs est trompeur : le progrès a simplement changé de voie. Lorsque la fréquence cesse d’être l’unique étalon de la performance, le seuil d’accès à la puissance monocœur est rehaussé par des architectures infiniment plus complexes. Selon les fuites techniques actuelles, les prochaines générations pour serveurs sous architecture Zen 6 visent déjà 256 cœurs et un gigaoctet vertigineux de cache L3. Sur cette voie d’accumulation de transistors et d’élargissement architectural, les gains de calcul se poursuivront ; mais à chaque saut de génération, l’utilisateur devra payer l’addition sous forme de refroidisseurs plus massifs et de factures d’électricité alourdies.
Liens de référence :
- How did AMD Ryzen get 50% faster in two years?
- Discussion sur HN (item?id=49758709)