Los resultados se disparan casi un 50%, pero el reloj se estanca en los 5 GHz
2.016 puntos, 2.426 puntos y 2.969 puntos: estos son los registros de rendimiento mononúcleo que tres generaciones consecutivas de procesadores de escritorio AMD han dejado en Geekbench 6. Si se examina la evolución del Ryzen 7 5800X3D al 9800X3D, surge una realidad que desafía la intuición tradicional. En un intervalo de apenas dos años, entre 2022 y 2024, el rendimiento mononúcleo de una misma línea de producto creció un 47 %, mientras que el rendimiento multinúcleo se disparó un 58 %.
La experiencia acumulada durante décadas en la industria dictaba que un avance de semejante calibre debía sustentarse en un notable incremento de la frecuencia de reloj. Sin embargo, las tablas de especificaciones apuntan en una dirección bien distinta. Del paso de Zen 3 a Zen 5, la frecuencia turbo máxima solo ascendió de 4,5 GHz a 5,2 GHz, mientras que la frecuencia base pasó de 3,4 GHz a 4,7 GHz.
Una subida de frecuencia del 15 % resulta a todas luces insuficiente para cerrar una brecha de rendimiento de casi el 50 %. La velocidad de reloj se ha topado contra la barrera de los 5 GHz debido a que la disipación térmica y las corrientes de fuga han alcanzado un muro físico insalvable. Al rebasar los 5 GHz, el voltaje requerido para sostener la estabilidad de la señal se dispara de forma no lineal; a escala microscópica, las fugas de corriente y la densidad de calor bastan para atrapar al procesador en una espiral destructiva de estrangulamiento térmico (thermal throttling).
Estos datos desmantelan el relato de épocas pasadas: el crecimiento del rendimiento mononúcleo ya no depende de alcanzar frecuencias de reloj más elevadas. Ante la imposibilidad física de acelerar el ritmo de la cadena de montaje, la única salida viable para los ingenieros consistió en derribar el diseño previo y ensanchar la arquitectura hasta cotas nunca vistas.
Ensanchar las vías: cinco mil millones de transistores más para el núcleo
Agotado el margen de mejora por la vía vertical de las frecuencias, ensanchar horizontalmente la arquitectura se convirtió en el único camino para sostener el crecimiento de la potencia de cálculo. Desde Zen 3 hasta Zen 5, el presupuesto de transistores de cada procesador no dejó de expandirse: el cómputo total pasó de unos 11.000 millones a 16.000 millones de transistores, lo que supone un incremento de escala del 50 %.
Estos cinco mil millones de transistores adicionales no se destinaron simplemente a apilar más memoria caché, sino que se integraron directamente en la lógica de cálculo del núcleo. En el extremo frontal (frontend) de captura y decodificación de instrucciones, la modificación más visible es la ampliación del ancho de emisión (dispatch width): la arquitectura Zen 3 podía emitir como máximo seis instrucciones por ciclo hacia el backend, cifra que en Zen 5 aumentó hasta ocho.
Elevar el ancho de decodificación de seis a ocho instrucciones va mucho más allá de trazar pistas conductoras adicionales. El repertorio de instrucciones x86 es de longitud variable, lo que obliga al decodificador a predecir y fragmentar ocho instrucciones consecutivas en paralelo sin saber de antemano dónde termina la anterior. Ese complejo entramado de predicción consume por sí solo una porción sustancial de área y transistores.
El backend de cálculo entero experimentó una ampliación equivalente. En arquitecturas anteriores, cuatro unidades aritmético lógicas (ALU) de enteros asumían el grueso del trabajo; con Zen 5 esa dotación se elevó a seis. Esto permite al procesador despachar más operaciones básicas de manera simultánea en cada ciclo, impulsando de forma directa el rendimiento de procesamiento de las líneas de ejecución.
 Figura: Un procesador AMD Ryzen junto a su placa base. Fuente: Wikimedia Commons, CC0
Digerir más de 400 instrucciones fuera de orden: la ventana del planificador se duplica
Disponer de vías de ejecución más anchas es solo el primer paso; el verdadero desafío de ingeniería consiste en garantizar que esas unidades adicionales no se queden inactivas. Los procesadores modernos de alto rendimiento dependen por completo de la ejecución fuera de orden (OoO, out-of-order), analizando el código venidero para identificar tareas libres de dependencias y calcularlas por adelantado. Esta capacidad de anticipación determina si las nuevas ALU de enteros rinden a plena capacidad o consumen energía en vano.
El componente central que define el alcance de esta visión de futuro es el búfer de reordenamiento (ROB, Reorder Buffer). En la era de Zen 3, este búfer albergaba un máximo de 256 instrucciones. En cuanto la lógica del código se complicaba o surgía un acceso a memoria de alta latencia, el planificador se quedaba sin margen para encontrar tareas independientes, obligando a las unidades de cómputo a detenerse.
En Zen 5, la capacidad del búfer de reordenamiento se amplió de golpe hasta las 448 entradas. Esta colosal estructura permite al procesador gestionar casi 500 instrucciones en vuelo de manera simultánea, analizando dependencias complejas entre ellas. El planificador cuenta por fin con holgura suficiente para rastrear flujos de código intrincados y rescatar tareas que puedan ejecutarse en paralelo.
Con una ventana de instrucciones tan amplia, cuando ocurre un fallo de caché y el procesador debe esperar cientos de ciclos para traer datos de la memoria principal, el núcleo no se detiene a esperar. El planificador extrae del fondo de reserva de más de 400 entradas una multitud de tareas independientes, llenando por completo esos tiempos muertos con cálculo productivo.
| Modelo de procesador | Arquitectura | Año de lanzamiento | Puntuación mononúcleo | Frecuencia turbo máxima | Unidades de cálculo entero | Capacidad del búfer |
|---|---|---|---|---|---|---|
| Ryzen 7 5800X3D | Zen 3 | 2022 | 2.016 pts | 4,5 GHz | 4 | 256 entradas |
| Ryzen 7 7800X3D | Zen 4 | 2023 | 2.426 pts | 5,0 GHz | 4 | 320 entradas |
| Ryzen 7 9800X3D | Zen 5 | 2024 | 2.969 pts | 5,2 GHz | 6 | 448 entradas |
El doble de vías de datos: unidades de cálculo que jamás se quedan esperando
El crecimiento de la potencia de cálculo y de la ventana de planificación impone unas exigencias implacables al subsistema de memoria. Si la velocidad de transferencia de datos no sigue el ritmo al que se consumen las instrucciones, las unidades de cálculo más anchas terminan asfixiadas por falta de datos. Por ello, expandir los niveles de caché y ensanchar los buses internos se convirtió en un requisito ineludible para acompasar el rendimiento del frontend.
La memoria caché L1 de datos dedicada creció de 32 KB a 48 KB, mientras que la caché L2 exclusiva por núcleo se duplicó de 512 KB a 1 MB. Estas memorias ultrarrápidas, pegadas a los núcleos de cálculo, garantizan que los datos de uso frecuente puedan recuperarse en un puñado de ciclos, reduciendo sustancialmente los viajes hacia la memoria principal.
En el ámbito del cálculo en coma flotante y vectorial, la ampliación de los canales de datos resulta aún más contundente. Las arquitecturas Zen 3 y Zen 4 contaban con cuatro unidades de cálculo SIMD de 256 bits; en Zen 5, AMD dio el salto a cuatro unidades completas de 512 bits. Esta duplicación del ancho permite procesar en una sola instrucción 16 números en coma flotante de precisión simple, ofreciendo mejoras inmediatas en computación científica y en inferencia local con modelos de lenguaje.
Para abastecer a esta bestia de cálculo, las vías de acceso a memoria se actualizaron al mismo nivel. La nueva arquitectura permite ejecutar simultáneamente dos operaciones de carga (load) de 512 bits y una de almacenamiento (store) de 512 bits por ciclo. El descomunal ancho de banda del bus, sumado a la duplicación de las cachés, permite que el suministro de datos marche por fin acompasado al ensanchamiento de las unidades operativas.
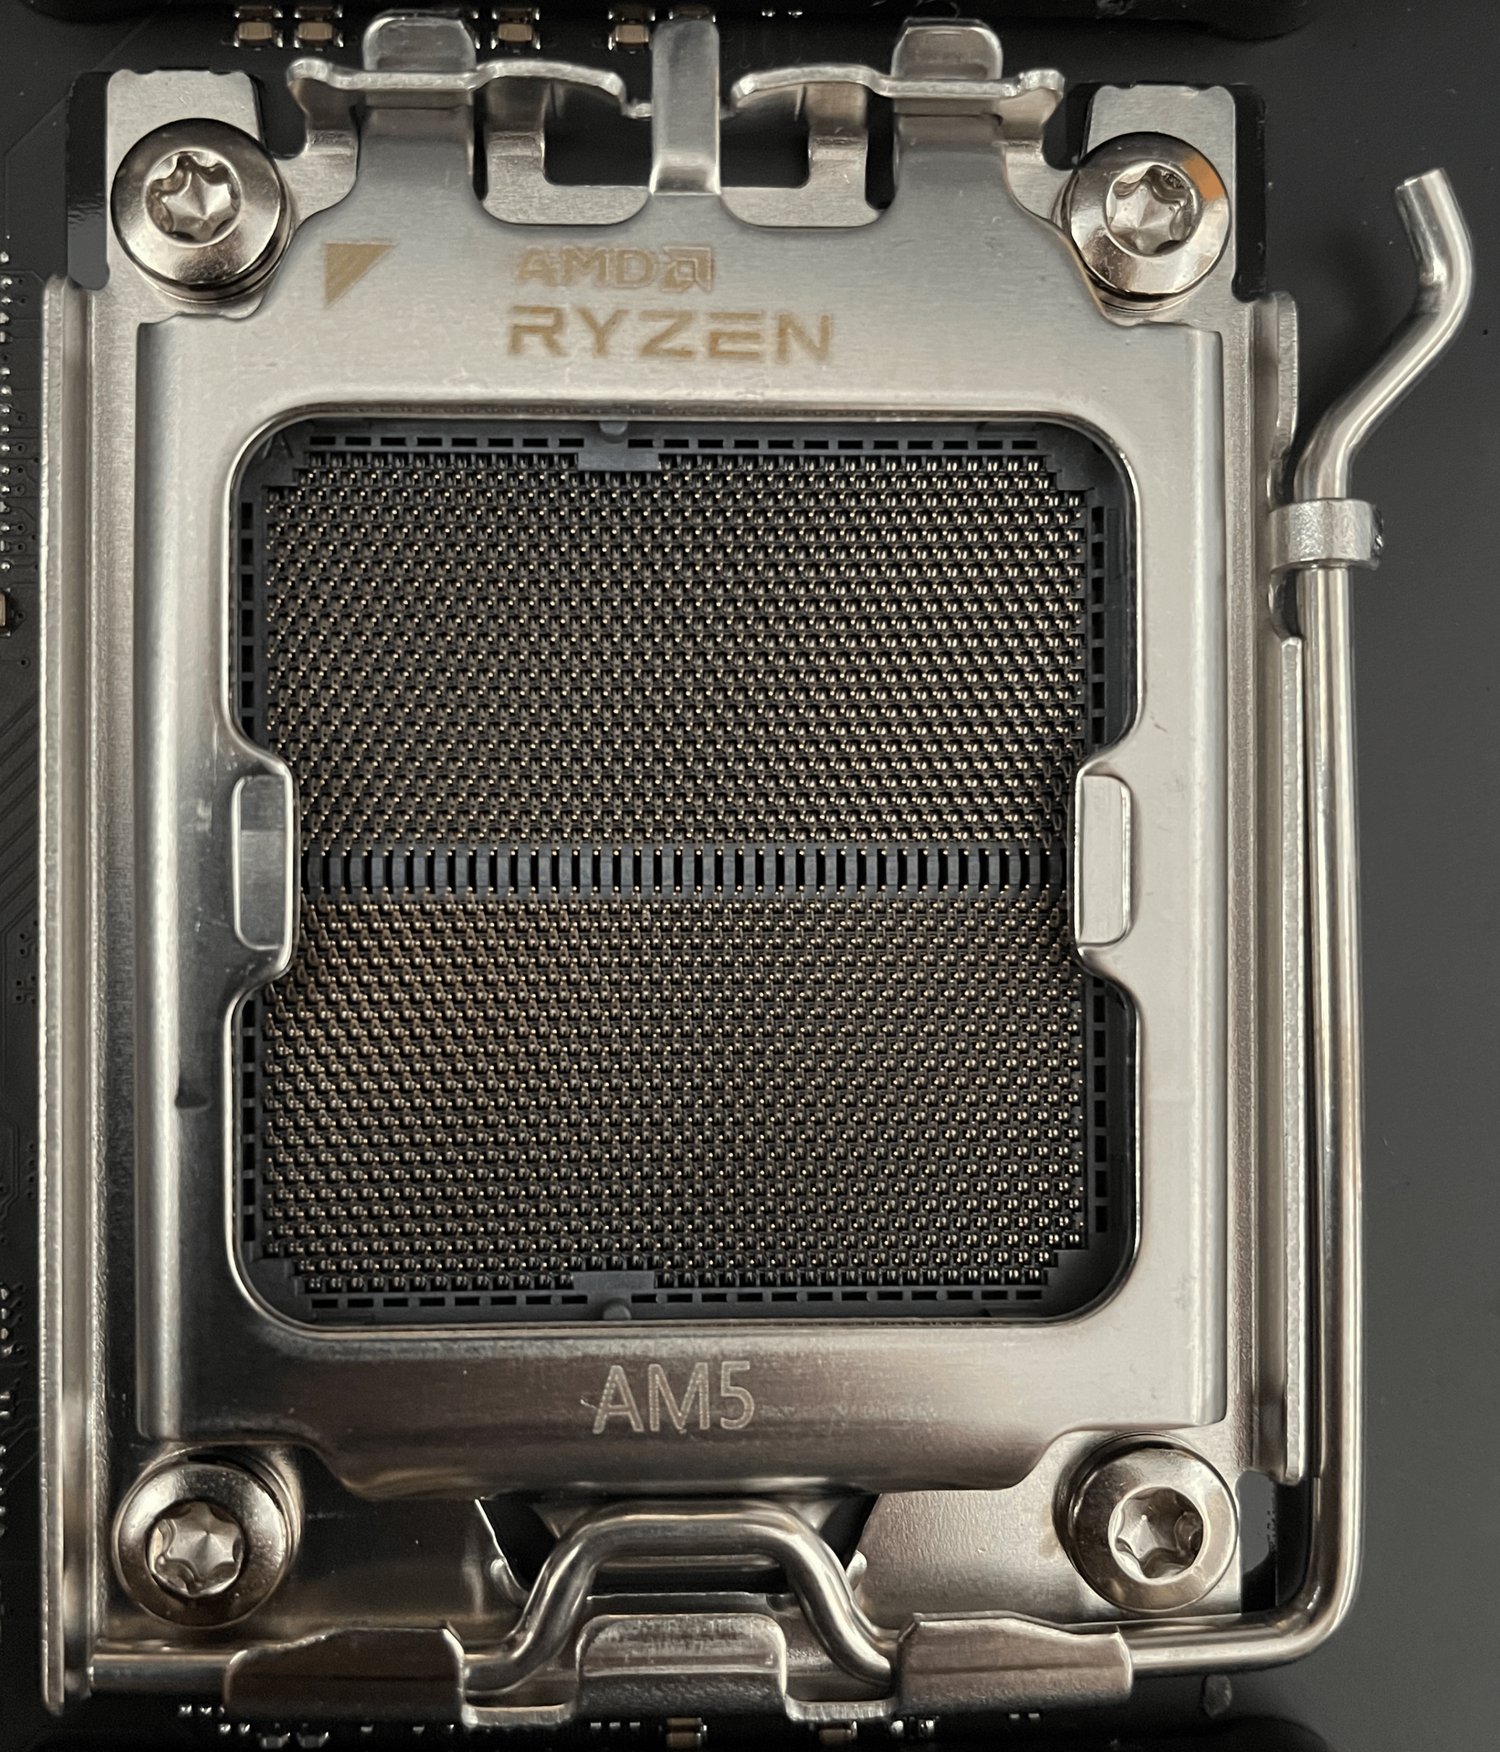 Figura: Zócalo de procesador AMD AM5. Fuente: Wikimedia Commons, CC BY-SA 4.0
Ganar velocidad a base de silicio: ¿quién paga la factura térmica?
Buscar el rendimiento a base de escalar las dimensiones físicas de los chips acarrea costes muy reales. Incorporar cinco mil millones de transistores implica que, incluso sin buscar frecuencias récord, las pérdidas por fuga estática y el consumo activo permanecen en cotas elevadas. La densidad térmica sobre la superficie del silicio se dispara, haciendo que los disipadores convencionales por aire tengan serias dificultades para domar estos picos térmicos repentinos.
En la práctica, los diseñadores han trasladado el inmenso reto de la disipación térmica, junto al coste de matrices de silicio más grandes, hacia las fases de alimentación de las placas base (VRM) y los sistemas de refrigeración líquida. Por otra parte, unidades de cálculo más anchas y ventanas de instrucciones colosales solo se traducen en victorias de rendimiento cuando el software ofrece paralelismo aprovechable. Si el código es estrictamente secuencial, estas unidades adicionales se limitan a permanecer inactivas mientras disipan calor y consumen energía.
Durante los últimos años, la pugna entre Intel y AMD estuvo marcada por una carrera centrada en inflar el número de núcleos. Sin embargo, limitarse a añadir núcleos no reduce la latencia de las tareas de un solo hilo. La decisión de AMD de intervenir en las entrañas del núcleo, ensanchando la microarquitectura para empujar el techo mononúcleo, rompió con la inercia del mercado.
La idea de que la tecnología de procesadores se ha estancado no se ajusta a la realidad; simplemente ha cambiado de dirección. Cuando la frecuencia deja de ser la vara de medir exclusiva, el listón de la computación mononúcleo se supera mediante diseños arquitectónicos más extensos y complejos. Los rumores de ingeniería apuntan a que los futuros procesadores de servidor basados en Zen 6 apuntan ya a 256 núcleos y a un insólito gigabyte de caché L3. En este camino de ensanchamiento y acumulación de transistores, la potencia de cálculo continuará creciendo, pero cada salto exigirá de los usuarios sistemas de disipación más potentes y una factura eléctrica más abultada.
Enlaces de referencia:
- How did AMD Ryzen get 50% faster in two years?
- Debate en HN (item?id=49758709)