Benchmarks steigen um die Hälfte, doch der Takt verharrt bei 5 GHz
2.016 Punkte, 2.426 Punkte, 2.969 Punkte: Das sind die Single-Core-Ergebnisse dreier aufeinanderfolgender Generationen von AMD-Desktop-Prozessoren im Benchmark Geekbench 6. Wer die Leistungswerte vom Ryzen 7 5800X3D bis hin zum 9800X3D gegenüberstellt, stößt auf ein Phänomen, das jeder gängigen Intuition widerspricht. Im knappen Zweijahresfenster von 2022 bis 2024 stieg die Single-Core-Leistung innerhalb derselben Produktfamilie um 47 Prozent – die Multi-Core-Leistung legte sogar um 58 Prozent zu.
Nach jahrzehntelanger Branchenerfahrung hätte ein derart gewaltiger Leistungssprung zwingend mit drastisch gesteigerten Taktfrequenzen einhergehen müssen. Doch ein Blick in das Datenblatt offenbart ein völlig anderes Bild. Beim Übergang von der Zen-3- zur Zen-5-Architektur kletterte der maximale Boost-Takt lediglich von 4,5 GHz auf 5,2 GHz; der Basistakt stieg von 3,4 GHz auf 4,7 GHz.
Ein Taktplus von nur 15 Prozent kann eine Leistungslücke von fast 50 Prozent unmöglich erklären. Dass die Taktraten knapp über der 5-GHz-Marke verharren, liegt daran, dass Wärmeableitung und Leckströme an harte physikalische Grenzen gestoßen sind. Jenseits von 5 GHz erfordert die Aufrechterhaltung der Signalstabilität eine nichtlineare Spannungsanhebung. Auf mikroskopischer Ebene führen die daraus resultierenden Leckströme und thermischen Dichten unweigerlich zu Überhitzung und Thermal Throttling.
Diese Zahlen brechen mit dem überkommenen Paradigma: Wachstum bei der Single-Core-Leistung hängt nicht länger von höheren Taktfrequenzen ab. Da sich die Durchlaufgeschwindigkeit der Rechen-Pipelines physikalisch kaum noch beschleunigen ließ, blieb den Ingenieuren nur ein Ausweg: Sie rissen das bisherige Layout ein und bauten die Ausführungspfade beispiellos breit neu auf.
Breitere Befehlsspuren: Fünf Milliarden zusätzliche Transistoren für den Kern
Als der vertikale Frequenzgewinn erschöpft war, wurde die horizontale Verbreiterung der Mikroarchitektur zur einzigen Option, um den Rechenleistungszuwachs fortzuschreiben. Von Zen 3 bis Zen 5 wuchs das Transistorbudget kontinuierlich an: Die Gesamtzahl der Transistoren stieg von rund 11 Milliarden auf etwa 16 Milliarden – ein Zuwachs von satten 50 Prozent.
Diese fünf Milliarden zusätzlichen Transistoren wurden keineswegs primär in riesige Cache-Strukturen investiert, sondern flossen direkt in die Ausführungslogik des Prozessorkerns. Am Frontend für Befehlsabruf und Dekodierung zeigt sich die auffälligste Änderung bei der Dispatch-Breite: Konnte die Zen-3-Architektur pro Taktzyklus maximal sechs Befehle an das Backend übergeben, sind es bei Zen 5 nun acht.
Die Dekodier- und Dispatch-Breite von sechs auf acht Befehle anzuheben, ist weit komplexer als das bloße Verlegen zusätzlicher Leitungen. Da x86-Befehle variabel lang sind, muss der Dekodierer acht aufeinanderfolgende Instruktionen parallel abschätzen und zerlegen, ohne vorab zu wissen, an welcher Stelle der vorangegangene Befehl endet. Allein diese aufwendige Vorhersage- und Segmentierungslogik verschlingt erhebliche Chipfläche und Transistoren.
Auch das Integer-Backend wurde entsprechend massiv ausgebaut. In früheren Architekturen stemmten vier Integer-ALUs (Arithmetic Logic Units) die zentralen Rechenaufgaben; nun wurde ihre Anzahl auf sechs aufgestockt. Dadurch verarbeitet der Chip pro Zyklus wesentlich mehr Basisoperationen parallel, was den Durchsatz der Ausführungs-Pipelines spürbar in die Höhe treibt.
 Abb.: Ein AMD-Ryzen-Prozessor auf einem Mainboard. Quelle: Wikimedia Commons, CC0
Über 400 Out-of-Order-Befehle: Das Blickfeld des Schedulers verdoppelt sich
Breitere Ausführungseinheiten sind nur der halbe Weg; die eigentliche ingenieurtechnische Herausforderung besteht darin, diese Pfade permanent mit Arbeit zu versorgen. Moderne Hochleistungsprozessoren setzen auf Out-of-Order-Ausführung (OoO): Sie analysieren den nachfolgenden Programmcode voraus, identifizieren voneinander unabhängige Aufgaben und berechnen diese vorab. Diese Vorausschau entscheidet darüber, ob die zusätzlichen Integer-ALUs voll ausgelastet rechnen oder untätig Strom verheizen.
Die Schlüsselkomponente, die den Horizont dieser Vorausschau bestimmt, ist der Reorder Buffer (ROB). Unter Zen 3 fasste dieser Puffer 256 Befehle. Bei verschachtelter Programmlogik oder zeitintensiven Speicherzugriffen stieß das Blickfeld des Schedulers schnell an Grenzen, sodass Ausführungseinheiten mangels unabhängiger Instruktionen pausieren mussten.
In Zen 5 wurde die Kapazität des Reorder Buffers auf 448 Einträge aufgestockt. Dank dieses gigantischen Puffers kann der Prozessor fast 500 Instruktionen gleichzeitig in der Schwebe halten und auf komplexe Abhängigkeiten prüfen. Dem Scheduler steht damit ausreichend Manövrierraum zur Verfügung, um aus verschlungenen Code-Strömen parallelisierbare Rechenaufgaben herauszufiltern.
Ist das Befehlsfenster derart großzügig dimensioniert, verharrt der Chip bei einem Cache-Miss nicht mehr in Leerlaufzyklen, während Daten über Hunderte von Takten aus dem Hauptspeicher nachgeladen werden. Stattdessen schöpft der Scheduler aus dem Pool von über 400 Kandidaten unabhängige Aufgaben und hält die Recheneinheiten während der Wartezeit lückenlos beschäftigt.
| Prozessormodell | Architektur | Erscheinungsjahr | Single-Core-Score | Max. Boost-Takt | Integer-ALUs | Reorder-Buffer-Kapazität |
|---|---|---|---|---|---|---|
| Ryzen 7 5800X3D | Zen 3 | 2022 | 2.016 Punkte | 4,5 GHz | 4 | 256 Einträge |
| Ryzen 7 7800X3D | Zen 4 | 2023 | 2.426 Punkte | 5,0 GHz | 4 | 320 Einträge |
| Ryzen 7 9800X3D | Zen 5 | 2024 | 2.969 Punkte | 5,2 GHz | 6 | 448 Einträge |
Verdoppelte Datenpfade: Keine Recheneinheit soll auf Daten warten
Das Anwachsen der Rechenkapazitäten und Planungsfenster stellt unweigerlich extreme Anforderungen an das Speichersubsystem. Hält der Datentransport nicht mit dem Befehlsdurchsatz Schritt, verhungern selbst die breitesten Recheneinheiten. Daher war der Ausbau der Cache-Hierarchien und die Verbreiterung der internen Datenbusse die zwingende Konsequenz aus der gesteigerten Rechenleistung.
Der direkt an den Rechenkernen anliegende L1-Daten-Cache wuchs von 32 KB auf 48 KB, während der exklusive L2-Cache pro Kern von 512 KB auf 1 MB verdoppelt wurde. Diese extrem schnellen Caches stellen sicher, dass häufig benötigte Daten innerhalb weniger Taktzyklen bereitstehen, wodurch langwierige Zugriffe auf das RAM drastisch reduziert werden.
Im Bereich der Gleitkomma- und Vektorberechnungen fällt die Verbreiterung noch deutlicher aus: Setzten Zen 3 und Zen 4 auf vier 256-Bit-SIMD-Recheneinheiten, spendierte AMD Zen 5 vier vollwertige 512-Bit-Einheiten. Die verdoppelte Breite erlaubt es, mit einer einzigen Instruktion 16 einfachgenaue Gleitkommazahlen simultan zu bearbeiten – ein unmittelbarer Schub für wissenschaftliche Berechnungen und lokale LLM-Inferenz.
Um diesen Datenhunger zu stillen, wurden auch die Speicherpfade im gleichen Maßstab aufgerüstet. Die neue Architektur bewältigt pro Takt zwei 512-Bit-Load- und eine 512-Bit-Store-Operation. Dank dieser gewaltigen Busbandbreite und der verdoppelten Caches hält die Datenbereitstellung mit den gewachsenen Recheneinheiten Schritt.
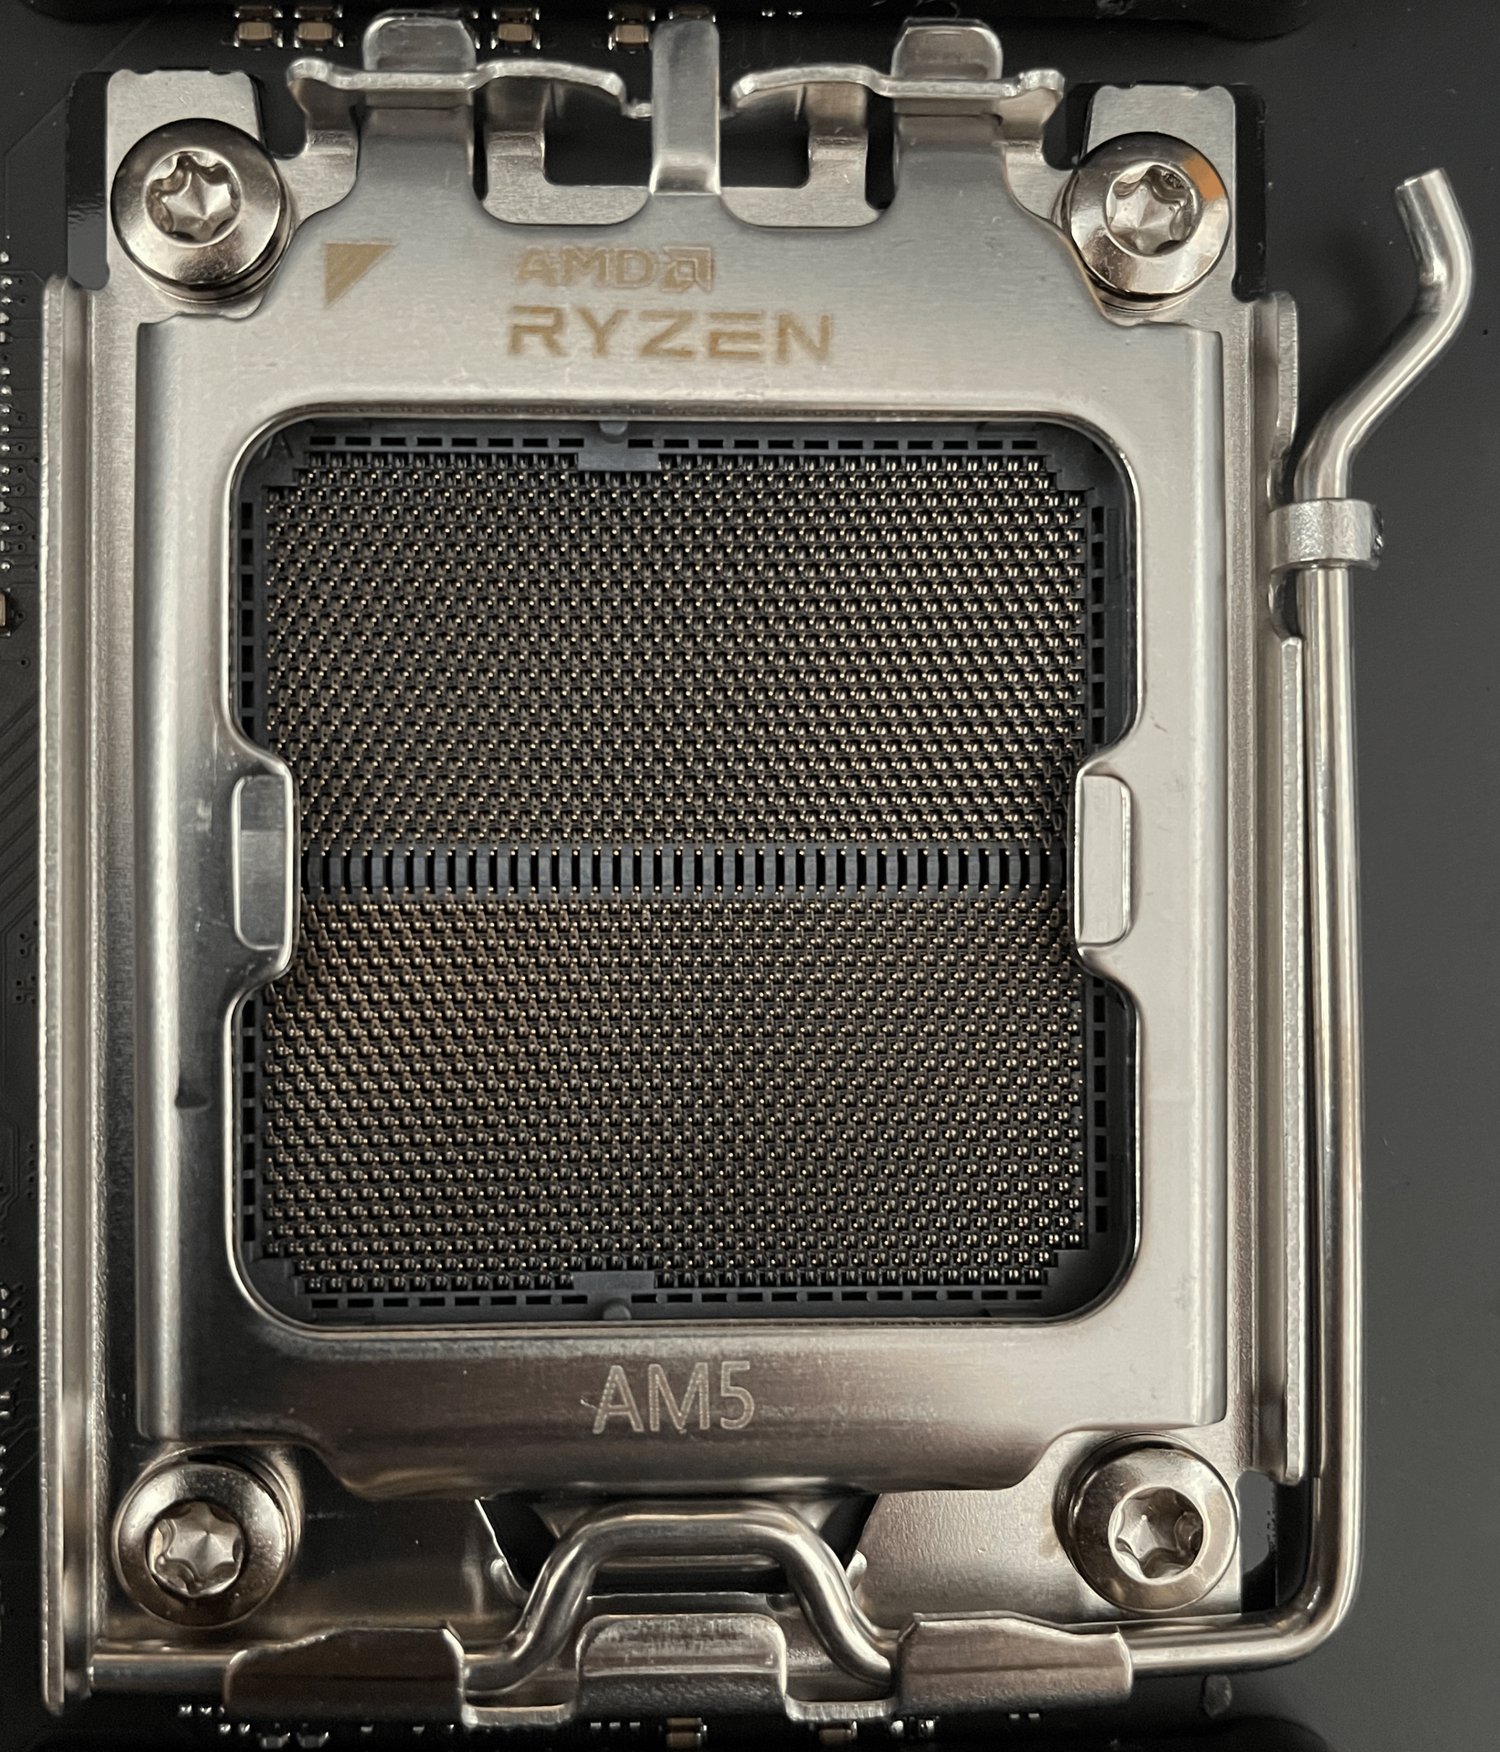 Abb.: Der AMD-AM5-Prozessorsockel. Quelle: Wikimedia Commons, CC BY-SA 4.0
Geschwindigkeit durch schiere Transistormasse: Wer zahlt die Rechnung für die Abwärme?
Der Weg, Leistung durch physische Skalierung zu erzwingen, fordert seinen Tribut. Fünf Milliarden zusätzliche Transistoren bedeuten, dass selbst ohne Takt-Rekordversuche die statische Leckage und die Leistungsaufnahme auf hohem Niveau bleiben. Die thermische Dichte auf dem Silizium steigt rasant – herkömmliche Luftkühler stoßen bei diesen abrupten Hitzeausbrüchen zunehmend an ihre Belastungsgrenzen.
Im Grunde haben die Chipdesigner die gewaltigen Herausforderungen der Wärmeabfuhr und die Kosten für teure Siliziumflächen an Mainboard-Spannungswandler (VRMs) und Kühllösungen delegiert. Ein praktisches Problem bleibt: Die breiteren Ausführungspfade und gigantischen Befehlsfenster schlagen sich nur dann in Benchmark-Rekorden nieder, wenn die Software tatsächlich Parallelität bietet. Läuft strikt sequenzieller Code, bleiben die zusätzlichen Rechenwerke ungenutzt – verbrauchen aber weiterhin Strom und erzeugen Hitze.
Über Jahre hinweg lieferten sich Intel und AMD ein Wettrennen um immer mehr Prozessorkerne. Ein reines Aufstocken der Kerne beschleunigt jedoch keine latenzkritischen Single-Thread-Aufgaben. AMDs Entscheidung, das Kerninnere grundlegend umzugestalten und die IPC über eine breite Architektur nach oben zu schrauben, hat das bisherige Dogma des bloßen Kern-Häufens durchbrochen.
Die Behauptung, die CPU-Entwicklung stagniere, greift zu kurz; sie hat lediglich die Spur gewechselt. Wenn Taktfrequenzen an Grenzen stoßen, wird Fortschritt durch ungleich komplexere Architekturen erkauft. Für die kommende Generation auf Zen-6-Basis stehen bei Serverchips bereits 256 Kerne und sagenhafte 1 GB L3-Cache im Raum. Das Wachstum der Rechenleistung geht weiter – doch jeder neue Sprung verlangt nach potenterer Kühlung und schlägt sich spürbar auf der Stromrechnung nieder.
Weiterführende Links:
- How did AMD Ryzen get 50% faster in two years?
- HN-Diskussion (item?id=49758709)