2026 年 10 月 12 日,Intel 在 OCP 全球峰会上正式发布数据中心推理 GPU D270。这块代号 Crescent Island 的加速卡拥有高达 480GB 的显存容量,显存带宽则设定在 1.5TB/s。主流方案普遍堆砌 8TB/s 级 HBM 显存,Intel 则选择用低功耗内存组合出破纪录的容量。这种设计直接将竞争焦点从单纯的峰值带宽引向了单卡承载能力。
智能体架构普及让大模型推理的瓶颈发生转移。数十万 token 的长提示词正在撑爆 KV 缓存。超大 MoE 架构更让多卡并行的网络通信居高不下。
D270 的核心赌注正在于此。它用 480GB 显存解决装不下的问题,并以 350W 风冷规格降低部署门槛。
480GB 塞进 350W 风冷卡:用廉价容量换昂贵带宽
从硬件规格来看,D270 呈现出鲜明的非对称特征。卡上搭载了 20 颗 LPDDR5X 颗粒。它拥有 80 个物理通道与 1280-bit 显存位宽,在 9375MT/s 速率下提供 1.5TB/s 显存带宽。
官方公版卡标配 160GB 显存。合作 ODM 厂商通过采用 24GB 单颗粒密度,将单卡最大容量推至 480GB。480GB 创下了当前所有双槽 PCIe 规格加速卡的最大容量纪录。
每个硬件参数的取舍都对应着严苛的成本核算。从公开的物料结构看,HBM3e 的单位容量成本远高于 LPDDR5X,还要额外占用紧缺的先进封装产能。
LPDDR5X 能够直接贴装在普通 PCB 板卡上,无需昂贵的中介层与基板制造工序。Intel 放弃了 80% 的峰值显存带宽。作为交换,它拿到了三倍于竞品单卡的内存容量与更低的制造成本。
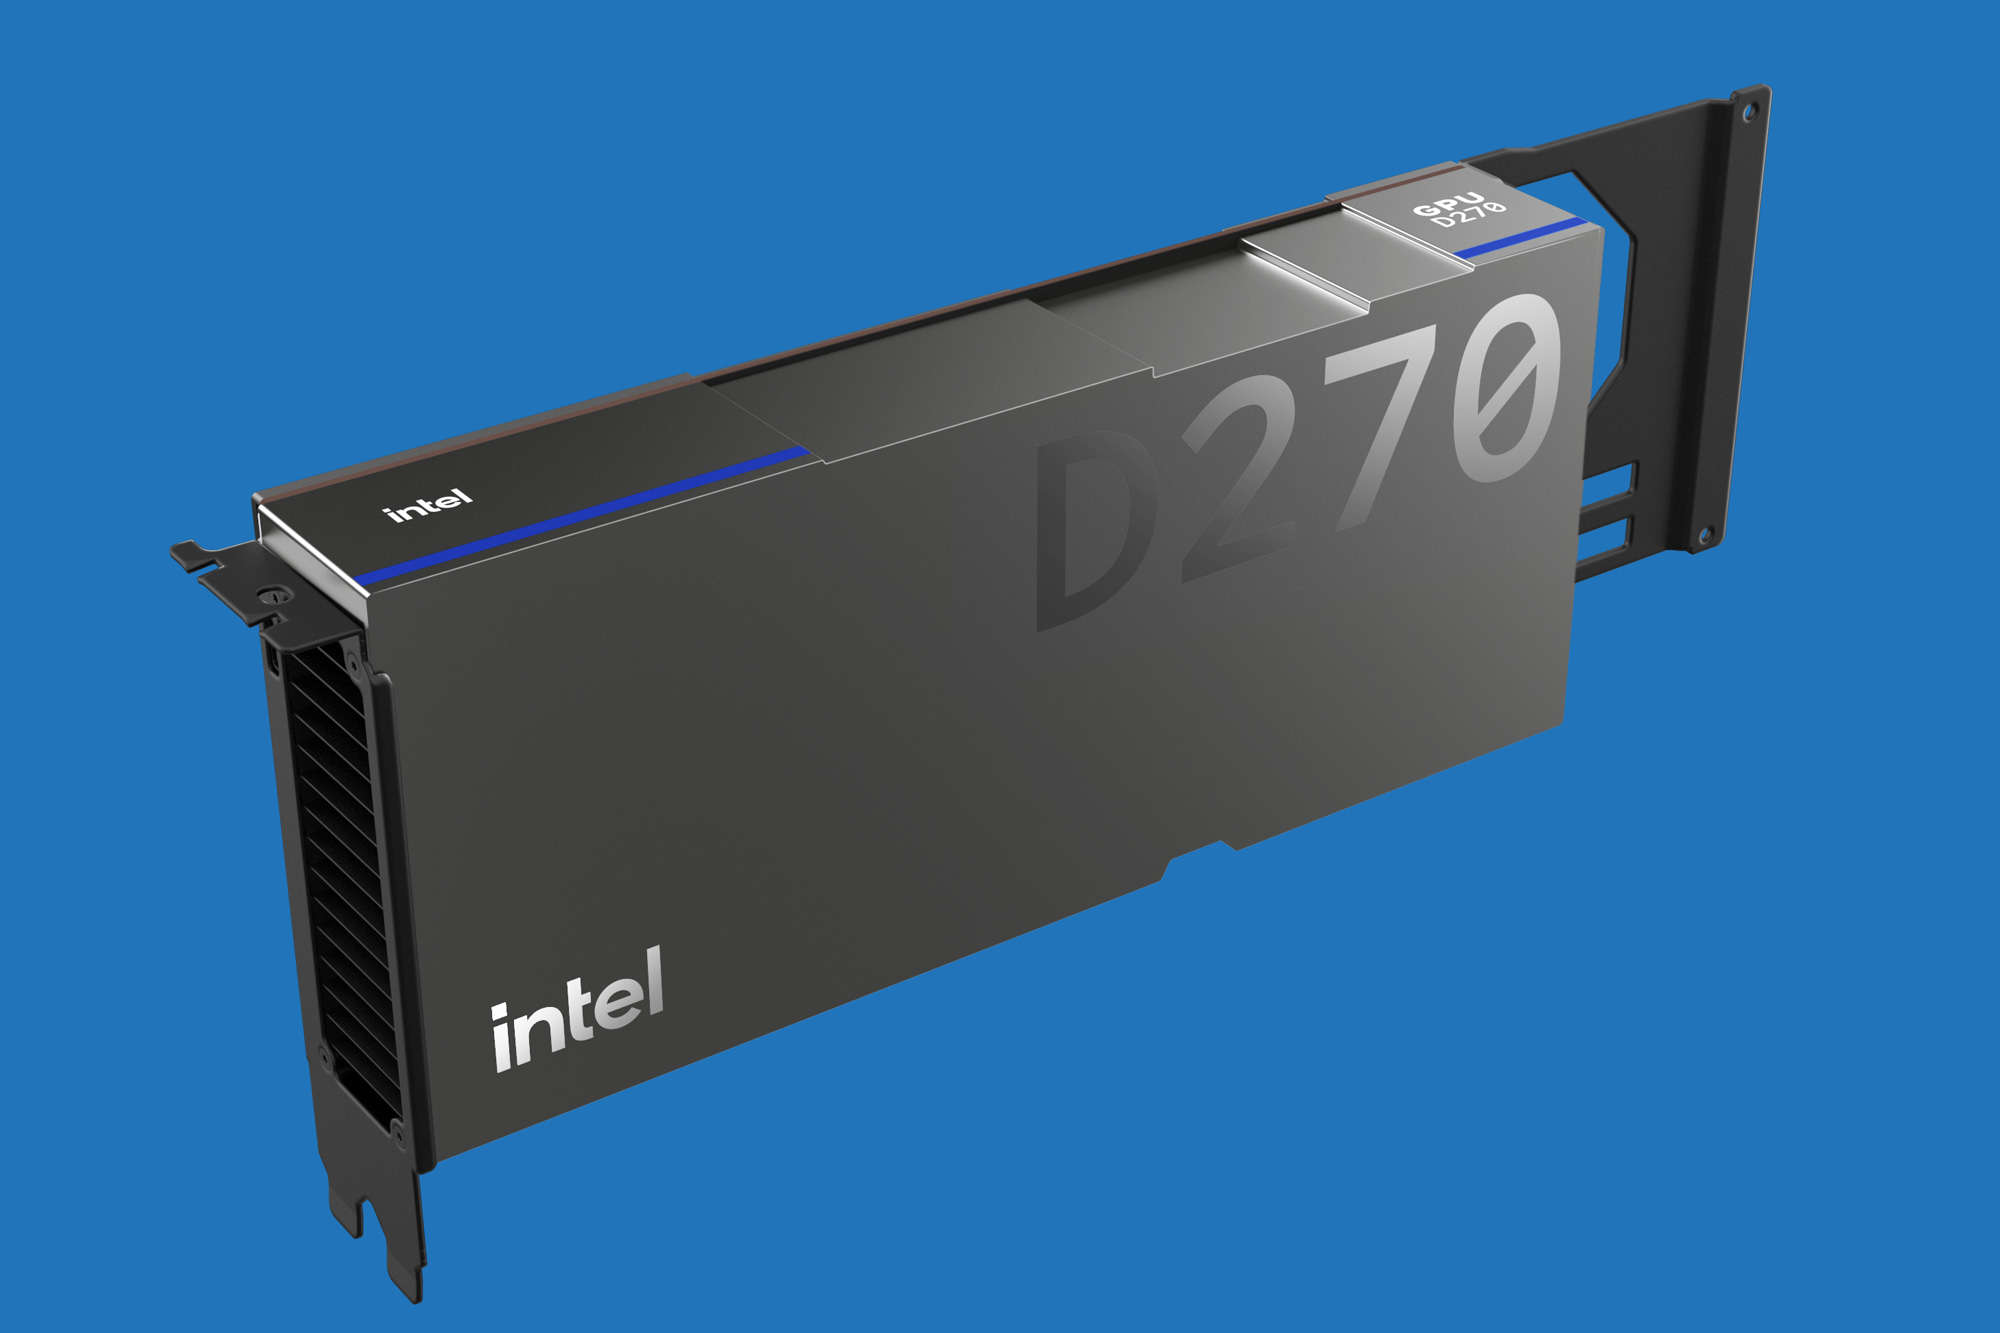 图:Intel GPU D270 官方渲染图,采用标准双槽风冷卡形态。来源:ServeTheHome(转自 Intel 官方物料)
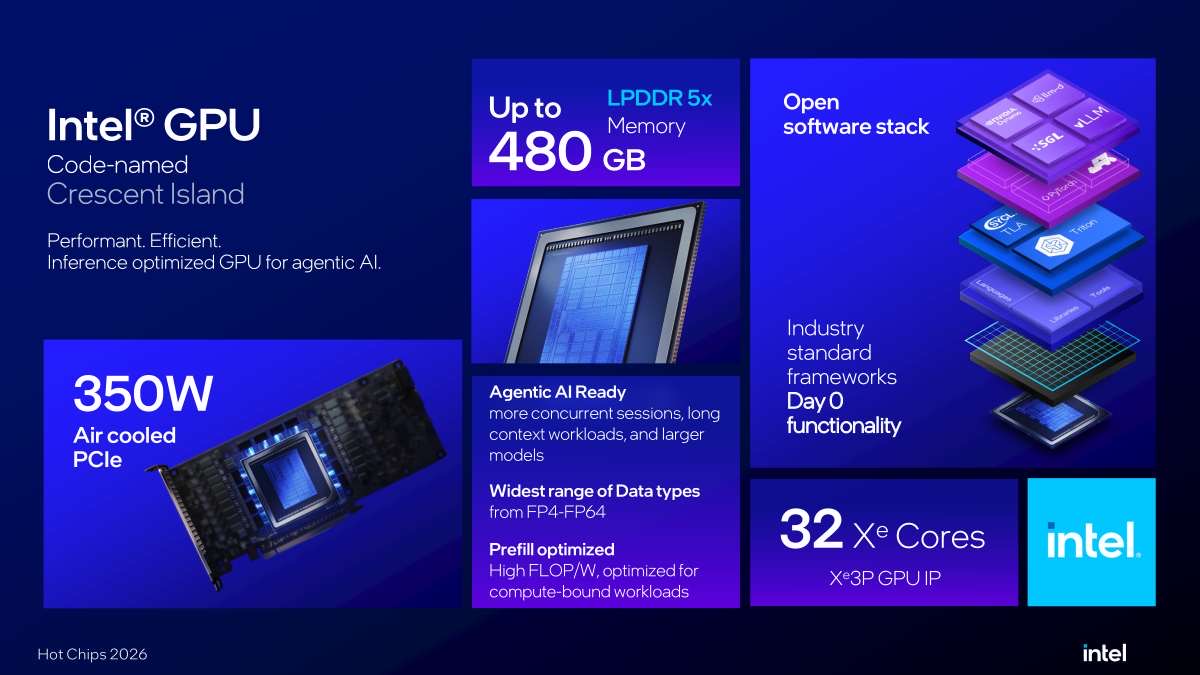 图:Hot Chips 2026 幻灯片展示的 80 通道 LPDDR5X 内存子系统。来源:ServeTheHome(转自 Intel 演示文稿)
砍掉两代旗舰后,Intel 放弃了正面对轰 HBM
D270 是 Intel 在数据中心 AI 硬件领域沉寂数年后的关键一击。自 2021 年推出 Ponte Vecchio 以来,Intel 在高端数据中心 GPU 上屡遭挫折,先后取消了 2023 年的 Rialto Bridge 与 2025 年的 Falcon Shores。两次路线图的剧烈调整付出了沉重代价。在千瓦级液冷算力上硬拼旗舰,让 Intel 吃尽了苦头。
D270 主动收缩战线,将定位收窄在推理任务上。芯片采用 Xe3P 架构,集成 32 个 Xe 核心与 256 个 XMX 矩阵引擎。其运行频率约为 2.5GHz。
其 FP8 稠密矩阵算力为 1.3 PFLOPS,FP64 算力降至 10.2 TFLOPS,并配备 32MB L2 缓存。芯片去掉了通用超算所需的双精度冗余。这种取舍让功耗得以锁死在 350W 风冷红线之内。
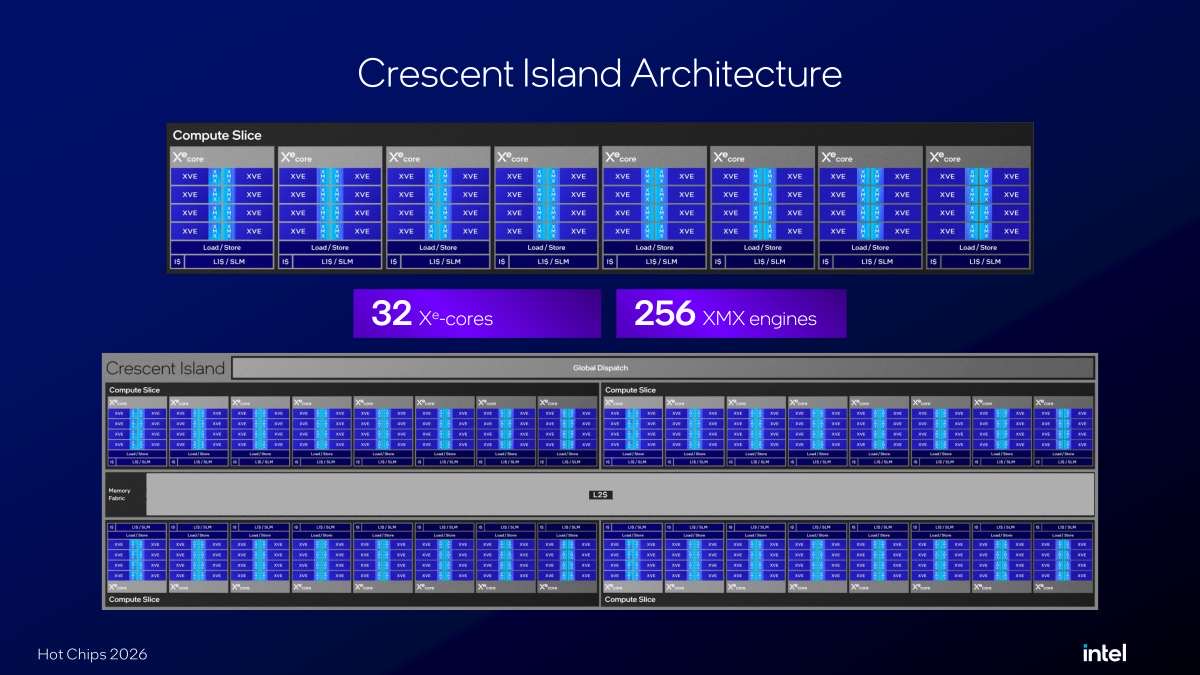 图:Hot Chips 2026 披露的 Crescent Island 计算架构。来源:ServeTheHome(转自 Intel 演示文稿)
1.5TB/s 能否跑顺超大 MoE 推理
在推理流水线中,480GB 的容量优势在 MoE 架构下尤为突出。社区讨论点名了 DeepSeek V4 系列这类超大稀疏模型:总参数量庞大,但每个 token 只激活少数专家。单卡装不下时,多卡切分会让跨卡通信变成实打实的负担。
D270 单卡 480GB 能够完整装入超大模型权重。它直接省去了跨节点张量并行通信。无通信干扰的单卡执行大幅简化了集群拓扑。
其 1.3 PFLOPS 的 FP8 矩阵算力约为 RTX 5090 的两倍。在自回归生成的解码阶段,每一步读取权重都受制于显存吞吐。长上下文的 KV 缓存容量更是关键瓶颈。
充沛的显存允许单卡容纳更大的批处理并发量,从而拉高整体吞吐。这为需要长程多轮对话的智能体应用提供了充足的内存驻留空间。
但是低带宽并非没有代价。在提示词输入阶段,计算单元需要极高的数据吞吐。缺乏足够显存带宽喂饱计算核心,算力利用率就会下滑。
1.5TB/s 的带宽水平接近高端消费级统一内存方案。面对 10 万 token 以上的超长输入,首字延迟很难匹敌 HBM 方案。对于密集型模型,低带宽更会直接压低解码阶段的生成速率。
数据中心算力账本:标准机柜拒绝千瓦液冷
硬件能耗与物理形态构成了企业采购决策的另一道门槛。D270 采用 PCIe Gen5 x16 双槽形态,TDP 仅为 350W。它依靠服务器内部标准风道即可完成散热。
作为对比,同属 PCIe 风冷形态的 AMD MI350P 拥有 2.3 PFLOPS 算力,功耗攀升至 600W。在常规风冷机箱内,600W 已经逼近散热极限。机房往往需要定制专用风道,甚至被迫降低插卡密度。
对于大量存量数据中心而言,千瓦级液冷改造是沉重的资本开销。高密度液冷模块要求改造机房管道与室外冷却塔。单机柜的初期基建投入往往达到数万美元。
D270 能够直接插入现有的通用服务器机架。它无需改动机房的电力分配单元与制冷设施。在衡量企业实际部署效益时,每瓦产生的有效 Token 数量远比理论峰值算力更加真实。
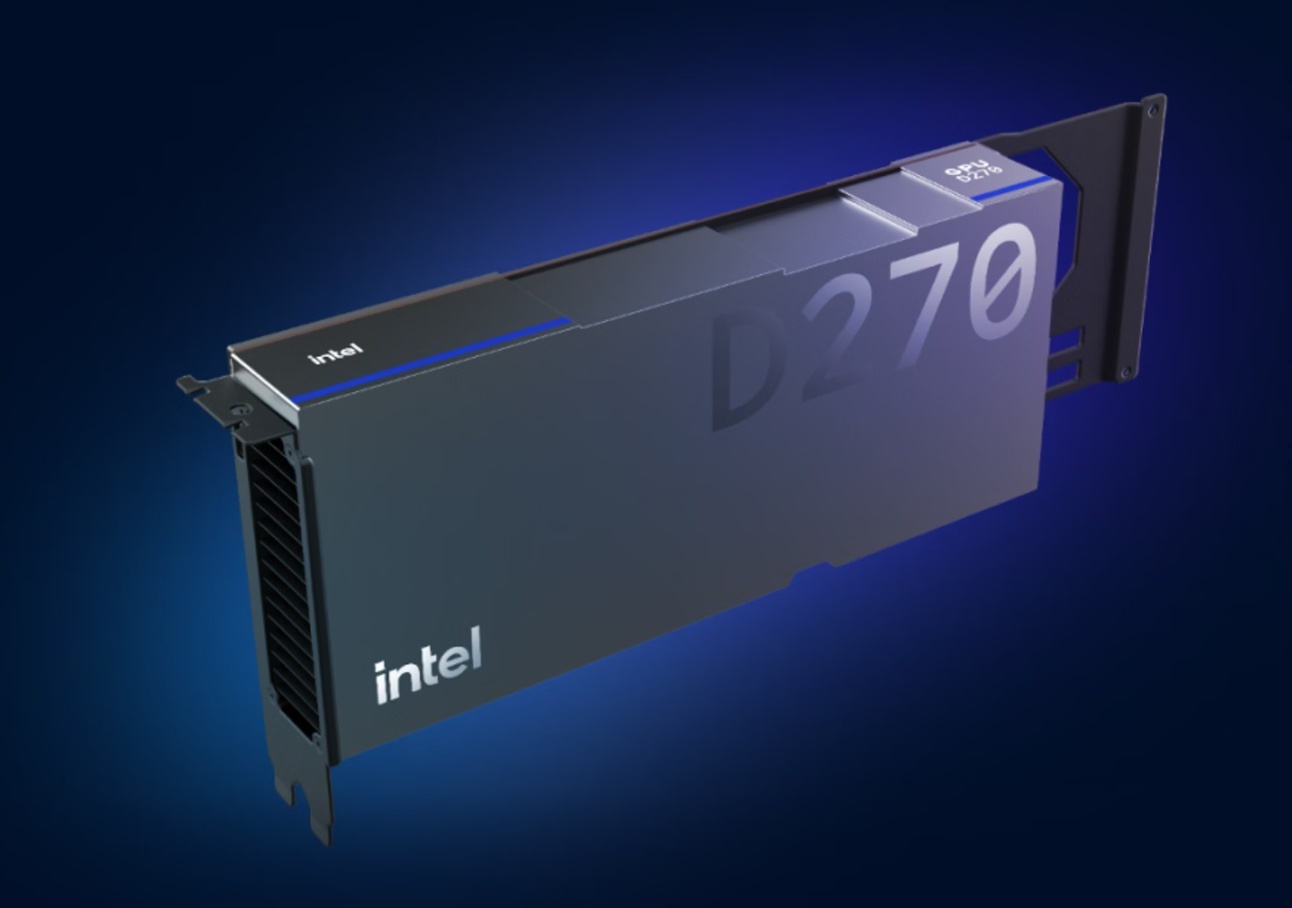 图:Notebookcheck 曝光的 D270 实体工程样品外观。来源:Notebookcheck
2027 年落地前,生态栈决定它能否摆脱样品宿命
硬件纸面参数的成立,并不等于商业化落地的成功。Intel 目前已向核心客户开启送样。但据行业媒体 ServeTheHome 评估,大规模商用出货需要等到 2027 年。
在季度级迭代的 AI 芯片市场,送样到量产的时间窗口偏长。这给竞争对手留出了充足的产品反扑周期。到 2027 年,竞品新一代推理架构将全面铺开。D270 面临的容量领先优势也会被逐步压缩。
软件生态的适配效率同样是左右胜负的关键。长期以来,Intel 的 oneAPI 与 PyTorch 扩展库在开发者社区的成熟度落后于主流方案。软件栈的工程易用性历来是其薄弱环节。
vLLM 和 SGLang 等开源推理框架已成为行业基准。对这些框架的开箱支持程度,直接决定了客户是否买单。底层驱动与编译器必须抹平调度复杂性,否则庞大显存无法转化为实际吞吐。
Intel D270 代表了一种务实的工程折中路线。它用 480GB 显存承接长上下文,再用 350W 风冷配置匹配现成机架。当推理竞争转向综合持有成本,装得下且部署得起的硬件才能真正站稳脚跟。
参考链接:
- ServeTheHome 报道:Intel Crescent Island 发布与 D270 规格详解。
- Intel 官方新闻稿:OCP 2026 数据中心 GPU D270 正式发布。
- Hot Chips 2026 技术演示:Crescent Island 架构与 LPDDR5X 内存子系统。
- Notebookcheck 报道:Intel 携 480GB 显存显卡重返数据中心。