全通过率 19.2%:能交初稿,交不出签字意见
19.2%,这是国产 AI 往律所流水线里插进去之后拿到的全流程通过率。2026 年 10 月 12 日,智谱 AI 发布面向法律场景的智能体模型 GLM-Legal。在覆盖 24 个执业领域的 Harvey LAB 测试中,这项指标比它的基座模型提升了 12.5 个百分点。即便如此,八成以上的复杂任务依然被挡在门外。
这套「全过」评分(all-pass rate)要求模型在一条完整任务链上全程零退化。12.5 个百分点的增幅说明专业领域的后训练确实有效,19.2% 的终点线则划出了清醒的边界。它交得出结构齐整的合规初稿,交不出能直接盖章生效的法律意见书。
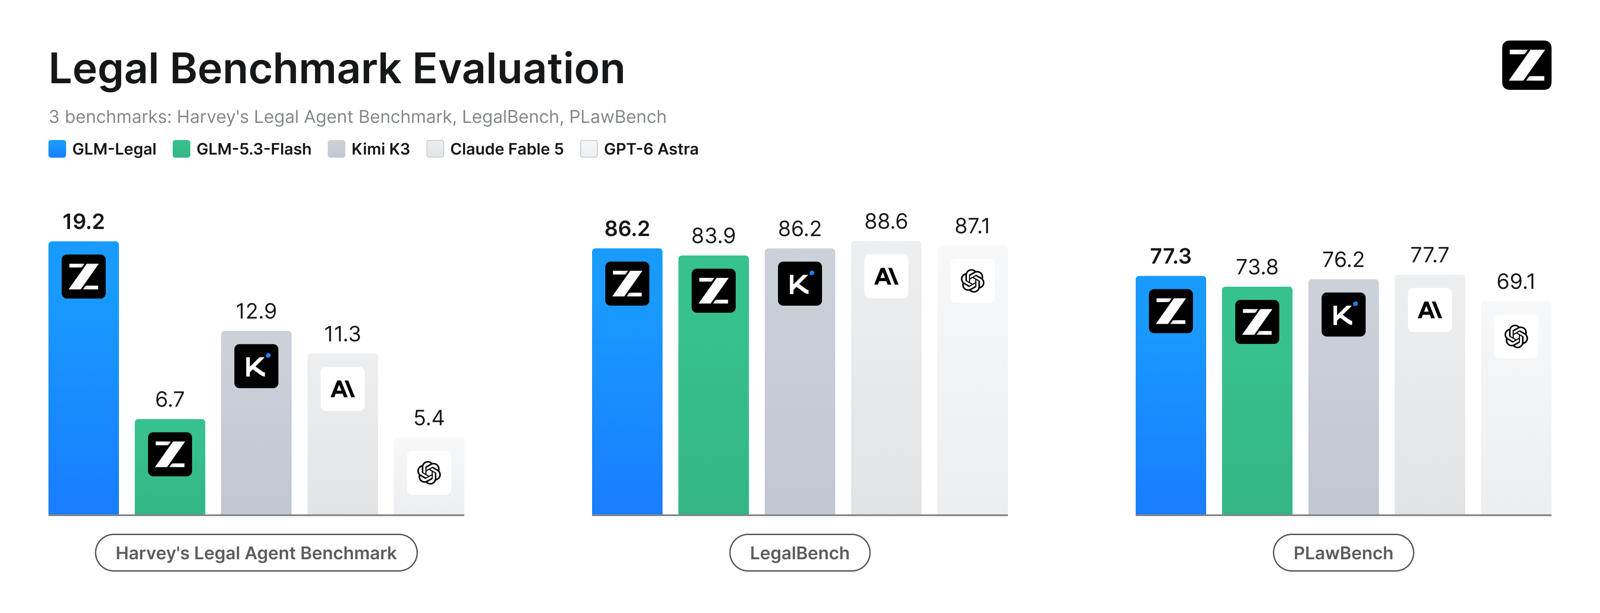 图:GLM-Legal 在复杂执行、法律推理与真实文书起草三轴上的官方基准表现。来源:智谱 z.ai 官方博客
厂商把这类能力称作「专业协作」。智谱公布的对比图里,GLM-Legal 在复杂执行、法律推理、真实文书起草三个轴上都咬住了前排系统。产出这一侧的成本正在往下掉,顶在风口浪尖的,是握着签字笔的那个人。
法律链路容不下半点幻觉
写代码时的错误相对好抓:程序跑起来要么抛异常,要么被测试用例逮住。到了诉讼里,漏掉一个时效、把举证责任搞反,代价可能是整场官司。
合同里的错误更难发现。一条措辞模糊的赔偿条款签下去不会立刻发作,等到真正打起来才结算。这种「错得晚」的特性,把法律对准确性的要求推得比其他知识工作都高。
智谱把法律工作概括成一条链:事实、法条、推理、可交付成品,四段必须首尾闭合。系统要从几百页材料里提出争议点,搭起能辩护的论证,最后再按任务规格排版。中间任何一段脱节,整份文书就是废纸。
基准结果也印证了这条链的难度。在解析专业合同、并购申报文件和司法意见的 LegalBench 上,GLM-Legal 与顶级闭源前沿系统打平;在中文法律咨询基准 PLawBench 上同样站在前排。这两项成绩的参照系是参数规模,它用瘦得多的体量做到了同样的分数。
轻量模型做强化学习,把法条变成执行清单
GLM-Legal 建在轻量基座 GLM-5.3-Flash 上,官方强调它的参数规模显著更小。小体量意味着私有化部署的门槛更低,律所日常调用的算力开销也更容易算清账。
中间训练阶段,团队扩充了高质量法律语料,把「事实—规则—结论」的演绎连接压实。后训练阶段,模型被放进数万个真实法律环境里做强化学习,与运行时编排框架(Harness)一起迭代——框架暴露模型的短板,模型反过来指认框架的瓶颈。
从业者给输出定了四类验收标准:关键问题和边缘情形是否都覆盖,论证是否有据、引用是否站得住,成品是否严格贴合任务要求,下游团队能不能拿来就用而不返工。最后一条最狠,它把主观的「写得怎么样」变成了可以计量的返工损失。
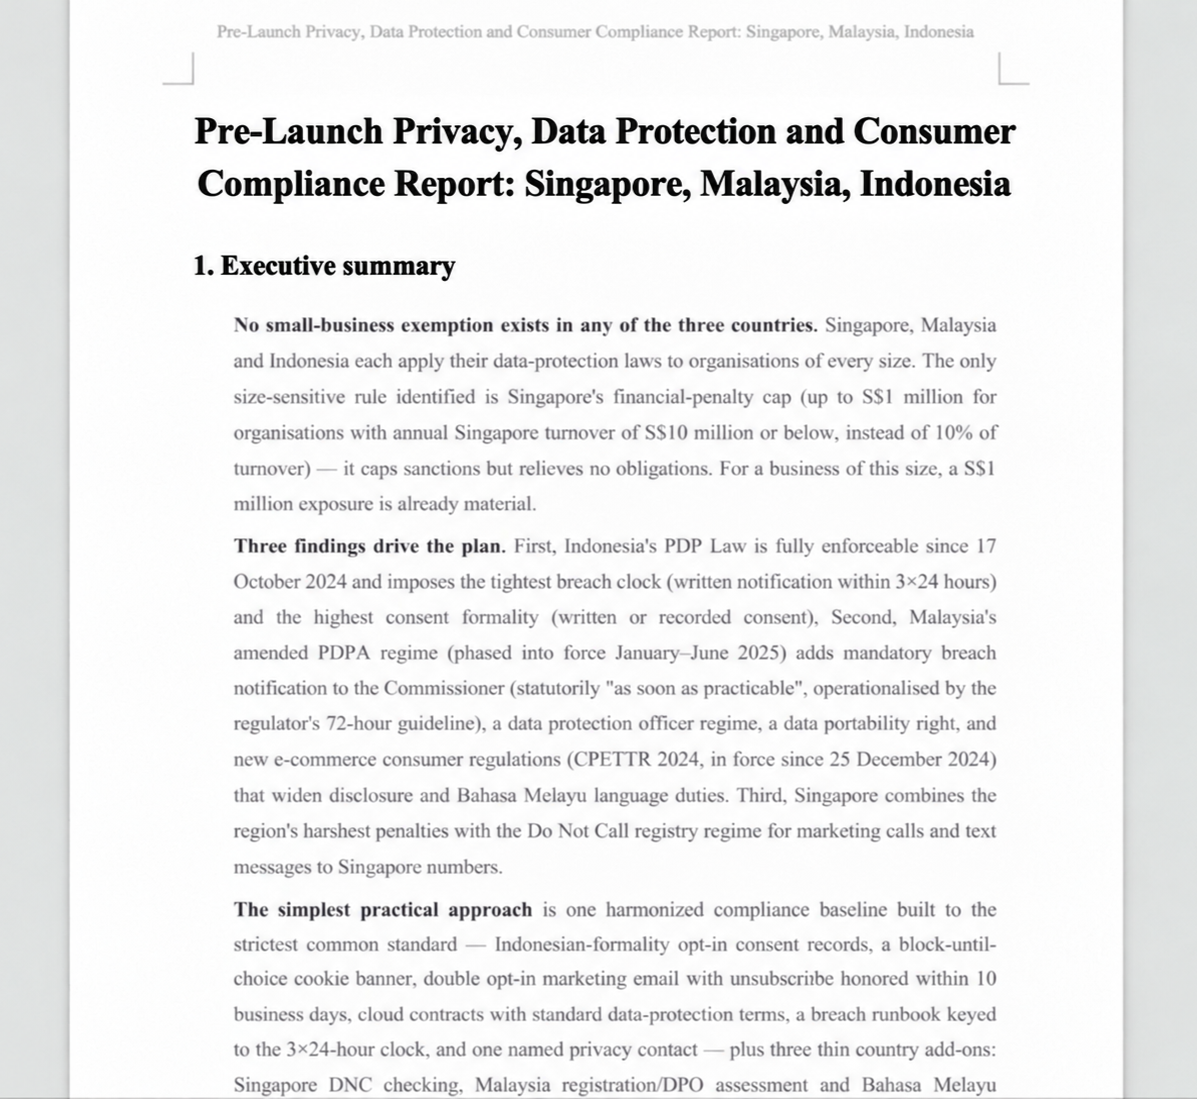 图:跨境发布隐私合规清单把抽象法条拆解为具体执行步骤。来源:智谱 z.ai 官方博客
上面这张就是官方给的落地样本:一份跨境上线的隐私合规要求,被拆成按国家排列的执行步骤,再配一份 P0 待办清单。依托 AutoClaw,用户输入业务背景,拿到的是能直接派下去的活。
模型写错不会被吊销执照,签字律师必须负全责
技术指标往上走,执业现实里的张力却没跟着走。技术社区的讨论里,有人描述自己每月付给一家大所 500 美元的最低计费,收到的一封进度邮件明显由 AI 生成、且不作披露,还经常漏掉或混淆关键细节。
更危险的是凭空编造判例和裁判要旨。模型偶尔会虚构先例,如果复核的律师没抓住就提交法庭,等着的是一次司法制裁,而程序的回应是礼貌地承认「您说得对,我不该编造一个不存在的案子」。惩罚链的末端永远站着人,代码不在链上。
有人把这类工具类比成当年的法律检索数据库,认为风险被夸大了。这里的差别在于定位:数据库只负责把候选材料摊开,论证结构仍然由律师搭;agent 交付的是成品,从检索到成文一整套。引用、格式、结论都可能由模型定,责任却只能由签名的人扛。
产出成本趋近于零,签字那支笔反而更沉
起草一份长文书的边际成本正在往零靠。对应的后果是律师面前的初稿数量成倍上涨,而校对的时间一分钱都省不下来。产出可以无限加速,确认产出做对了什么不行。
有人预测律师会因此过上轻松的好日子,也有人看到相反的方向:质量拉不开差距之后,竞争会转向数量,律所会推着律师签更多的东西——责任还是个人的,阅读时间却被压缩。看得越少、签得越多,是这个模式最自然的滑坡。
GLM-Legal 的 19.2% 是一次扎实的工程进展,它证明专用小模型靠数据重构和强化学习,能在最不容错的专业领域交出可用初稿。这项技术的落点却从一开始就压在责任分配上。
法律文书的效力从来不取决于它生成得多快。每一份生效的意见书背后,都是律师用职业执照做的背书。机器负责出草稿,人承担后果——在责任能被分摊之前,握着签字笔的手只会比过去握得更紧。
参考链接:
- 智谱 z.ai 官方博客
- Harvey LAB 评测基准说明
- Hacker News 社区讨论