Un taux de réussite globale de 19,2 % : bon pour un premier jet, loin d’une consultation signable
19,2 % : c’est le taux de validation de bout en bout obtenu par un modèle d’IA intégré au flux de travail d’un cabinet juridique. Le 12 octobre 2026, Zhipu AI a levé le voile sur GLM-Legal, un modèle d’agents conçu pour la pratique du droit. Sur le banc d’essai Harvey LAB, qui couvre 24 domaines de compétence, ce score représente un gain de 12,5 points de pourcentage par rapport à son modèle de base. Pourtant, plus de 80 % des tâches complexes restent hors de portée.
Cette métrique d’admission totale (“all-pass rate”) impose au modèle de franchir l’intégralité d’une chaîne de travail complexe sans la moindre défaillance. Si le bond de 12,5 points atteste de l’efficacité d’un post-entraînement spécialisé, le plafond des 19,2 % pose une limite implacable. L’outil sait agencer un premier projet de conformité rigoureux, mais s’avère incapable de produire une consultation juridique prête à être scellée et signée.
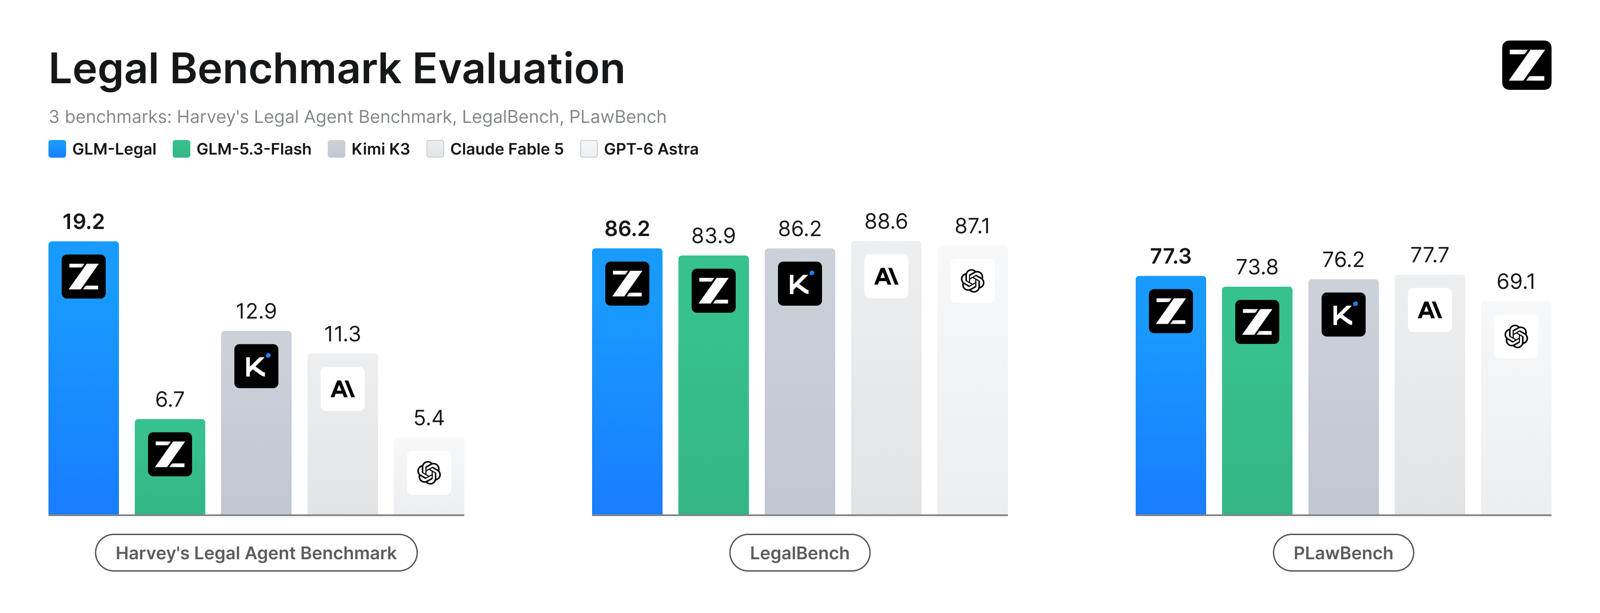 Figure : Performances officielles de GLM-Legal sur les trois axes : exécution complexe, raisonnement juridique et rédaction en conditions réelles. Source : Blog officiel de Zhipu z.ai
Les éditeurs qualifient ces aptitudes de “collaboration professionnelle”. Sur les graphiques diffusés par Zhipu, GLM-Legal rivalise avec les meilleurs systèmes de pointe sur trois axes : l’exécution complexe, le raisonnement juridique et la rédaction de documents concrets. Alors que le coût de production s’effondre côté génération, c’est celui qui tient la plume qui se retrouve en première ligne.
Le raisonnement juridique ne tolère aucune hallucination
Débusquer une anomalie dans du code est relativement simple : le programme lève une exception à l’exécution ou se fait coincer par les suites de tests. En contentieux, en revanche, omettre un délai de prescription ou inverser la charge de la preuve peut ruiner l’issue d’un procès tout entier.
Les failles contractuelles sont plus pernicieuses encore. Signer une clause d’indemnisation rédigée de manière imprécise ne produit aucun dommage immédiat ; la catastrophe n’éclate que des années plus tard, en plein litige. Cette nocivité différée impose au droit une exigence d’exactitude bien supérieure à celle de toute autre activité intellectuelle.
Zhipu résume la démarche juridique en une chaîne continue : les faits, la règle de droit, la subsomption et le livrable final. Les quatre maillons doivent former une boucle parfaitement close. Le système doit dégager les points de controverse de centaines de pages de conclusions, bâtir une argumentation solide et mettre en page l’acte selon le cahier des charges. Qu’un seul chaînon se rompe, et l’acte entier n’est plus qu’un chiffon de papier.
Les évaluations illustrent la difficulté de l’exercice. Sur LegalBench, qui sonde l’analyse de contrats, les notifications de fusions-acquisitions et les décisions de justice, GLM-Legal a fait jeu égal avec les meilleurs modèles propriétaires ; il figure aussi en tête sur PLawBench pour le conseil juridique en chinois. L’exploit réside surtout dans le fait d’avoir atteint de tels résultats avec un volume de paramètres bien plus modeste.
Apprentissage par renforcement sur modèle léger : transformer les lois en plans d’action
GLM-Legal s’appuie sur une fondation compacte, GLM-5.3-Flash, l’équipe insistant sur sa taille de paramètres réduite. Cette compacité abaisse le seuil de déploiement en réseau privé sur site et permet aux cabinets de maîtriser leurs coûts de calcul quotidiens.
Durant l’entraînement intermédiaire, l’équipe a densifié les corpus juridiques de haute volée afin de verrouiller l’enchaînement déductif “faits–règles–conclusions”. Lors du post-entraînement, le modèle a suivi un apprentissage par renforcement dans des dizaines de milliers d’environnements juridiques simulés, évoluant en symbiose avec son cadre d’orchestration à l’exécution (Harness) : le cadre révélait les angles morts du modèle, et le modèle pointait les goulots d’étranglement du cadre.
Les praticiens ont fixé quatre critères d’admission sans compromis : exhaustivité sur les points de droit majeurs et les cas limites ; rigueur de l’argumentation et fiabilité des références ; conformité stricte aux exigences du livrable ; et exploitabilité immédiate par les équipes en aval sans reprise. Ce dernier critère est le plus sévère : il transforme l’appréciation subjective de la “qualité de style” en un préjudice mesurable de reprise de travail.
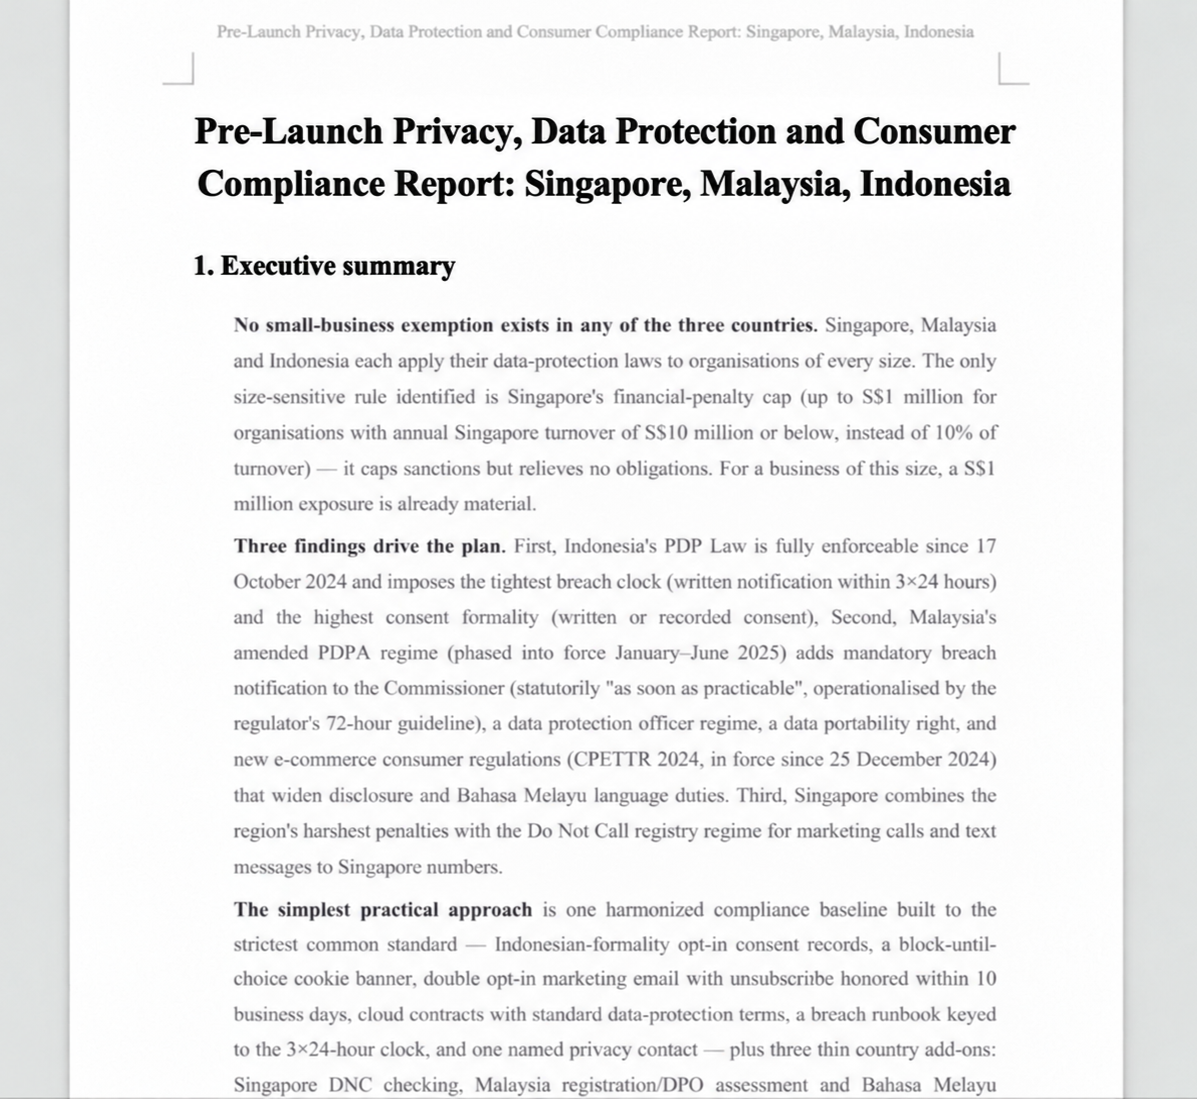 Figure : La liste de conformité décompose les règles abstraites en étapes concrètes d’exécution. Source : Blog officiel de Zhipu z.ai
Le visuel ci-dessus présente un cas d’usage officiel : les exigences de confidentialité pour un lancement transfrontalier, déclinées par pays et assorties d’une liste de tâches prioritaires P0. Grâce à AutoClaw, l’utilisateur soumet son contexte opérationnel et obtient des directives prêtes à être immédiatement déléguées.
Les modèles ne sont pas radiés du barreau : l’avocat signataire assume tout
Tandis que les courbes techniques s’envolent, la tension sur le terrain ne retombe pas. Dans les discussions professionnelles, certains relatent payer un forfait mensuel de 500 dollars à un grand cabinet pour recevoir des points d’étape manifestement rédigés par IA sans avertissement préalable, omettant ou confondant régulièrement des faits cruciaux du dossier.
Plus périlleuse encore s’avère la fabulation pure et simple de jurisprudence et de motifs (hallucinations). Les modèles inventent parfois des précédents de toutes pièces. Si l’avocat qui révise le texte ne s’en aperçoit pas et dépose ses conclusions au tribunal, les sanctions disciplinaires sont immédiates. La réaction du logiciel se borne à une contrition polie : “Vous avez raison, je n’aurais pas dû inventer une affaire inexistante”. Au bout de la chaîne de responsabilité se tient invariablement un être humain ; le code, lui, échappe à tout châtiment.
Certains comparent ces outils aux bases de données juridiques d’autrefois, estimant le risque exagéré. La différence tient pourtant à leur positionnement : une base de données expose des pièces brutes, laissant l’armature de l’argumentation au juriste. L’agent, lui, fournit un produit fini, de la recherche à la rédaction. Citations, forme et conclusions peuvent être dictées par l’outil, mais la responsabilité pèse sur le seul signataire.
Un coût marginal qui tend vers zéro, mais un stylo de plus en plus lourd
Le coût marginal de rédaction d’un acte volumineux approche de zéro. Conséquence directe : les projets de documents s’accumulent sur le bureau des avocats, sans que le temps nécessaire à leur relecture ne puisse être rogné d’une seconde. L’écriture s’accélère à l’infini, pas la vérification du bien-fondé de ce qui est écrit.
Si d’aucuns prédisent des jours faciles pour les praticiens, d’autres redoutent l’effet inverse : dès lors que la qualité de base devient banale, la concurrence basculera sur les volumes. Les cabinets pousseront leurs collaborateurs à signer davantage d’actes — la responsabilité restant individuelle, le temps de contrôle sera raboté. Moins lire pour signer plus : voilà le piège le plus pernicieux de cette transition.
Les 19,2 % obtenus par GLM-Legal constituent une avancée technique indéniable : ils prouvent qu’un petit modèle dédié, forgé par une sélection de données rigoureuse et l’apprentissage par renforcement, peut livrer un premier jet solide dans un univers où l’erreur est bannie. Mais le véritable enjeu de cette technologie réside depuis le départ dans l’attribution des responsabilités.
L’autorité d’un acte juridique n’a jamais dépendu de la vitesse à laquelle il est rédigé. Derrière chaque consultation en vigueur, un avocat engage son titre professionnel. La machine propose l’ébauche, l’humain en assume les conséquences. Tant que cette responsabilité ne pourra être partagée, la main qui tient le stylo ne fera que serrer davantage.
Liens de référence :
- Blog officiel de Zhipu z.ai
- Guide du benchmark d’évaluation Harvey LAB
- Débats communautaires sur Hacker News