総合通過率19.2%:初案は出せても、署名可能な意見書には程遠い
19.2%——これが、AIを法律事務所の業務パイプラインに組み込んだ際に得られた一連タスクの総合通過率(all-pass rate)である。2026年10月12日、Zhipu AI(智譜AI)は法律業務に特化したエージェントモデル「GLM-Legal」を発表した。24の実務領域を網羅する Harvey LAB ベンチマークにおいて、同モデルはベースモデルから12.5ポイントのスコア向上を果たした。しかしそれでもなお、複雑なタスクの8割以上が門前払いを食らっているのが現実だ。
この「全問合格」評価は、一連のタスクチェーン全体で性能劣化が一切起きないことを求めている。12.5ポイントの向上は、特定領域に特化した事後学習(Post-training)の確かな効果を証明しているが、19.2%という頭打ちは極めて冷静な現実の境界線を示している。構造の整ったコンプライアンス初案は出せても、そのまま捺印して効力を発揮できる正式な法律意見書には到底仕上がらない。
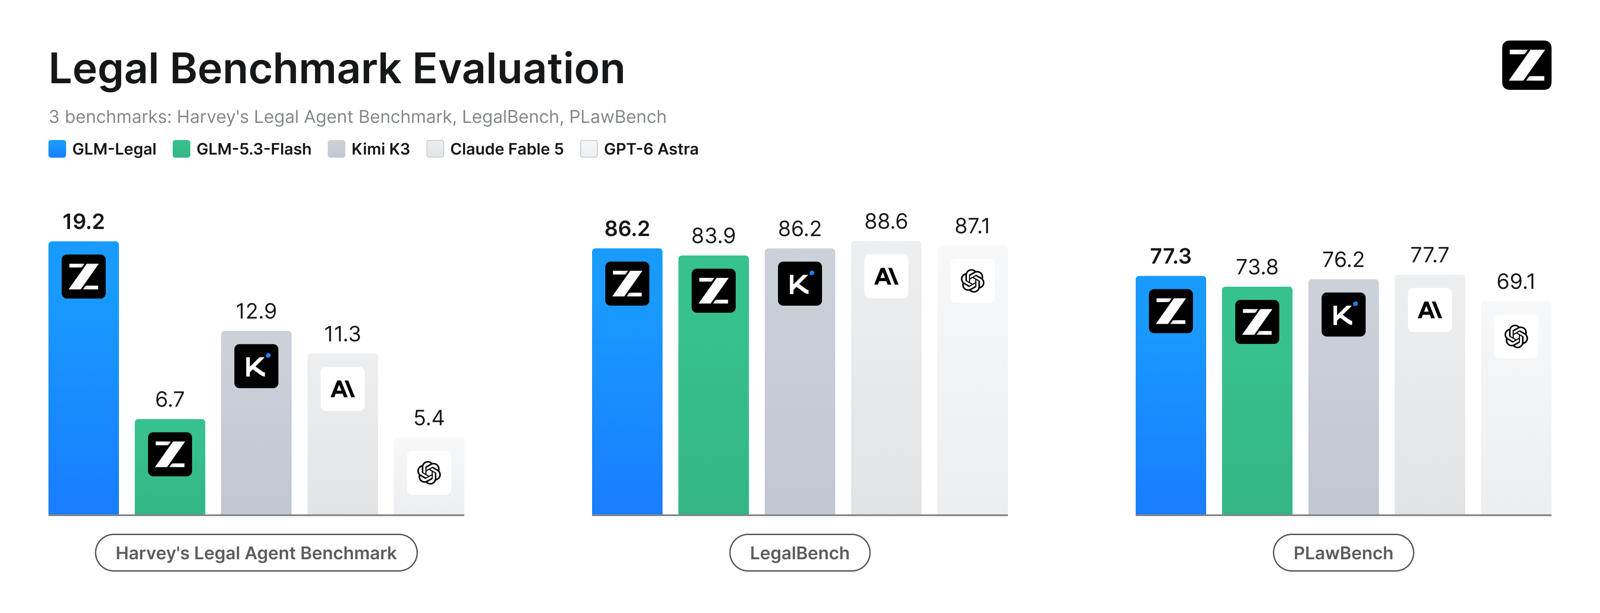 図:複雑なタスク実行、法的推論、実践的文書起草の3軸におけるGLM-Legalの公式ベンチマーク結果。出典:Zhipu z.ai 公式ブログ
ベンダーはこうした能力を「専門的協調」と呼ぶ。Zhipuが公開した比較チャートでは、GLM-Legalは複雑な実行、法的推論、実務的文書起草の3つの軸すべてでトップクラスの最前線システムに肉薄している。生成側のアウトプットコストは急激に低下しているが、その波頭で最も重いプレッシャーにさらされているのは、ペンを握る弁護士自身である。
法律業務のパイプラインに、わずかなハルシネーションも許されない
コードを書く際のバグは見つけやすい。プログラムを走らせれば例外が発生するか、テストケースに引っかかる。しかし訴訟の実務において、消滅時効を見落としたり立証責任を取り違えたりすれば、裁判全体を失う致命的な代償を払うことになる。
契約書に潜む誤りはさらに見つけにくい。文言が曖昧な補償条項に調印しても、その場ですぐに問題が顕在化することはない。数年後に紛争が起きて初めて責任が精算されるのだ。この「破綻が遅れて訪れる」性質こそが、法律実務における正確性のハードルを他のいかなる知識労働よりも高く押し上げている。
Zhipuは法律業務を「事実、法規、推論、納品物」の4段階のチェーンとして要約する。この4つは完全に閉じたループを形成していなければならない。システムは何百ページもの資料から争点を抽出し、反論に耐えうる論証を構築し、最後に指定されたタスクの仕様どおりに体裁を整える必要がある。途中のどの環が外れても、文書全体が紙屑同然となる。
ベンチマーク結果もこのチェーンの厳しさを物語っている。専門的な契約書、M&A届出書類、司法的判断を分析する LegalBench において、GLM-Legalはトップクラスのプロプライエタリな最前線モデルと肩を並べた。中国法務の相談ベンチマークである PLawBench でも上位に食い込んでいる。極めて注目すべきは、はるかに軽量なパラメータ規模でこれと同等のスコアを叩き出した点である。
軽量モデルを強化学習で鍛え上げ、法条を実行可能なチェックリストに変える
GLM-Legalは軽量ベースモデル「GLM-5.3-Flash」を基盤に構築されており、公式発表でもそのパラメータ規模の小ささが強調されている。小規模であることは、オンプレミスでのプライベート配備のハードルを下げ、法律事務所における日常的な推論コストの計算を容易にする。
中間学習段階では、高品質な法律コーパスを拡充し、「事実—規則—結論」という演繹的接続を強化した。事後学習段階では、数万件の実践的な法律環境の中で強化学習を施し、ランタイムのオーケストレーション基盤(Harness)と反復的に協調改善させた。フレームワークがモデルの弱点を露呈させ、モデルが逆にフレームワークのボトルネックを指摘する関係である。
現場の実務家はアウトプットに対して4つの受入基準を定めた。重要論点とエッジケースを網羅しているか、論証に根拠があり引用が確固たるものか、納品物がタスク要件に厳格に合致しているか、そして下流のチームが手直しなしでそのまま使えるかである。最後の基準こそが最も厳格であり、主観的な「書きぶりの良し悪し」を測定可能な手戻り損失へと変換した。
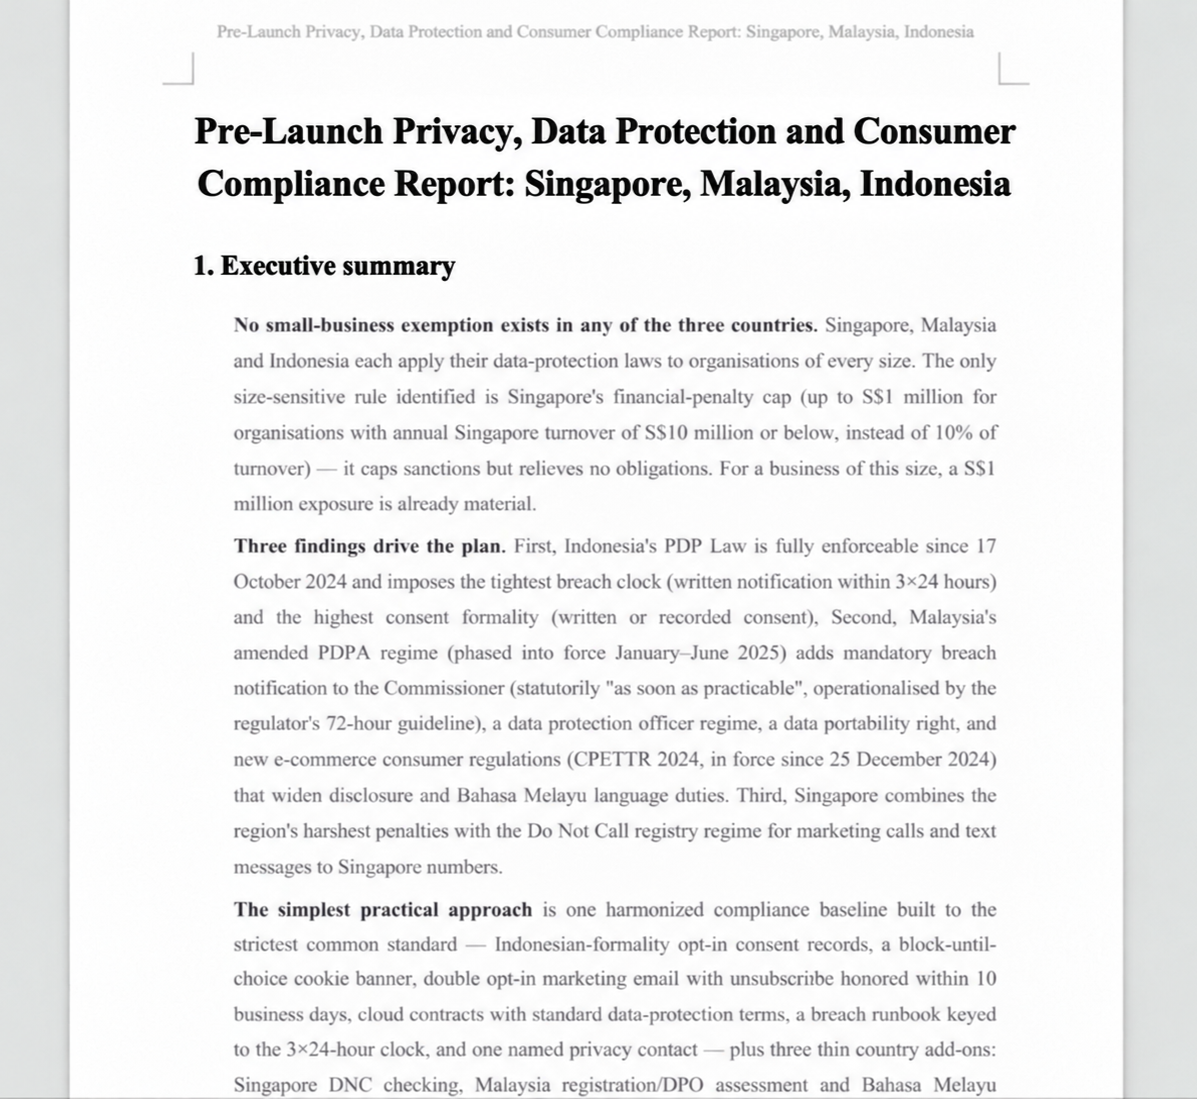 図:抽象的な法条を具体的実行ステップへと分解した越境プライバシーコンプライアンス・チェックリスト。出典:Zhipu z.ai 公式ブログ
上記の図が公式に提示された実務適用例である。国境を越えたサービス展開に伴うプライバシー要件が国別に分解され、P0タスクリストとして整理されている。AutoClawを基盤とし、ユーザーがビジネス要件を入力するだけで、現場に直ちに割り振れる実行タスクが出力される。
モデルは間違えても資格を剥奪されないが、署名した弁護士は全責任を負う
技術指標が右肩上がりに伸びる一方で、現場の実務における緊張感は緩和されていない。開発者コミュニティの議論では、大手法律事務所に月額500ドルの基本顧問料を支払っているにもかかわらず、届いた進捗報告メールがAI生成であることの開示もなく、重要事実が抜け落ちたり混同されたりしていたという事例が報告されている。
さらに危険なのが、判例や裁判要旨の捏造(ハルシネーション)である。モデルは時に実在しない先例をでっち上げる。レビューを担当する弁護士が見落としてそのまま裁判所に提出してしまえば、待っているのは懲戒や司法的制裁だ。それに対するプログラムの反応は、「おっしゃる通りです。存在しない判例を捏造すべきではありませんでした」と慇懃無礼に謝罪するだけである。制裁の連鎖の終着点には常に人間が立っており、コードはその輪の中にいない。
こうしたツールを往年の判例検索データベースになぞらえ、リスクは誇張されていると主張する者もいる。しかし両者の本質的な差はその位置づけにある。データベースは候補資料を一覧提示するだけであり、論証の枠組みを構築するのは弁護士だった。一方、エージェントが提供するのは検索から文章化まで一貫した完成品である。引用、体裁、結論のすべてをAIが決めたとしても、その責任はサインをした人間だけが引き受ける。
執筆コストがゼロに近づくほど、署名するペンの重みは増す
長文の法律文書を起草する限界費用はゼロへと向かっている。その結果、弁護士の机の上には初案の山が何倍にも積み上がり、校閲にかける時間は1分たりとも節約できない。アウトプットは無限に加速できても、その内容が正しいかを検証する作業は加速できないのだ。
弁護士の仕事が劇的に楽になると予測する声がある一方で、真逆のシナリオを警戒する声も多い。品質で差がつかなくなれば競争は処理件数の多さへと移行し、事務所は弁護士により多くの書類への署名を求めるようになる。責任は個人のままで、確認時間は削られていく。「読む時間を削り、署名する量を増やす」——これこそが、このシステムが孕む最も自然な滑落である。
GLM-Legalが示した19.2%という数値は確かなエンジニアリングの前進であり、データの再構築と強化学習によって、最も誤りの許されない専門領域でも実用的な初案を出せることを証明した。しかし、このテクノロジーの真の焦点は、最初から責任の所在という一点に突き刺さっている。
法律文書の真の価値は、それがどれほど速く生成されたかによって決まるものではない。有効な意見書の背後には、弁護士自身の資格と信義が担保として置かれている。機械が下書きを吐き出し、人間が結果を背負う——責任を分担する仕組みが生まれない限り、署名用のペンを握る手の力は、以前にも増して強まるばかりである。
参考リンク:
- Zhipu z.ai 公式ブログ
- Harvey LAB 評価ベンチマーク解説
- Hacker News コミュニティ議論