Una tasa de éxito integral del 19,2 %: lista para borradores, lejos del dictamen definitivo
19,2 %: esa es la tasa de aprobación integral de extremo a extremo que obtiene un modelo de IA al insertarse en el flujo de trabajo de un bufete de abogados. El 12 de octubre de 2026, Zhipu AI presentó GLM-Legal, un modelo de agentes orientado a tareas jurídicas. En el banco de pruebas Harvey LAB, que abarca 24 áreas de práctica profesional, esta métrica superó a su modelo base en 12,5 puntos porcentuales. Aun así, más del 80 % de las tareas complejas siguen quedando fuera de su alcance.
Esta evaluación de “aprobado total” (all-pass rate) exige que el modelo complete una cadena de tareas compleja de principio a fin sin una sola degradación. El aumento de 12,5 puntos demuestra que el post-entrenamiento en dominios especializados funciona; no obstante, el techo del 19,2 % marca una frontera realista. Es capaz de entregar un primer borrador de cumplimiento bien estructurado, pero no un dictamen jurídico listo para estampar la firma y surtir efecto.
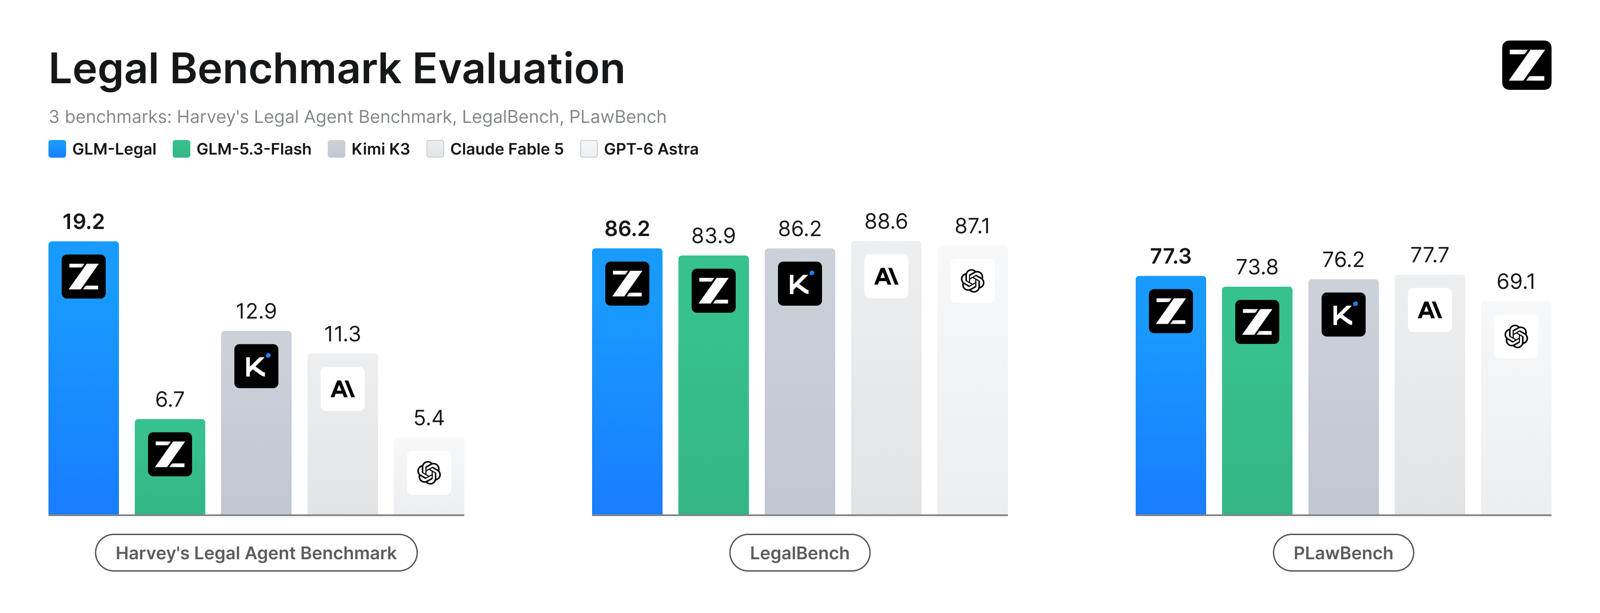 Figura: Rendimiento oficial de GLM-Legal en los tres ejes de ejecución compleja, razonamiento jurídico y redacción documental real. Fuente: Blog oficial de Zhipu z.ai
Las empresas vendedoras denominan a esta capacidad “colaboración profesional”. En los gráficos comparativos de Zhipu, GLM-Legal compite de tú a tú con los sistemas punteros en tres ejes: ejecución compleja, razonamiento legal y redacción en escenarios reales. El coste de producción se desploma en picado, pero quien aguanta la tormenta sigue siendo la persona que sostiene la pluma.
El flujo jurídico no tolera la menor alucinación
Los errores al programar son relativamente fáciles de cazar: el código arroja una excepción al ejecutarse o es detectado por los tests automatizados. En un litigio, en cambio, saltarse un plazo de prescripción o invertir la carga de la prueba puede costar el juicio entero.
Los fallos en los contratos son aún más traicioneros. Firmar una cláusula de indemnización ambigua no produce consecuencias inmediatas; el desastre estalla años después, en pleno conflicto. Esta naturaleza de “fallar con retraso” impone a la práctica jurídica una exigencia de precisión muy superior a la de casi cualquier otro trabajo intelectual.
Zhipu resume la labor jurídica en una cadena de cuatro eslabones: hechos, leyes aplicables, razonamiento y producto entregable. Los cuatro deben formar un circuito cerrado perfecto. El sistema tiene que extraer los puntos controvertidos de cientos de páginas de autos, armar una argumentación defendible y maquetar el texto con arreglo a las especificaciones requeridas. Si falla un solo eslabón, todo el documento queda en papel mojado.
Los resultados de los benchmarks corroboran la dificultad del proceso. En LegalBench, que evalúa el análisis de contratos, expedientes de fusiones y resoluciones judiciales, GLM-Legal empató con modelos punteros de código cerrado; también se situó en los primeros puestos en PLawBench, el benchmark de asesoría legal en chino. Lo más relevante es que logró estas puntuaciones con un número de parámetros sensiblemente menor.
Aprendizaje por refuerzo en un modelo ligero: convertir leyes en listas de acción
GLM-Legal se asienta sobre la base ligera GLM-5.3-Flash, y el equipo oficial subraya su escala reducida de parámetros. Un tamaño contenido reduce las barreras para el despliegue privado on-premise y permite a los bufetes mantener bajo control los costes computacionales diarios.
En la fase intermedia de entrenamiento, el equipo amplió los corpus jurídicos de alta calidad para afianzar el nexo deductivo entre “hecho, norma y conclusión”. En el post-entrenamiento, el modelo se sometió a aprendizaje por refuerzo en decenas de miles de entornos legales simulados, iterando de forma conjunta con el marco de orquestación en tiempo de ejecución (Harness): el marco destapaba las flaquezas del modelo, y este señalaba a su vez los cuellos de botella del marco.
Los profesionales fijaron cuatro criterios estrictos de aceptación: cobertura de cuestiones críticas y casos límite; argumentación fundamentada con citas contrastables; ajuste riguroso a los requisitos del encargo; y capacidad de ser utilizado directamente por el equipo siguiente sin necesidad de rehacerlo. Este último criterio es el más severo: convierte la apreciación subjetiva de “cómo está redactado” en una pérdida medible por retrabajo.
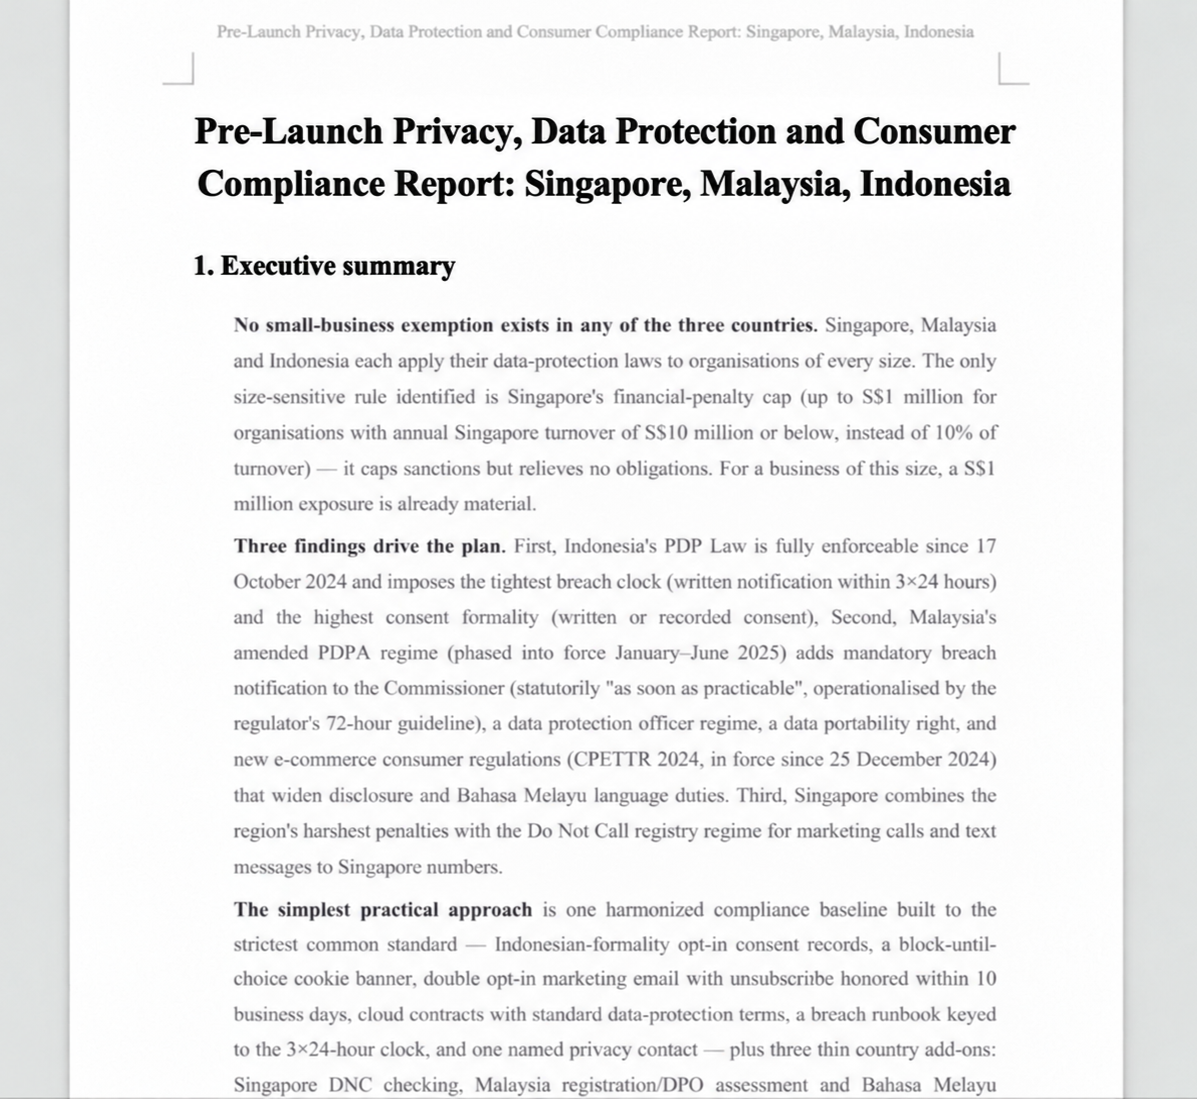 Figura: La lista de verificación de privacidad desglosa artículos legales abstractos en pasos ejecutables concretos. Fuente: Blog oficial de Zhipu z.ai
La imagen superior muestra un caso práctico oficial: los requisitos de privacidad para un lanzamiento internacional, estructurados en pasos por países y acompañados de una lista de tareas prioritarias (P0). Mediante AutoClaw, el usuario introduce el contexto de negocio y obtiene un plan de trabajo listo para delegar.
El modelo no pierde su licencia por equivocarse; el abogado que firma asume toda la culpa
Mientras los indicadores técnicos no paran de subir, la tensión en el ejercicio diario de la profesión no disminuye. En debates comunitarios, algunos usuarios relataron pagar una cuota mensual de 500 dólares a un gran despacho solo para recibir correos de seguimiento redactados por IA sin advertencia previa, donde a menudo se omitían o confundían datos clave.
Mucho más grave es la invención deliberada de jurisprudencia y tesis judiciales (alucinaciones). A veces, los modelos crean precedentes de la nada. Si el abogado revisor no lo advierte y lo presenta ante el tribunal, se arriesga a sanciones disciplinarias. La respuesta del programa ante tal desastre se reduce a una educada disculpa: “Tiene usted razón, no debí inventar un caso inexistente”. Al final de la cadena de responsabilidad siempre hay un ser humano; el código no responde ante nadie.
Hay quienes comparan estas herramientas con las bases de datos de jurisprudencia de antaño y consideran que el riesgo es exagerado. La diferencia radica en su enfoque: la base de datos se limitaba a desplegar materiales de consulta, dejando la estructura argumental en manos del letrado. Un agente, en cambio, entrega un producto acabado, desde la búsqueda hasta la redacción. Citas, formato y conclusiones pueden provenir de la máquina, pero la responsabilidad la asume en exclusiva quien estampa la firma.
El coste de redacción se acerca a cero, pero la pluma pesa más que nunca
El coste marginal de redactar un escrito extenso tiende a cero. Como consecuencia directa, el volumen de borradores que llega a la mesa del abogado se multiplica, mientras que el tiempo necesario para revisarlos no se reduce ni un segundo. La producción puede acelerarse sin límite, pero la verificación de lo redactado no.
Aunque algunos vaticinan que la IA facilitará enormemente la vida de los letrados, otros prevén el escenario contrario: cuando la calidad base se estandarice, la competencia virará hacia el volumen y los bufetes empujarán a firmar más documentos. La responsabilidad sigue siendo personal, pero los márgenes de revisión se comprimen. Leer menos y firmar más es la trampa más peligrosa de este modelo.
La tasa del 19,2 % lograda por GLM-Legal representa un sólido avance de ingeniería: demuestra que modelos pequeños especializados, gracias a la curación de datos y el aprendizaje por refuerzo, pueden ofrecer borradores viables en campos donde no caben los errores. Sin embargo, el centro de gravedad de esta tecnología se sitúa desde el primer día en el reparto de responsabilidades.
La validez de un documento jurídico jamás ha dependido de lo rápido que se redacte. Detrás de cada dictamen vinculante hay un abogado que avala el texto con su título profesional. La máquina expide el borrador, pero el humano asume las consecuencias. Hasta que la responsabilidad pueda compartirse, la mano que sostiene la pluma solo apretará con más fuerza.
Enlaces de referencia:
- Blog oficial de Zhipu z.ai
- Guía del benchmark de evaluación Harvey LAB
- Debate en la comunidad de Hacker News