All-Pass-Rate von 19,2 %: Reif für den Erstentwurf, weit entfernt vom Gutachten
19,2 % – das ist die lückenlose Erfolgsquote, die ein KI-Modell erzielt, wenn man es in die Arbeitsabläufe einer Kanzlei einbindet. Am 12. Oktober 2026 stellte Zhipu AI mit GLM-Legal ein auf juristische Szenarien zugeschnittenes Agentenmodell vor. Auf dem Harvey-LAB-Benchmark, der 24 Rechtsgebiete abdeckt, verbesserte sich dieser Wert gegenüber dem Basismodell um 12,5 Prozentpunkte. Dennoch bleiben über 80 % der komplexen Aufgaben unerreichbar.
Diese „All-Pass“-Metrik verlangt, dass ein Modell entlang einer mehrstufigen Aufgabenkette fehlerfrei und ohne Qualitätseinbußen arbeitet. Der Zuwachs um 12,5 Prozentpunkte belegt zwar die Wirksamkeit spezialisierten Post-Trainings für Domänenwissen; die Marke von 19,2 % markiert jedoch eine ernüchternde Grenze. Das System liefert strukturell saubere Compliance-Erstentwürfe, ist jedoch meilenweit von rechtsverbindlichen, zeichnungsreifen Gutachten entfernt.
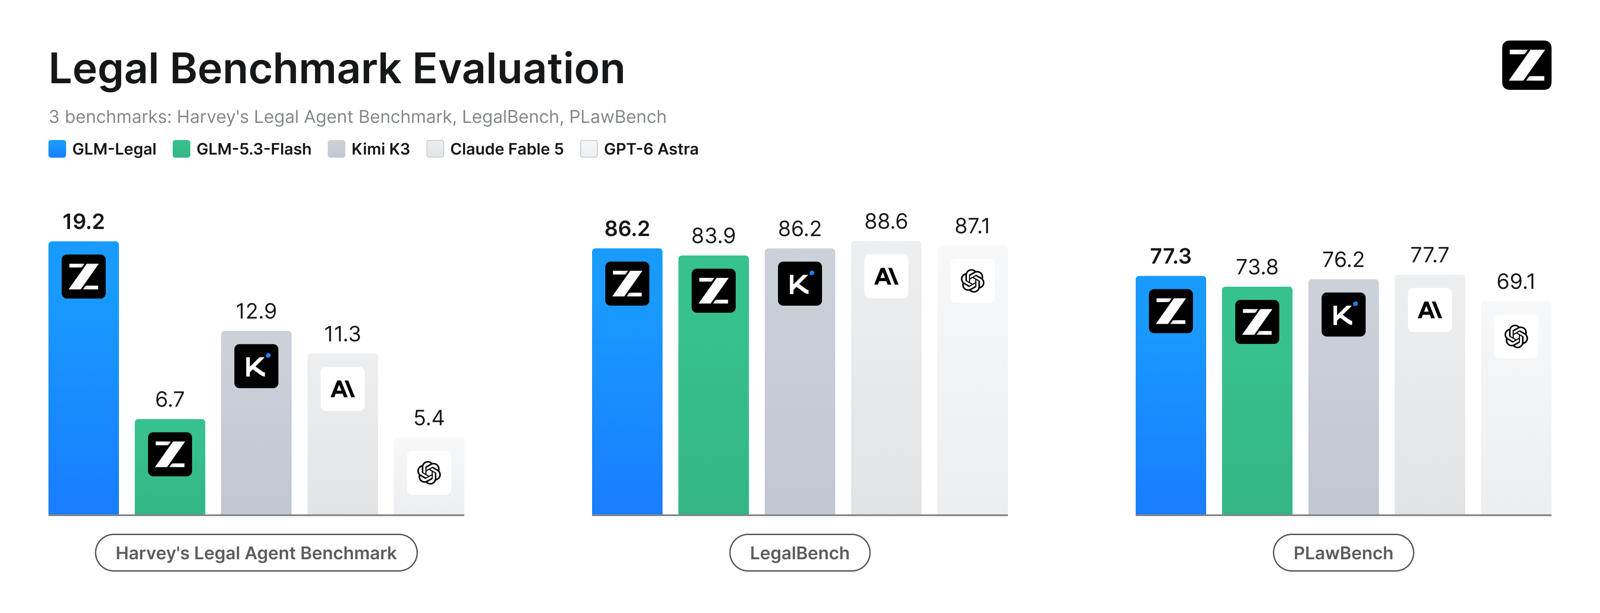 Abb.: Offizielle Benchmark-Leistung von GLM-Legal entlang der drei Achsen komplexe Ausführung, juristische Argumentation und Erstellung realer Schriftsätze. Quelle: Offizieller Blog von Zhipu z.ai
Hersteller bezeichnen solche Fähigkeiten als „professionelle Kollaboration“. In den von Zhipu veröffentlichten Diagrammen schließt GLM-Legal bei komplexer Ausführung, juristischer Logik und dem Verfassen praxisnaher Dokumente dicht zu führenden Systemen auf. Während die Produktionskosten auf der Generierungsseite drastisch sinken, trägt derjenige das gesamte Risiko, der am Ende die Unterschrift leistet.
Der juristische Prozess verzeiht keine Halluzinationen
Fehler beim Programmieren lassen sich relativ leicht aufspüren: Der Code wirft bei der Ausführung eine Exception oder fällt durch automatische Tests. In einem Rechtsstreit hingegen kann das Versäumen einer Frist oder eine verdrehte Beweislast den gesamten Prozess kosten.
Noch heimtückischer sind Fehler in Verträgen. Eine schwammig formulierte Haftungsklausel richtet bei der Unterzeichnung zunächst keinen sichtbaren Schaden an; die verheerenden Folgen treten erst Jahre später zutage, wenn es zum Rechtsstreit kommt. Diese zeitlich verzögerte Schadenswirkung stellt an juristische Präzision weitaus höhere Anforderungen als an jede andere Wissensarbeit.
Zhipu gliedert die juristische Arbeit in eine geschlossene Kette: Sachverhalt, Rechtsnormen, Subsumtion und Endergebnis. Alle vier Glieder müssen nahtlos ineinandergreifen. Das System muss aus Hunderten Seiten Akten die Streitpunkte herausfiltern, eine tragfähige Argumentation aufbauen und das Dokument formgerecht gestalten. Reißt die Kette an nur einer Stelle ab, ist das gesamte Dokument unbrauchbar.
Die Benchmark-Ergebnisse spiegeln die Schwierigkeit dieser Kette wider. Auf LegalBench, einem Test für Vertragsanalysen, Fusionskontrollanträge und richterliche Beschlüsse, zog GLM-Legal mit führenden proprietären Modellen gleich; auch auf PLawBench, dem Benchmark für chinesische Rechtsberatung, belegt es Spitzenplätze. Das Besondere: Diese Resultate wurden mit einer deutlich schlankeren Modellgröße erzielt.
Reinforcement Learning auf schlanker Basis: Gesetzestexte in Handlungslisten verwandeln
GLM-Legal basiert auf dem leichtgewichtigen Fundament GLM-5.3-Flash, wobei die Entwickler den spürbar reduzierten Parameterumfang betonen. Eine kompakte Modellgröße senkt die Einstiegshürde für lokale On-Premises-Installationen drastisch und macht die Rechenkosten im Kanzleialltag kalkulierbar.
In der mittleren Trainingsphase erweiterte das Team hochwertige juristische Textkorpora, um die deduktive Verknüpfung im Schema „Sachverhalt–Norm–Ergebnis“ zu festigen. Im Post-Training durchlief das Modell Reinforcement Learning in zehntausenden simulierten Rechtsumgebungen. Dabei wurde es iterativ mit dem Laufzeit-Orchestrierungs-Framework (Harness) verfeinert: Das Framework legte Schwachstellen des Modells offen, während das Modell Engpässe des Frameworks aufdeckte.
Rechtspraktiker definierten vier harte Abnahmekriterien: vollständige Abdeckung von Kernfragen und Sonderfällen; fundierte Argumentation mit stichhaltigen Zitaten; strikte Einhaltung formaler Vorgaben; und sofortige Verwendbarkeit durch nachgelagerte Teams ohne Nacharbeit. Letzteres Kriterium ist das härteste: Es verwandelt subjektive Urteile über den Schreibstil in quantifizierbare Verluste durch Nachbearbeitung.
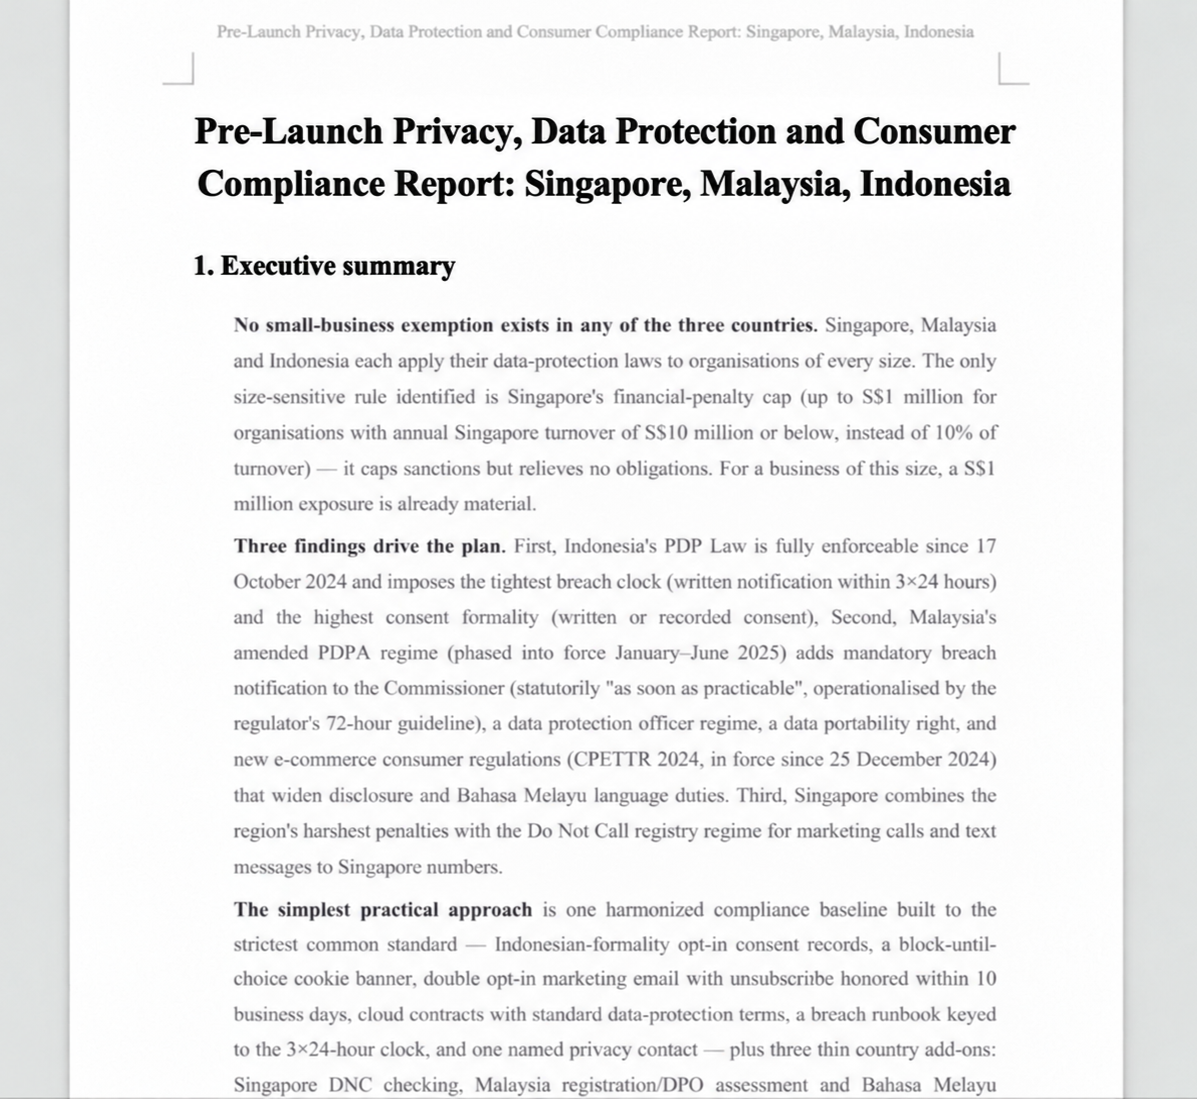 Abb.: Die Checkliste für Datenschutz-Compliance übersetzt abstrakte Rechtsnormen in konkrete Handlungsschritte. Quelle: Offizieller Blog von Zhipu z.ai
Die obige Abbildung zeigt einen konkreten Praxisfall: Datenschutzanforderungen für einen weltweiten Produktlaunch, gegliedert nach Ländern und ergänzt durch eine P0-Aufgabenliste. Gestützt auf AutoClaw geben Anwender den geschäftlichen Kontext ein und erhalten direkt delegierbare Arbeitsaufträge.
Modelle verlieren keine Zulassung – der unterschreibende Anwalt haftet voll
Während die technischen Kennzahlen steigen, bleibt das Spannungsverhältnis in der Praxis ungelöst. In Entwicklerforen berichten Nutzer von Großkanzleien, die trotz monatlicher Mindesthonorare von 500 US-Dollar unangekündigt KI-generierte Fortschrittsberichte verschickten – häufig mit gravierenden Auslassungen oder verdrehten Details.
Noch brisanter ist das freie Erfinden von Urteilen und Leitsätzen (Halluzinationen). Modelle fabrizieren mitunter Präzedenzfälle, die nie existiert haben. Reicht ein Anwalt diese ungeprüft bei Gericht ein, drohen berufsrechtliche Sanktionen. Die Software reagiert darauf lediglich mit der höflichen Einsicht: „Sie haben recht, ich hätte keinen fiktiven Fall erfinden dürfen.“ Am Ende der Haftungskette steht ausnahmslos der Mensch; der Algorithmus ist fein raus.
Einige vergleichen solche Werkzeuge mit früheren juristischen Datenbanken und halten die Risiken für übertrieben. Der fundamentale Unterschied liegt jedoch in der Rolle: Datenbanken liefern Recherchematerial, überlassen den Aufbau der Argumentation aber dem Anwalt. Ein Agent hingegen liefert ein fertiges Erzeugnis von der Recherche bis zur Formulierung. Zitate, Format und Fazit mögen von der Maschine stammen – die Verantwortung trägt allein die Person, deren Name unter dem Dokument steht.
Grenzkosten gegen null – doch der Stift wird immer schwerer
Die Grenzkosten für das Verfassen umfangreicher Schriftsätze nähern sich dem Nullpunkt. Die Konsequenz: Auf den Schreibtischen der Anwälte stapeln sich die Entwürfe, während für die sorgfältige Prüfung keine einzige Minute eingespart werden kann. Die Generierung lässt sich beliebig beschleunigen, die Verifikation der Korrektheit nicht.
Manche prophezeien Juristen ein bequemes Arbeiten, andere sehen die Kehrseite: Wenn Qualität zur Massenware wird, verlagert sich der Wettbewerb auf die Menge. Kanzleien werden Anwälte dazu drängen, mehr Dokumente freizugeben – bei unveränderter persönlicher Haftung und schrumpfenden Prüfzeitfenstern. Weniger lesen, mehr unterzeichnen: Das ist die gefährlichste Falle dieses Wandels.
Die Erfolgsquote von 19,2 % bei GLM-Legal ist ein solider ingenieurtechnischer Fortschritt. Sie beweist, dass spezialisierte kleinere Modelle durch Datenkuration und Reinforcement Learning in fehlerintoleranten Fachgebieten brauchbare Erstentwürfe liefern können. Die eigentliche Bewährungsprobe dieser Technologie liegt jedoch von Beginn an in der Verteilung von Verantwortung.
Die Rechtskraft eines Dokuments hängt nicht davon ab, wie schnell es erstellt wurde. Hinter jedem wirksamen Gutachten bürgt ein Anwalt mit seiner Zulassung. Die Maschine liefert den Entwurf, der Mensch trägt die Konsequenzen. Solange diese Verantwortung nicht geteilt werden kann, wird die Hand am Füllfederhalter nur noch fester zupacken.
Weiterführende Links:
- Offizieller Blog von Zhipu z.ai
- Harvey LAB Benchmark-Übersicht
- Community-Diskussion auf Hacker News