2026 年 10 月 13 日,AI Engineer 大会在纽约举行。Revolut 基础设施负责人 David Abitbol 在现场公开了内部 AI 迁移数据。这家拥有约 2000 名工程师的数字银行,退订了商用闭源 API。他们转用 56 张英伟达 B200 芯片,在自建集群上运行开放权重模型 GLM-5.3。
硬件切换带来了立竿见影的财务变化。月度推理总支出缩减到此前的十分之一,混合成本压至每百万 token 约 0.3 美元。内部采样数据显示,全员实际编码耗时缩短约 60%,端到端交付周期缩短约 70%。这些数据来自迁移前后的相关性统计,反映了工具普及后的效能跃升。
自托管开放权重的核心回报,在于消除「token 稀缺」带来的心理配额。当按量计费被硬件折旧取代,工程师获得了高频试错的用量自由。内部团队同时接过了系统调优、沙箱隔离与遥测治理等硬责任。
按量计费倒逼工程师精打细算
Revolut 的探索始于外围辅助任务。早期团队接入 Gemini 处理文档检索与技术规范,编码耗时与交付周期初见成效。随着工具深入开发链路,团队引入推理能力更强的 Claude Code,尝试覆盖复杂业务逻辑与跨文件排错。
商业模型的账单膨胀速度极快。部分工程师在排查疑难缺陷时发起密集调用,消耗了大量 token 预算。由于代码产出没有成比例增加,管理层随后设立了个人用量限额。
限额机制迅速扭曲了工程师的使用习惯。每个人都开始精打细算,只在遇到棘手难题时才敢发起调用。挪一个函数、补一段测试这类琐事,反而回到了手动路上。按量计费设立的配额红线,把随叫随到的自动化工具变成了需要精打细算的受限资源。
团队意识到,智能体的生产力红利来自高频交互。只要单次调用挂钩浮动账单,工程师就会本能地回避使用。放开手脚的前提,是在财务上把不可预测的单次支出,锁定为可分摊的固定资产投入。
56 张 B200 把百万 token 成本压至 0.3 美元
Revolut 采购了 56 张英伟达 B200 加速卡搭建私有集群,托管 GLM-5.3 模型。平摊硬件折旧、电力与网络开销后,综合成本稳定在每百万 token 约 0.3 美元。月度推理总支出由此降至原先的十分之一。
充足的算力供给激活了全员调用意愿。约 2000 名工程师开始频繁调用模型生成脚手架、重构遗留代码与补齐单测。编码耗时缩短约 60%、交付周期缩短约 70% 的转变,正是解除配额约束后的自然结果。Abitbol 坦承这组数据缺乏隔离对照,但业务交付的提速切实发生在了生产线上。
私有集群必须在交互延迟上达到严苛指标。团队将首 token 时间(TTFT)的目标定在 3 秒以内。内部测试显示,响应延迟一旦超过 5 秒,工程师就会失去耐心切出窗口。在吞吐方面,约 200 tok/s 的流式速率足以满足交互,多数工程师习惯并行推进多项重构任务。
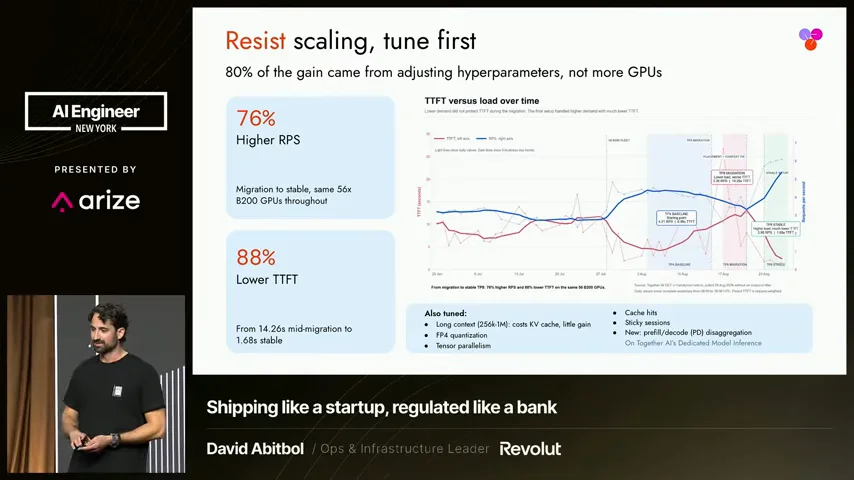 图:David Abitbol 在 AI Engineer NYC 2026 介绍 2000 名工程师的编码工具迁移。来源:AI Engineer NYC 2026 官方演讲
显存争夺迫使团队深挖推理优化
采购硬件不等于拥有高可用服务。迁移初期,集群在并发压力下暴露出严重的性能短板。平均首 token 响应时间一度恶化至 14.26 秒,排队堆积频发。
团队在 56 张卡规模不变的前提下重构了推理栈。经过细致调优,稳定态 TTFT 下降 88% 至 1.68 秒,每秒请求处理数(RPS)逆势提升 76%。调优深度决定了私有化部署的生死,系统级优化产生的吞吐增量远胜单纯增加物理显卡。
显存管理是推理优化的核心战场。KV 缓存与上下文窗口在有限显存中存在天然竞争。盲目开启最大上下文窗口会过度锁死静态空间,导致并发吞吐被严重压缩。Revolut 根据真实开发请求设置窗口尺寸,将节省出的显存全数交还给 KV 缓存。
在 Blackwell 架构上,团队采用 FP4 精度量化权重以压缩模型体积。4 路张量并行容易压缩单卡缓存空间。改用 8 路并行后,集群反而释放出更大的并发吞吐容量。对于多模态请求,团队将其路由至独立模型,避免异构计算污染编码模型的显存。
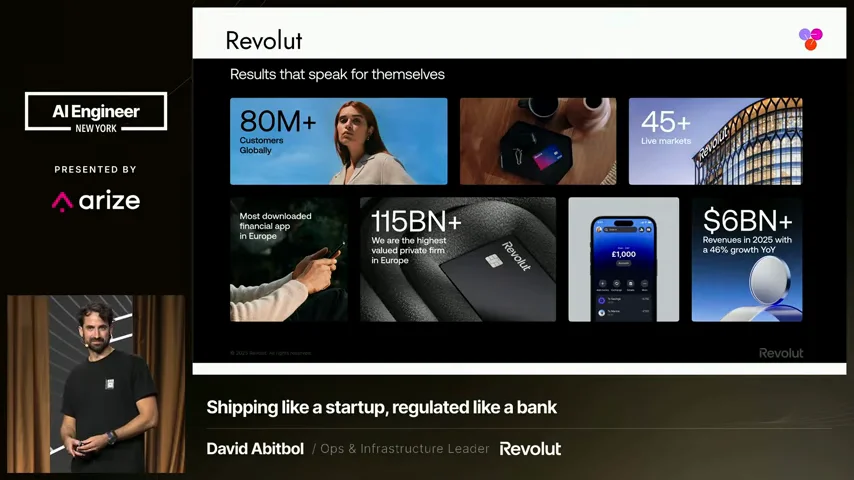 图:Revolut 自托管开放权重模型的推理栈调优细节。来源:AI Engineer NYC 2026 官方演讲
沙箱隔离与实时遥测构筑安全底线
把模型挪进自己的机房,安全策略与合规审计的边界也要自己划。金融科技业务涉及核心资金与合规数据,智能体一旦越界操作,破坏力会顺着权限放大。
Revolut 没有把希望寄托在事后抽检上。智能体的改动与测试操作全部跑在沙箱里,沙箱限制了它能触碰的代码与系统范围,即便生成破坏性命令,影响范围也被封锁在单元内部。
审批规则把触碰生产与主干的危险操作拦在外面。针对提示词注入这类来自外部的输入风险,团队搭建了全链路遥测追踪管道。缺乏审计遥测的本地智能体,本质上等同于在内部网络长期运行不受监管的高权限账户。
固定资产支出对赌团队真实利用率
关于大模型私有部署的争论始终存在。支持者看重权重自主。掌握本地基础设施能规避供应商提价风险,并为研发提供放手尝试的土壤。
质疑者则聚焦沉重的隐性成本。顶级加速卡的折旧支出是一笔硬性开销,开源模型演进与闭源旗舰依然存在代差。企业必须长期维持高水平系统调优队伍,人力与运维开销同样显著。
自托管的经济优势高度依赖集群饱和度。Revolut 能把成本压到每百万 token 0.3 美元,底气在于 2000 名工程师持续制造的高并发请求。若团队规模较小且调用频率稀疏,硬件闲置分摊后的实际 token 单价,反而会远超商业 API。
David Abitbol 强调,权重部署在哪,比模型来自哪更重要。各家机构的监管分类大相径庭,Revolut 的解法建立在自身规模之上。
自托管开放权重的核心价值,是用工程确定性换取研发自由度。它消除的障碍并非模型跑分差距,而是工程师按下回车前的顾虑。
算力配额消失后,智能体才能真正融入日常工作流。私有化不是通用解法。但在解除资源门槛后,工程交付释放出了全新的效能。
参考链接:
- AI Engineer NYC 2026:Revolut 自托管开放权重的演讲
- AI Engineer 官方技术报告