Am 13. Oktober 2026 präsentierte David Abitbol, Infrastrukturchef von Revolut, auf der AI Engineer Conference in New York konkrete Kennzahlen und Telemetriedaten einer internen KI-Migration. Die Digitalbank mit rund 2.000 Software-Ingenieuren kündigte ihre kommerziellen Closed-Source-API-Abonnements und betreibt das Open-Weights-Modell GLM-5.3 nun auf einem eigenen Cluster mit 56 Nvidia-B200-Beschleunigern.
Der Hardwarewechsel zeigte unmittelbar finanzielle Wirkung. Die monatlichen Gesamtausgaben für Inferenz sanken auf ein Zehntel des bisherigen Niveaus, während sich die Mischkosten bei rund 0,30 US-Dollar pro Million Tokens stabilisierten. Interne Stichproben belegen, dass die tatsächliche Codierzeit um etwa 60 Prozent sank und sich die End-to-End-Bereitstellungszyklen um rund 70 Prozent verkürzten. Diese Zahlen stammen aus Korrelationsstatistiken vor und nach der Umstellung und verdeutlichen den Effizienzsprung nach flächendeckender Einführung des Werkzeugs.
Der entscheidende Ertrag des Self-Hostings offener Gewichte liegt in der Beseitigung der psychologischen Kontingentierung, die durch Token-Knappheit entsteht. Wenn nutzungsbasierte Abrechnung durch planbare Hardware-Abschreibungen abgelöst wird, gewinnen Entwickler die Freiheit für hochfrequentes Ausprobieren und Scheitern. Im Gegenzug übernahm das interne Plattformteam anspruchsvolle Aufgaben in der Systemoptimierung, Sandbox-Isolation und Telemetrie-Governance.
Nutzungsbasierte Abrechnung zwang Ingenieure zur Token-Rationierung
Revoluts Einstieg in generative KI begann mit peripheren Aufgaben. Zunächst band das Team Gemini für Dokumentenabfragen und technische Spezifikationen an, was messbare Verbesserungen bei Codierzeit und Durchlaufzeiten brachte. Als die Werkzeuge tiefer in den Entwicklungszyklus vordrangen, führte das Team Claude Code für anspruchsvollere Logik und dateiübergreifendes Debugging ein.
Die Rechnungen für kommerzielle Modelle explodierten jedoch rasant. Einige Ingenieure starteten bei der Fehlersuche intensive Aufrufe und verbrauchten erhebliche Teile des Token-Budgets. Da der Code-Output nicht proportional zu den Kosten stieg, führte das Management individuelle Nutzungskontingente ein.
Diese Begrenzung verzerrte das Arbeitsverhalten der Entwickler schlagartig. Jeder begann, Token penibel abzuwägen und das Modell nur noch bei vertrackten Problemen einzusetzen. Routineaufgaben – wie das Auslagern einer Funktion oder das Schreiben von Unit-Tests – wurden wieder manuell erledigt. Die durch Pay-per-Token gezogene Budgetgrenze verwandelte ein stets verfügbares Automatisierungswerkzeug in eine rationierte Ressource, die ständiges Abwägen erforderte.
Das Team erkannte, dass die Produktivitätsvorteile von KI-Agenten aus hochfrequenter Interaktion erwachsen. Solange jeder Aufruf variable Kosten verursacht, schrecken Entwickler instinktiv vor der Nutzung zurück. Die Voraussetzung für ungehindertes Arbeiten bestand darin, unvorhersehbare Einzelausgaben finanztechnisch in abschreibbare Anlageinvestitionen zu überführen.
56 B200-Karten drücken Mischkosten auf 0,30 Dollar pro Million Tokens
Revolut beschaffte 56 Nvidia-B200-Beschleunigerkarten für einen privaten Cluster, auf dem GLM-5.3 bereitgestellt wird. Unter Einrechnung von Hardware-Abschreibung, Stromverbrauch und Netzwerk-Overhead pendelten sich die Vollkosten bei rund 0,30 Dollar pro Million Tokens ein. Die monatlichen Inferenzkosten fielen auf ein Zehntel ihres Höchststands unter kommerziellen APIs.
Das reichliche Rechenangebot aktivierte die Nutzungsbereitschaft im gesamten Unternehmen. Rund 2.000 Entwickler begannen, das Modell routinemäßig für Scaffolding, Refactoring von Altsystemen und Unit-Tests heranzuziehen. Die Reduktion der Codierzeit um rund 60 Prozent und die Verkürzung der Releasezyklen um 70 Prozent waren die direkte Folge aufgehobener Quoten. Abitbol räumte ein, dass hierfür keine isolierte Kontrollgruppe vorlag, doch die Beschleunigung in den Produktionspipelines war unübersehbar.
Der private Cluster musste zugleich anspruchsvolle Latenzanforderungen im interaktiven Betrieb erfüllen. Das Team definierte als Ziel für die Time to First Token (TTFT) weniger als 3 Sekunden. Interne Messungen zeigten: Überschritt die Latenz 5 Sekunden, verloren Entwickler die Geduld und wechselten den Kontext. Beim Durchsatz erwies sich eine Streaming-Rate von rund 200 Tokens pro Sekunde als völlig ausreichend für flüssige Interaktionen, sodass viele Ingenieure mehrere Refactorings parallel anstoßen konnten.
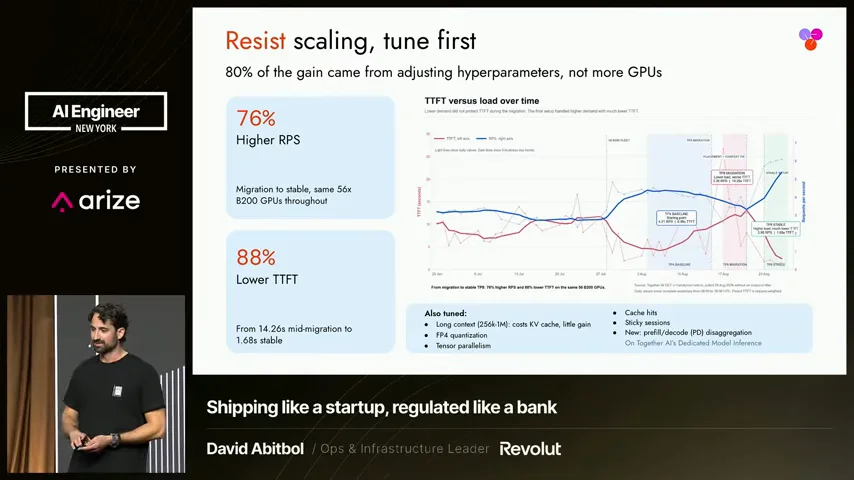 Abbildung: David Abitbol stellt auf der AI Engineer NYC 2026 die Migration der Entwicklerwerkzeuge für 2.000 Ingenieure vor. Quelle: Offizielle Keynote der AI Engineer NYC 2026.
VRAM-Engpässe erfordern tiefgreifende Inferenzoptimierung
Die bloße Anschaffung von Spitzenhardware garantiert noch keinen hochverfügbaren Dienst. Zu Beginn der Migration offenbarte der Cluster unter hoher Last gravierende Engpässe. Die durchschnittliche Reaktionszeit für den ersten Token stieg auf inakzeptable 14,26 Sekunden an, verbunden mit langen Warteschlangen.
Ohne die Zahl von 56 Karten zu erhöhen, strukturierte das Team den gesamten Inferenz-Stack um. Nach präzisem Feintuning sank die TTFT im stabilen Zustand um 88 Prozent auf 1,68 Sekunden, während die Anfragen pro Sekunde (RPS) um 76 Prozent zulegten. Die Tiefe des Feintunings entscheidet über Erfolg oder Scheitern einer On-Premises-Lösung; softwareseitige Systemoptimierungen brachten weit größere Durchsatzgewinne als der schlichte Zukauf physischer GPUs.
Das VRAM-Management bildete das zentrale Schlachtfeld. Im begrenzten Grafikspeicher konkurrieren KV-Cache und Kontextfenster zwangsläufig miteinander. Wer unüberlegt maximale Kontextgrößen reserviert, bindet statischen Speicher und würgt den parallelen Durchsatz ab. Revolut passte die Kontextfenster an reale Entwickleranfragen an und wies den freigewordenen Speicher vollständig dem dynamischen KV-Cache zu.
Auf Nvidias Blackwell-Architektur setzte das Team auf FP4-Quantisierung, um den Speicherbedarf des Modells drastisch zu verringern. Während eine vierfache Tensor-Parallelität den Cache pro Karte verengte, schaltete das Team auf achtfache Parallelität um, was dem Cluster deutlich höhere Kapazitäten für parallele Anfragen verschaffte. Multimodale Anfragen wurden zudem an separate Modelle ausgelagert, um zu verhindern, dass heterogene Berechnungen den VRAM des Coding-Modells fragmentieren.
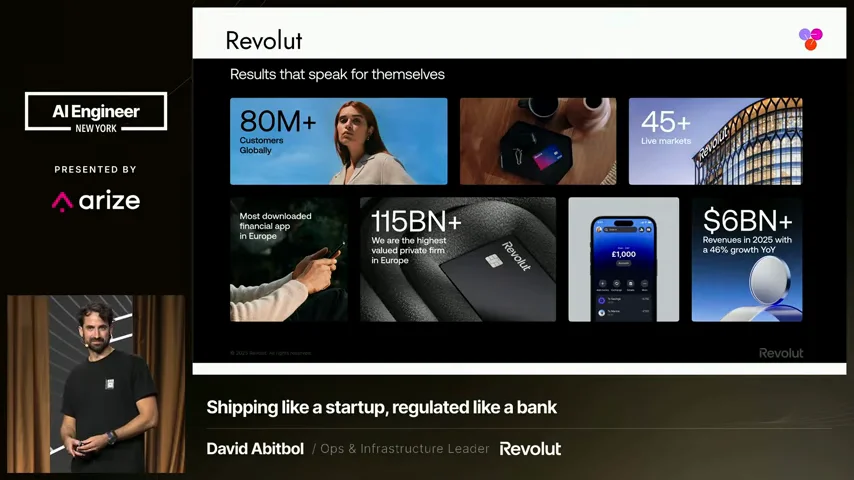 Abbildung: Architektur- und Tuning-Details des von Revolut selbst gehosteten Inferenz-Stacks. Quelle: Offizielle Keynote der AI Engineer NYC 2026.
Sandbox-Isolation und Echtzeit-Telemetrie setzen Sicherheitsstandards
Wird das Modell ins eigene Rechenzentrum verlegt, müssen Sicherheitsrichtlinien und Compliance-Audits ebenfalls in Eigenregie definiert werden. Da Finanztechnologie sensible Konten- und Regulierungsdaten berührt, könnte ein unkontrolliert agierender KI-Agent bei übermäßigen Rechten verheerende Schäden anrichten.
Revolut verließ sich nicht auf nachträgliche Stichproben. Sämtliche Code-Änderungen und Testläufe von Agenten werden ausschließlich in isolierten, temporären Sandkästen ausgeführt. Die Sandbox beschränkt das Dateisystem und die erreichbaren Netzwerkbereiche strikt. Selbst wenn destruktive Befehle generiert würden, bliebe der Schaden auf die Instanz begrenzt.
Freigaberichtlinien riegeln Produktionsumgebungen und Haupt-Branches vor riskanten Zugriffen ab. Gegen Bedrohungen durch externe Eingaben wie Prompt Injections baute das Team eine durchgängige Telemetrie-Pipeline auf. Ein lokaler KI-Agent ohne lückenlose Audit-Telemetrie entspricht im Kern einem unüberwachten Dienstkonto mit Administratorrechten im internen Firmennetz.
Anlageinvestitionen als Wette auf echte Teamauslastung
Die Grundsatzdebatte über das Self-Hosting großer Sprachmodelle bleibt intensiv. Befürworter heben die Souveränität über die Gewichte hervor: Die Kontrolle über die lokale Infrastruktur schützt vor Preiserhöhungen von Cloud-Anbietern und schafft eine verlässliche Basis für unbeschwerte Experimente der Entwickler.
Kritiker verweisen auf erhebliche versteckte Kosten. Die Abschreibung von Hochleistungsbeschleunigern ist ein unerbittlicher Fixposten, und zwischen offenen Modellen und proprietären Spitzenmodellen besteht weiterhin ein Entwicklungsabstand. Zudem müssen Unternehmen dauerhaft spezialisierte System-Engineering-Teams unterhalten, was Personalkosten und Betriebsaufwand spürbar erhöht.
Die wirtschaftliche Rentabilität des Self-Hostings hängt vollständig von der Sättigung des Clusters ab. Revolut konnte die Kosten nur deshalb auf 0,30 Dollar pro Million Tokens drücken, weil 2.000 Entwickler kontinuierlich hohe Last erzeugen. In kleineren Teams mit geringem Anfragevolumen übersteigen die anteiligen Bereitstellungskosten ungenutzter Hardware die Preise kommerzieller APIs bei weitem.
David Abitbol unterstrich, dass der Betriebsort der Gewichte entscheidender sei als ihre Herkunft. Regulatorische Rahmenbedingungen variieren zwischen Finanzinstituten stark, und Revoluts Vorgehen basiert auf der eigenen Unternehmensgröße.
Der eigentliche Mehrwert selbst gehosteter offener Modelle liegt darin, finanzielle Ungewissheit durch ingenieurtechnische Berechenbarkeit zu ersetzen. Beseitigt wird nicht primär der Rückstand bei Benchmark-Werten, sondern die mentale Hemmschwelle der Entwickler vor jedem Tastendruck.
Erst wenn Ressourcenlimits fallen, werden KI-Agenten zum selbstverständlichen Bestandteil der täglichen Entwicklungsroutine. On-Premises ist kein Allheilmittel. Doch wo Hürden abgebaut werden, erreicht die Entwicklungsgeschwindigkeit eine neue Dimension.
Weiterführende Links:
- AI Engineer NYC 2026: Keynote von Revolut zum Self-Hosting offener Modelle
- Offizieller technischer Bericht von AI Engineer