2026년 10월 13일 뉴욕에서 열린 AI Engineer 컨퍼런스에서 글로벌 디지털 뱅크 Revolut의 인프라 총괄 데이비드 아비트볼(David Abitbol)이 사내 AI 마이그레이션 실측 데이터를 전격 공개했다. 약 2,000명의 소프트웨어 엔지니어를 보유한 Revolut은 상용 폐쇄형 API 구독을 모두 해지하고, 엔비디아 B200 56대로 구성된 자체 프라이빗 클러스터에서 오픈 웨이트 모델인 GLM-5.3을 직접 구동하기 시작했다.
하드웨어 전환은 재무적으로 즉각적인 성과를 냈다. 월간 추론 총비용은 이전 상용 API 시절의 10분의 1 수준으로 줄어들었고, 복합 비용은 100만 토큰당 약 0.3달러 수준에 안착했다. 사내 샘플링 데이터에 따르면 개발자들의 실제 코딩 소요 시간은 약 60% 단축되었고, 엔드투엔드 배포 주기는 약 70% 빨라졌다. 이는 전환 전후의 상관관계를 통계적으로 집계한 수치로, 도구가 전사적으로 보급된 후 일어난 생산성 비약을 선명하게 보여준다.
오픈 웨이트 모델을 자체 호스팅하면서 얻는 궁극적인 수익률은 ‘토큰 결핍’이 유발하는 심리적 할당량을 완전히 없앴다는 점이다. 종량제 청구가 하드웨어 감가상각으로 바뀌면서 엔지니어들은 실패를 두려워하지 않고 고빈도로 프롬프트를 시도할 자유를 얻었다. 그 대신 사내 플랫폼 팀은 시스템 최적화, 샌드박스 컨테이너 격리, 원격 측정 거버넌스라는 무거운 운영 책임을 짊어지게 되었다.
종량제 과금이 불러온 엔지니어들의 ‘토큰 눈치 보기’
Revolut의 생성형 AI 도입은 주변 업무 지원에서 출발했다. 초기에는 문서 검색과 기술 명세서 파악을 위해 Gemini를 연동했고, 코딩 시간 단축과 출시 주기 개선에서 유의미한 가능성을 확인했다. 도구가 개발 핵심 파이프라인으로 깊숙이 파고들면서, 팀은 추론 역량이 한층 뛰어난 Claude Code를 도입해 복잡한 비즈니스 로직 처리와 다중 파일 디버깅까지 영역을 확장했다.
하지만 상용 모델의 청구서는 무서운 속도로 불어났다. 일부 엔지니어들이 까다로운 버그를 추적하는 과정에서 대규모 토큰을 태우며 집중적인 호출을 이어갔기 때문이다. 코드 산출량이 비용 증가에 비례해 늘어나지 않자, 경영진은 결국 개발자 개인별 사용량 한도를 설정했다.
사용량 한도 설정은 엔지니어들의 업무 방식을 순식간에 왜곡시켰다. 모든 개발자가 토큰 비용을 계산하기 시작했고, 정말 해결하기 어려운 난제를 마주했을 때만 조심스럽게 모델을 호출했다. 함수 하나를 분리하거나 단위 테스트를 추가하는 일상적인 작업은 다시 예전의 수작업으로 되돌아갔다. 종량제가 그어놓은 사용량 한계선은 언제든 부를 수 있는 자동화 도구를 끊임없이 비용을 저울질해야 하는 희소 자원으로 전락시켰다.
플랫폼 리더십은 에이전트 도구의 생산성 혁신이 고빈도 상호작용에서 나온다는 점을 깨달았다. 단 한 번의 호출이 유동적인 청구서로 이어지는 한, 개발자들은 본능적으로 사용을 기피한다. 족쇄를 풀기 위한 선결 과제는 예측 불가능한 단건 지출을 균등하게 감가상각할 수 있는 고정자산 투자로 전환하는 것이었다.
B200 56대로 100만 토큰당 비용을 0.3달러로 낮추다
Revolut은 엔비디아 B200 가속기 56대를 확보해 GLM-5.3 모델을 구동하는 프라이빗 클러스터를 구축했다. 하드웨어 감가상각, 전력 소모, 네트워크 회선 비용을 모두 합산해 안분한 결과, 종합 비용은 100만 토큰당 약 0.3달러로 수렴했다. 이를 통해 월간 추론 총비용은 상용 API 사용 정점 대비 10분의 1로 급감했다.
풍부한 연산 자원이 주어지자 전사적 호출 수요가 폭발했다. 2,000명의 엔지니어들이 스캐폴딩 생성, 레거시 코드 리팩터링, 단위 테스트 작성을 위해 수시로 모델을 호출하기 시작했다. 코딩 시간 약 60% 단축, 배포 주기 약 70% 단축이라는 놀라운 지표는 토큰 쿼터를 해제하자 자연스럽게 따라온 결과였다. 아비트볼은 엄격한 대조군 실험은 아니었음을 인정하면서도, 실제 프로덕션 현장의 개발 속도 향상은 부인할 수 없는 현실이라고 덧붙였다.
프라이빗 클러스터는 대화형 사용성을 충족하기 위해 까다로운 지연시간 기준을 충족해야 했다. 팀은 첫 토큰 응답 시간(TTFT) 목표를 3초 미만으로 설정했다. 사내 테스트 결과 응답 지연이 5초를 넘어가면 개발자들은 집중력을 잃고 다른 창으로 시선을 돌리는 것으로 나타났다. 처리량 측면에서는 초당 약 200토큰의 스트리밍 속도면 충분히 자연스러운 상호작용이 가능했고, 다수의 엔지니어들이 여러 리팩터링 작업을 병렬로 실행하는 데 무리가 없었다.
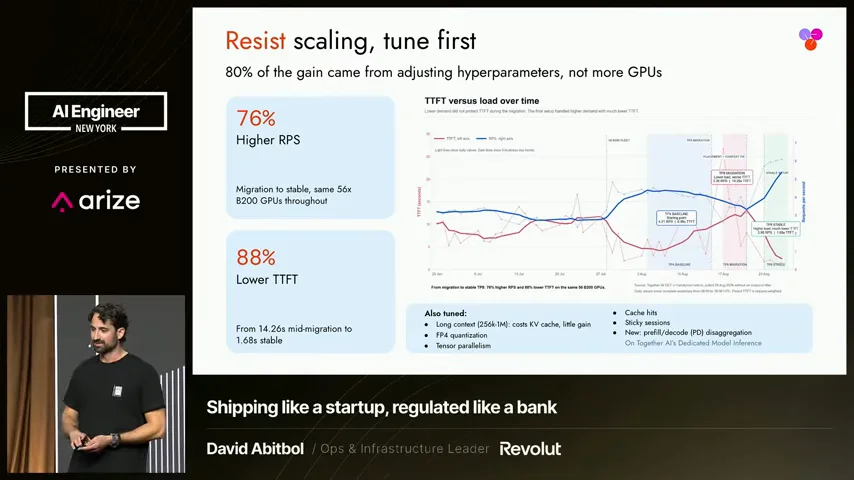 사진: 데이비드 아비트볼이 AI Engineer NYC 2026에서 2,000명 엔지니어의 코딩 도구 마이그레이션 경험을 공유하고 있다. 출처: AI Engineer NYC 2026 공식 발표
비디오 메모리 경합으로 단행된 추론 스택의 전면 최적화
최신 하드웨어를 구매했다고 해서 곧바로 고가용성 서비스가 완성되는 것은 아니다. 마이그레이션 초기 클러스터는 개발자들의 동시 접속 폭주로 극심한 병목 현상을 겪었다. 평균 TTFT는 14.26초까지 치솟았고, 요청 큐가 심각하게 밀리기 일쑤였다.
팀은 56대의 장비 구성을 그대로 유지한 채 서빙 추론 스택을 밑바닥부터 재설계했다. 정밀한 성능 튜닝을 거친 결과, 안정 상태의 TTFT는 1.68초로 88% 단축되었고, 초당 처리 요청 수(RPS)는 76%나 급증했다. 자체 구축의 성패는 시스템 튜닝의 깊이가 좌우한다. 하위 레벨의 시스템 최적화가 만들어내는 처리량 향상은 단순히 물리적 GPU를 추가하는 것보다 훨씬 강력하다.
비디오 메모리(VRAM) 관리는 추론 최적화의 최대 격전지였다. 제한된 메모리 안에서 KV 캐시와 컨텍스트 윈도우는 필연적으로 공간을 다툰다. 최대 컨텍스트 윈도우를 무턱대고 할당하면 정적 메모리가 과도하게 잠겨 동시 처리 용량이 심각하게 줄어든다. Revolut은 실제 개발자 쿼리의 통계적 길이에 맞춰 컨텍스트 크기를 현실적으로 제한하고, 아낀 메모리를 전부 KV 캐시 풀로 돌렸다.
엔비디아 블랙웰(Blackwell) 아키텍처 환경에서 팀은 모델 용량을 줄이기 위해 FP4 정밀도 양자화를 적용했다. 기존의 4방향 텐서 병렬 처리는 GPU당 캐시 용량을 압박했지만, 8방향 텐서 병렬화로 전환하자 클러스터 전체의 동시 처리 용량이 비약적으로 증가했다. 또한 멀티모달 요청은 별도의 전용 모델 인스턴스로 라우팅하여 이종 연산이 코딩 모델의 VRAM을 파편화하지 않도록 분리했다.
 사진: Revolut 오픈 웨이트 자체 호스팅 모델의 추론 스택 최적화 상세 내역. 출처: AI Engineer NYC 2026 공식 발표
샌드박스 격리와 실시간 원격 측정으로 세운 보안 방어선
모델을 사내 데이터센터로 들여오면 보안 정책과 컴플라이언스 감사의 기준선도 직접 그어야 한다. 핵심 금융 거래 원장과 엄격한 규제 데이터를 다루는 핀테크 특성상, 자율 에이전트가 권한을 넘어선 행동을 할 경우 그 파괴력은 걷잡을 수 없이 커진다.
Revolut은 사후 샘플링 검사에 기대지 않았다. 에이전트가 수행하는 모든 코드 변경과 테스트 실행은 격리된 임시 샌드박스 내부에서만 동작한다. 샌드박스는 파일시스템과 접근 가능한 네트워크 범위를 철저히 차단하므로, 설령 위험한 파괴 명령이 생성되더라도 그 영향은 컨테이너 내부로 완벽히 격리된다.
승인 정책 파이프라인은 프로덕션 환경이나 메인 브랜치를 직접 건드리는 위험한 작업을 원천 차단한다. 프롬프트 인젝션과 같은 외부 입력 위험에 대응하기 위해 전 구간 원격 측정 추적 파이프라인도 구축했다. 실시간 감사와 원격 측정이 빠진 로컬 에이전트는, 내부 인트라넷에서 감시받지 않는 최고 관리자 계정을 상시 구동하는 것과 다름없다.
고정 설비투자는 개발팀의 실제 가동률을 담보로 한 승부수
거대언어모델의 자체 구축을 둘러싼 논쟁은 여전히 팽팽하다. 찬성론자들은 가중치 주권에 주목한다. 자체 인프라를 통제하면 공급업체의 기습적인 가격 인상이나 일방적 정책 변경을 피할 수 있고, 개발팀에 무제한적인 실험 환경을 제공할 수 있다.
반면 회의론자들은 숨겨진 막대한 운영 비용을 지적한다. 최고급 가속기의 감가상각비는 피할 수 없는 고정 비용이며, 오픈소스 모델과 폐쇄형 최신 플래그십 모델 사이에는 여전히 성능 격차가 존재한다. 또한 수준 높은 인프라 튜닝 엔지니어 조직을 사내에 상시 유지해야 하므로 인건비와 유지보수 부담도 상당하다.
자체 호스팅의 경제적 타당성은 클러스터 포화율에 전적으로 달려 있다. Revolut이 100만 토큰당 0.3달러를 달성할 수 있었던 원동력은 2,000명의 엔지니어가 쉼 없이 쏟아내는 고밀도 동시 호출에 있다. 엔지니어 규모가 작고 호출 빈도가 드문 조직이라면, 하드웨어 유휴 비용이 누적되면서 실질 토큰 단가가 상용 API 비용을 훌쩍 뛰어넘게 된다.
데이비드 아비트볼은 모델의 출처보다 ‘가중치가 어디에서 구동되고 있는가’가 훨씬 중요하다고 강조했다. 금융 기관마다 적용받는 규제 기준은 제각각이며, Revolut의 해법은 자사의 고유한 규모 위에서 성립한 전략이다.
오픈 웨이트를 자체 호스팅하는 진정한 가치는 엔지니어링의 확실성으로 개발의 자유도를 쟁취하는 데 있다. 극복해야 할 장벽은 벤치마크 점수 격차가 아니라, 엔지니어가 엔터 키를 누르기 전에 망설이게 만드는 심리적 부담이었다.
컴퓨팅 자원의 제약이 사라졌을 때 에이전트는 비로소 개발자들의 일상 업무 흐름에 온전히 녹아든다. 온프레미스 구축이 모든 조직을 위한 만병통치약은 아니다. 그러나 자원의 진입 장벽을 완전히 허물었을 때, 엔지니어링 납기 속도는 전혀 다른 차원의 도약을 맞이하게 된다.
참고 링크:
- AI Engineer NYC 2026: Revolut 오픈 모델 자체 호스팅 발표
- AI Engineer 공식 기술 보고서