El 13 de octubre de 2026, durante la conferencia AI Engineer celebrada en Nueva York, el responsable de infraestructura de Revolut, David Abitbol, presentó datos detallados sobre la migración interna de sus herramientas de inteligencia artificial. La entidad bancaria digital, que cuenta con una plantilla de unos 2.000 desarrolladores de software, canceló sus suscripciones a las API comerciales propietarias para desplegar el modelo de pesos abiertos GLM-5.3 en un clúster privado equipado con 56 tarjetas Nvidia B200.
La transición de hardware generó un impacto financiero inmediato. El gasto mensual global en inferencia cayó a una décima parte de las cifras anteriores, estabilizando el coste combinado en aproximadamente 0,30 dólares por millón de tokens. Las métricas de muestreo interno revelaron que el tiempo efectivo dedicado a escribir código se redujo cerca de un 60%, mientras que los ciclos de entrega integrales se aceleraron en torno a un 70%. Estos datos, procedentes de análisis comparativos antes y después del despliegue, reflejan el salto de productividad que se produce cuando una herramienta se vuelve verdaderamente accesible para todos.
El retorno fundamental de autohospedar modelos abiertos reside en eliminar el racionamiento psicológico provocado por la escasez de tokens. Cuando la facturación por consumo se sustituye por la amortización predecible del hardware, los ingenieros adquieren la libertad de experimentar e iterar sin temor a equivocarse. A cambio, el equipo interno de plataforma asumió responsabilidades técnicas complejas: optimización a bajo nivel del sistema, aislamiento de contenedores en sandbox y gobierno de telemetría en tiempo real.
La facturación por consumo obligaba a los ingenieros a racionar tokens
Los primeros pasos de Revolut con la IA generativa se centraron en tareas periféricas de soporte. Inicialmente integraron Gemini para la búsqueda de documentación y la consulta de especificaciones técnicas, logrando mejoras palpables en los tiempos de programación y entrega. A medida que las herramientas se integraban en el núcleo del ciclo de desarrollo, el equipo incorporó Claude Code para abordar lógica de negocio compleja y resolución de errores distribuidos entre múltiples archivos.
Sin embargo, las facturas de los modelos comerciales crecieron a un ritmo alarmante. Algunos desarrolladores, inmersos en la depuración de incidencias complejas, ejecutaban cadenas de llamadas intensivas que consumían sumas desproporcionadas del presupuesto de tokens. Al constatar que la producción de código no aumentaba al mismo ritmo que los costes, la dirección impuso límites de consumo individual.
Este mecanismo de cuotas distorsionó de inmediato los hábitos de trabajo. Cada programador comenzó a calcular con recelo cada petición, limitándose a consultar al asistente únicamente ante bloqueos insalvables. Tareas cotidianas como refactorizar una función o redactar pruebas unitarias volvieron a resolverse de forma manual. Las barreras fijadas por el pago por uso transformaron una herramienta de automatización pensada para ser ubicua en un recurso escaso que exigía un cálculo constante de coste-beneficio.
La dirección técnica comprendió que las ganancias reales de productividad con agentes de IA provienen de la interacción continua y de alta frecuencia. Mientras cada consulta conlleve un sobrecoste variable, el desarrollador tenderá de manera instintiva a no utilizarla. Para desatar el potencial del equipo era imprescindible transformar un gasto operativo fluctuante en una inversión fija de capital fácilmente amortizable.
56 tarjetas B200 situaron el coste del millón de tokens en 0,30 dólares
Revolut adquirió 56 tarjetas aceleradoras Nvidia B200 para montar un clúster privado dedicado a servir GLM-5.3. Tras computar la amortización del hardware, el consumo eléctrico y la infraestructura de red, el coste unitario se situó en torno a los 0,30 dólares por millón de tokens. El gasto mensual total en inferencia se desplomó al 10% del pico alcanzado con proveedores comerciales externos.
La abundancia de capacidad de cálculo desató el uso en toda la organización. Los 2.000 ingenieros empezaron a invocar el modelo con naturalidad para generar estructuras base de proyectos, refactorizar código heredado y añadir baterías de pruebas unitarias. La reducción del 60% en el tiempo de codificación y del 70% en los plazos de entrega fueron el resultado natural de eliminar los topes de consumo. Aunque Abitbol admitió que estas mediciones carecen de un grupo de control aislado, la aceleración efectiva en los flujos de entrega a producción fue incuestionable.
El clúster privado debía cumplir además exigentes requisitos de latencia en entornos interactivos. El equipo fijó como objetivo un tiempo hasta el primer token (TTFT) inferior a 3 segundos. Los análisis internos demostraron que, si la latencia superaba los 5 segundos, los ingenieros perdían el foco y cambiaban de ventana de trabajo. En términos de caudal, una tasa de transmisión cercana a los 200 tokens por segundo demostró ser idónea para interacciones fluidas, permitiendo a los desarrolladores lanzar múltiples tareas de refactorización en paralelo.
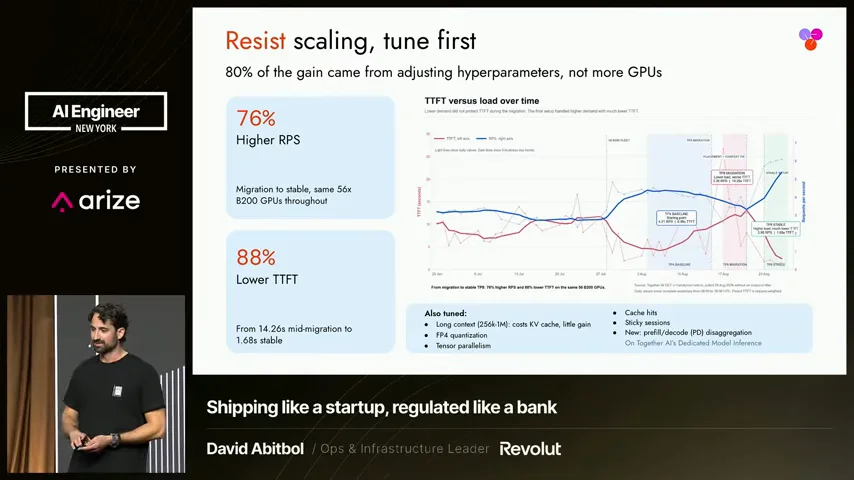 Foto: David Abitbol presentando la migración de herramientas de desarrollo para 2.000 ingenieros en AI Engineer NYC 2026. Fuente: Ponencia oficial de AI Engineer NYC 2026.
La contención de VRAM forzó una optimización profunda del motor de inferencia
Comprar hardware de última generación no equivale a disponer de un servicio de alta disponibilidad. Durante los primeros compases de la migración, el clúster sufrió graves cuellos de botella bajo picos de concurrencia. El TTFT medio se degradó hasta unos inadmisibles 14,26 segundos, provocando acumulación constante de peticiones en cola.
Sin incorporar más tarjetas a las 56 existentes, el equipo rediseñó por completo la pila de inferencia. Mediante un ajuste minucioso, el TTFT en régimen estable se redujo un 88% hasta situarse en 1,68 segundos, al tiempo que las solicitudes por segundo (RPS) aumentaron un 76%. La profundidad técnica de la optimización determina el éxito o fracaso del autohospedaje; las mejoras a bajo nivel aportaron un incremento de capacidad muy superior al que habría supuesto comprar más tarjetas gráficas.
La gestión de la memoria de vídeo (VRAM) fue el campo de batalla decisivo. En un entorno de alta concurrencia, la caché KV y la ventana de contexto compiten directamente por el espacio de memoria disponible. Reservar indiscriminadamente ventanas de contexto máximas bloquea memoria estática de forma permanente y estrangula la concurrencia. Revolut dimensionó las ventanas en función de la distribución real de consultas de sus desarrolladores, liberando una cantidad sustancial de VRAM que se reasignó íntegramente a la caché KV dinámica.
Bajo la arquitectura Blackwell de Nvidia, el equipo aplicó cuantización a precisión FP4 para comprimir el tamaño del modelo en memoria. El paralelismo tensorial en 4 vías saturaba la capacidad de caché de cada GPU individual; sin embargo, al pasar a paralelismo tensorial en 8 vías, el clúster liberó un margen de concurrencia sensiblemente superior. Por otro lado, las peticiones multimodales se enrutaron hacia modelos independientes para evitar que cálculos heterogéneos fragmentaran la memoria del modelo principal de código.
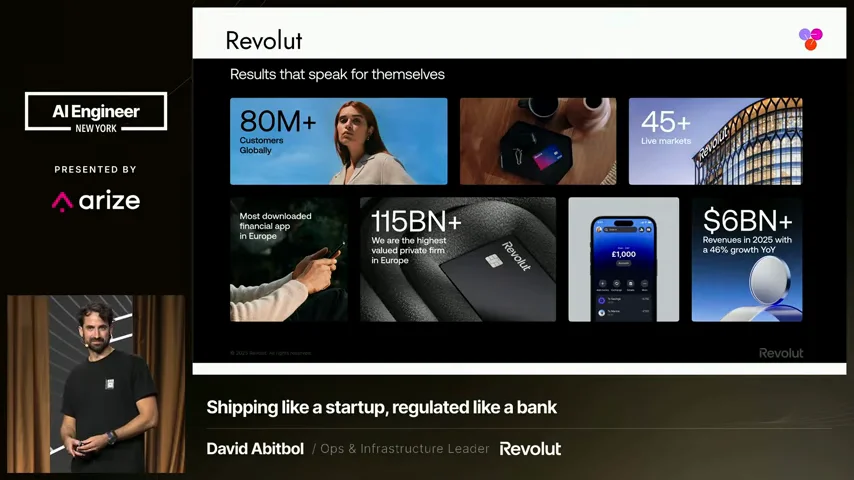 Foto: Detalles de arquitectura y ajuste de la pila de inferencia autohospedada de Revolut. Fuente: Ponencia oficial de AI Engineer NYC 2026.
Aislamiento en sandbox y telemetría en tiempo real: los pilares de la seguridad
Trasladar la ejecución del modelo al centro de datos propio obliga a definir y gestionar internamente todas las políticas de seguridad y cumplimiento normativo. En una entidad fintech que gestiona libros contables bancarios y datos financieros sujetos a estricta regulación, las extralimitaciones de un agente autónomo pueden tener un impacto crítico si cuenta con permisos excesivos.
Revolut descartó conformarse con auditorías puntuales a posteriori. Cada modificación de código y ejecución de pruebas dirigida por un agente se ejecuta de forma aislada dentro de un sandbox efímero. Este entorno restringe con precisión el acceso al sistema de archivos y las conexiones de red. Incluso si el modelo generase comandos destructivos, el impacto queda confinado estrictamente dentro del contenedor.
Diversas reglas de aprobación automatizadas bloquean cualquier intento de interactuar con ramas principales o entornos de producción. Para neutralizar riesgos derivados de entradas externas, como la inyección de prompts, la empresa implementó una infraestructura integral de telemetría y rastreo. Un agente local que carezca de telemetría y auditoría continua equivale, en la práctica, a mantener cuentas con altos privilegios sin supervisión operando dentro de la red corporativa.
El gasto de capital: una apuesta condicionada a la saturación del equipo
El debate sobre la conveniencia de alojar modelos masivos en local sigue muy vivo. Sus partidarios defienden la soberanía sobre los pesos: controlar la infraestructura local blinda frente a subidas de precios de terceros y sienta las bases para que los desarrolladores investiguen sin ataduras presupuestarias.
Quienes muestran reticencias subrayan los elevados costes ocultos. La amortización de aceleradores de gama alta representa un gasto fijo considerable, mientras que los modelos abiertos aún deben recortar distancias frente a los buques insignia comerciales. Además, las organizaciones deben retener equipos altamente especializados en ingeniería de sistemas, lo que dispara los costes operativos y de personal.
La rentabilidad económica del autohospedaje depende por completo de la tasa de utilización del clúster. Si Revolut logró un coste de 0,30 dólares por millón de tokens fue gracias a las solicitudes masivas y continuas generadas por sus 2.000 ingenieros. En equipos más reducidos con patrones de consulta esporádicos, el coste imputable al hardware ocioso hace que el precio efectivo por token supere con creces las tarifas de las API comerciales.
David Abitbol subrayó que el factor crítico no es quién entrenó el modelo, sino dónde residen y se ejecutan sus pesos. Las exigencias regulatorias difieren según la jurisdicción financiera, y el camino elegido por Revolut responde directamente a su escala operativa.
El valor principal de autohospedar modelos abiertos consiste en sustituir la incertidumbre económica por certezas de ingeniería. No busca únicamente acortar distancias en pruebas sintéticas de rendimiento, sino eliminar las dudas del desarrollador cada vez que pulsa la tecla Enter.
Cuando las cuotas de cálculo desaparecen, los agentes inteligentes se integran de forma natural en el flujo de trabajo diario. La infraestructura privada no es una solución universal; sin embargo, al suprimir las barreras de acceso a los recursos, la capacidad de entrega de los equipos de ingeniería alcanza un nivel de eficiencia inédito.
Enlaces de referencia:
- AI Engineer NYC 2026: Conferencia de Revolut sobre autohospedaje de modelos abiertos
- Informe técnico oficial de AI Engineer