2026年10月13日、ニューヨークで開催された「AI Engineer」カンファレンスにて、英デジタルバンク大手Revolutのインフラ責任者David Abitbol氏が登壇し、社内AI環境の大規模移行データを公開した。約2000名のエンジニアを抱える同社は、商用プロプライエタリAPIの利用を打ち切り、56基のNVIDIA B200 GPUで構成されたオンプレミス環境でオープンウェイトモデル「GLM-5.3」の自社ホスティングへ舵を切った。
このハードウェア移行がもたらした財務的インパクトは即座に現れた。月間の推論コスト総支出は従来の10分の1へと圧縮され、混合コストは100万トークンあたり約0.3ドルを達成した。社内サンプリング調査によると、全エンジニアの純コーディング時間は約60%削減され、エンドツーエンドのデリバリーサイクルは約70%短縮された。これらは移行前後の相関統計に基づく数値であり、ツールが全社に浸透したことによる開発効率の飛躍を裏付けている。
オープンウェイトモデルを自社運用する最大の価値は、「トークン不足」が引き起こす心理的制限の撤廃にある。従量課金がハードウェア減価償却費に置き換わることで、エンジニアは失敗を恐れず高頻度に試行錯誤できる自由を手に入れた。その一方で、プラットフォームチームは低レイヤのチューニング、サンドボックス隔離、テレメトリ監査といった重い運用責任を自ら引き受けることとなった。
従量課金がもたらした「トークン節約の心理的ブレーキ」
RevolutにおけるAI活用の模索は、周辺的なサポートタスクから始まった。当初はGeminiを導入してドキュメント検索や技術仕様の整理に活用し、コーディング時間や納期の短縮で手応えを得ていた。活用範囲が開発パイプラインの核心に及ぶにつれ、より高度な推論力を持つClaude Codeを導入し、複雑なビジネスロジックの実装や複数ファイルにまたがるデバッグへの適用を試みた。
しかし、商用モデルの請求額は爆発的なペースで膨らんだ。難度の高いバグ修正に直面した一部のエンジニアが集中的なAPIコールを実行し、大量のトークン予算を消費したためである。コード成果物が請求額に比例して増えなかったことから、経営陣はエンジニア個別の利用量上限を設ける決定を下した。
この利用制限は、エンジニアの行動様式を即座に歪めてしまった。誰もがトークン消費を過剰に意識するようになり、本当に解決困難な問題に直面したとき以外はAIを呼び出さなくなった。関数のリファクタリングや単体テストの追記といった日常作業は、再び手作業へと逆戻りした。従量課金が課したクォータ制限は、いつでも頼れる自動化ツールを「コストを気にしながら恐る恐る使う希少資源」へと変貌させてしまったのである。
チームは、AIエージェントによる生産性向上の本質が「高頻度のインタラクション」にあることを痛感した。1回の呼び出しが変動費として跳ね返る限り、エンジニアは本能的に利用を抑制する。現場の足枷を外すための前提条件は、予測不可能な都度課金を、均等に減価償却できる固定資産投資へと転換することだった。
56基のB200が100万トークンあたり0.3ドルを実現
Revolutは56基のNVIDIA B200アクセラレータカードを調達し、GLM-5.3を稼働させるプライベートクラスタを構築した。ハードウェア減価償却費、電力コスト、ネットワーク費用をすべて按分した総合コストは、100万トークンあたり約0.3ドルで安定。これにより、月間の総推論コストは商用APIピーク時の10分の1へと激減した。
計算資源の潤沢な供給は、エンジニア全員の利用意欲に火をつけた。約2000名のエンジニアがスキャフォールディングの生成、レガシーコードの刷新、単体テスト補完のために日常的にモデルを呼び出し始めた。コーディング時間の約60%削減、デリバリーサイクルの約70%短縮という劇的な成果は、まさに利用枠の撤廃がもたらした必然の帰結である。Abitbol氏は厳密な対照実験ではないと認めつつも、プロダクション環境における開発スピード向上は疑いようのない事実だと強調した。
自社クラスタには、対話型ユースケースに耐えうる厳しいレイテンシ基準が課された。チームはFirst Token到達時間(TTFT)の目標値を3秒未満に設定。社内テストでは、TTFTが5秒を超えた瞬間にエンジニアは集中力を切らし、別のウィンドウへコンテキストスイッチしてしまうことが判明した。スループット面では約200 tok/sのストリーミング速度で十分に対話性を担保でき、多くの開発者が並行して複数のリファクタリングタスクを進めるようになった。
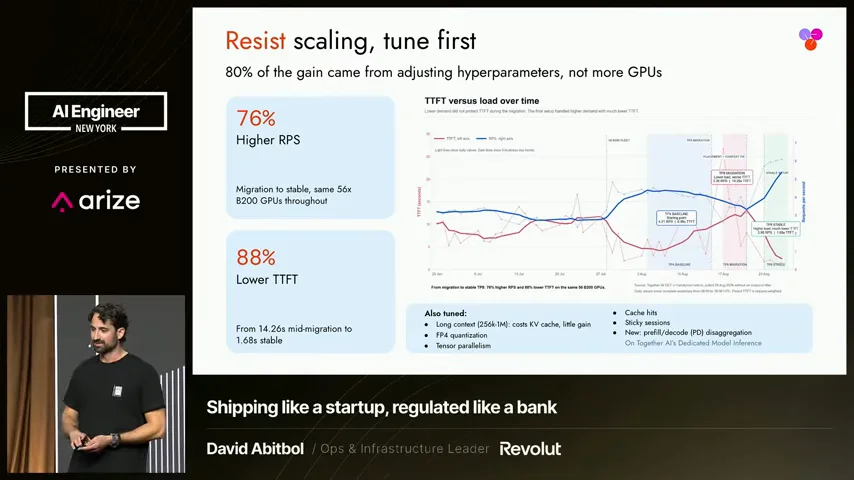 図:David Abitbol氏がAI Engineer NYC 2026にて2000名規模のエンジニア開発基盤移行を発表。出典:AI Engineer NYC 2026 公式登壇
VRAM競合がチームに迫った推論スタックの徹底最適化
最新鋭のハードウェアを買い揃えたからといって、高可用性サービスが手に入るわけではない。移行初期、クラスタは同時アクセスの急増によって深刻な性能劣化に見舞われた。平均TTFTは14.26秒まで悪化し、リクエストのキュー滞留が日常茶飯事となった。
チームはGPUを増設することなく、56基の構成のままで推論スタックを抜本的に再設計した。緻密なチューニングを重ねた結果、定常状態のTTFTは88%削減されて1.68秒に短縮され、1秒あたりのリクエスト処理数(RPS)は76%向上した。インフラ運用の成否を分けるのはチューニングの深度であり、低レイヤのシステム最適化が生み出すスループット向上は、単にGPUを買い足すよりも遥かに大きな効果を発揮する。
推論最適化における最大の主戦場はVRAM管理であった。高並行環境下において、KVキャッシュとコンテキストウィンドウは限られたメモリを激しく奪い合う。最大コンテキスト長を盲目的に確保すると静的メモリ領域が占有され、結果として同時リクエスト処理能力が激減する。Revolutは実際の開発リクエストの分布に合わせてコンテキストサイズを動的に調整し、浮いたメモリを余さずKVキャッシュ領域へと還元した。
Blackwellアーキテクチャ上でチームはFP4精度量子化を採用し、モデルのメモリフットプリントを圧縮。従来の4並列テンソル並列では1基あたりのキャッシュ容量が圧迫されていたが、8並列テンソル並列へ切り替えることで、クラスタ全体の並行スループットが大幅に向上した。さらにマルチモーダルリクエストは別系統のモデルへとルーティングし、ヘテロジニアスな計算処理がコーディング用モデルのVRAMを断片化するのを防いだ。
 図:Revolutがオープンウェイトモデル自社ホスティングで実施した推論スタックの最適化詳細。出典:AI Engineer NYC 2026 公式登壇
サンドボックス隔離とリアルタイム監査が築くセキュリティ境界
モデルを自社データセンターへ持ち込んだ以上、セキュリティポリシーとコンプライアンス監査の境界線も自ら定義しなければならない。金融テクノロジー企業として基幹勘定や機密規制データを扱う以上、自律型エージェントの権限逸脱は即座に致命的なリスクへと波及する。
Revolutは事後的なサンプリング監査に頼る方針を退けた。エージェントによるコード変更やテスト実行は、すべて完全に隔離されたエフェメラルなサンドボックス内部で実行される。サンドボックスによってファイルシステムやアクセス可能なネットワークが厳格に封鎖されているため、仮に破壊的なコマンドが生成されたとしても、その影響範囲はコンテナ内部で食い止められる。
本番環境やメインブランチへの直接アクセスは、厳格な承認ポリシーによって遮断される。またプロンプトインジェクションなどの外部入力リスクに対しては、全リクエストを監視するテレメトリ追跡パイプラインを構築した。監査テレメトリを欠いたローカルエージェントは、本質的に「監視されない高権限アカウントを社内ネットワークで常時稼働させている」ことと同義である。
固定資産支出はチームの実利用率との真剣勝負
LLMの自社ホスティングをめぐる議論は今なお続いている。推進派はウェイト主権を高く評価する。社内にインフラを保有していれば、クラウドベンダーによる突然の値上げやAPI仕様変更のリスクを回避でき、現場に制約なき試行錯誤の土壌を提供できる。
一方で懐疑派は、表面化しにくい莫大な隠れコストを問題視する。最上位アクセラレータの減価償却費は避けられない固定支出であり、オープンモデルと商用最上位フラッグシップモデルの間には性能差も存在する。また高度なシステムチューニングを担う専任エンジニアチームを社内に維持し続ける必要があり、人件費と保守費用は決して小さくない。
自社ホスティングの経済的優位性は、クラスタの稼働率飽和に強く依存している。Revolutが100万トークンあたり0.3ドルという低コストを叩き出せたのは、約2000名のエンジニアが途切れることなく高密度なリクエストを送り続けているからに他ならない。チーム規模が小さく利用頻度がまばらな組織では、ハードウェアのアイドル減価償却が重なり、実質的なトークン単価は商用APIを大幅に上回ってしまう。
David Abitbol氏は、モデルの出所よりも「ウェイトがどこで稼働しているか」が重要だと説く。金融機関ごとに規制の解釈は大きく異なるが、Revolutの選択は同社固有のスケールメリットを最大限に活かした結論である。
オープンウェイトを自社ホストする本質的価値は、エンジニアリングの確実性によって開発の自由度を買い取ることにある。克服すべきハードルはベンチマークスコアの優劣ではなく、エンジニアがEnterキーを押す瞬間に抱く心理的躊躇だった。
計算リソースの制限が消え去ったとき、自律型エージェントは真の意味で日々の開発ワークフローに溶け込む。オンプレミス化は万人に向けた処方箋ではない。だが資源の壁を取り払ったとき、エンジニアリングの生産性はかつてない高みへと解放される。
参考リンク:
- AI Engineer NYC 2026:Revolutによるオープンモデル自社運用の講演
- AI Engineer 公式技術レポート