Le 13 octobre 2026, lors de la conférence AI Engineer organisée à New York, David Abitbol, responsable des infrastructures chez Revolut, a dévoilé les données chiffrées de la migration IA interne de la fintech. La néobanque, qui emploie près de 2 000 ingénieurs logiciels, a résilié ses abonnements aux API commerciales propriétaires. Elle fait désormais tourner le modèle en poids ouverts GLM-5.3 sur son propre cluster de 56 puces Nvidia B200.
La bascule matérielle a produit un impact budgétaire immédiat. Les dépenses mensuelles globales d’inférence ont chuté à un dixième des niveaux antérieurs, ramenant le coût de revient mixte à environ 0,30 dollar par million de tokens. Selon les relevés d’échantillonnage internes, le temps effectif d’écriture de code a diminué d’environ 60 %, tandis que les cycles de livraison de bout en bout se sont raccourcis de près de 70 %. Issus de corrélations statistiques avant et après le déploiement, ces chiffres témoignent du bond d’efficacité provoqué par la démocratisation totale de l’outil.
Le bénéfice fondamental de l’auto-hébergement de modèles ouverts réside dans la suppression du rationnement psychologique né de la pénurie artificielle de tokens. Lorsque la tarification à l’usage cède la place à l’amortissement prévisible du matériel, les ingénieurs retrouvent la liberté d’expérimenter et d’échouer à cadence élevée. En contrepartie, l’équipe interne a dû s’approprier des chantiers d’ingénierie lourds : optimisation bas niveau de l’ordonnancement, isolation des environnements en bac à sable et gouvernance de télémétrie en continu.
La facturation à l’usage poussait les ingénieurs à rationner leurs requêtes
L’exploration de l’IA générative chez Revolut a débuté par des missions de soutien périphérique. Les équipes ont d’abord connecté Gemini pour l’interrogation de documentation et la clarification des spécifications techniques, constatant de premiers gains sur le temps de développement et les délais de livraison. Au fur et à mesure que les outils s’ancraient dans la chaîne de production logicielle, l’entreprise a intégré Claude Code, plus performant pour le raisonnement complexe, la logique métier et le débogage multi-fichiers.
Toutefois, la facture des modèles propriétaires a explosé à un rythme alarmant. Certains ingénieurs confrontés à des anomalies complexes lançaient des sessions intensives, consommant des tranches colossales du budget de tokens. La production de code n’augmentant pas en proportion directe des coûts engagés, la direction a fini par imposer des quotas individuels de consommation.
Ce plafonnement a immédiatement faussé les pratiques des développeurs. Chacun s’est mis à calculer méticuleusement ses requêtes, ne sollicitant l’assistant qu’en dernier recours devant des obstacles critiques. Des opérations de routine, comme factoriser une fonction ou rédiger une batterie de tests unitaires, sont redevenues entièrement manuelles. Le couperet du paiement à l’usage a métamorphosé un outil d’automatisation censé être disponible à tout instant en une ressource rare exigeant un arbitrage coût-bénéfice permanent.
Les responsables ont compris que le gain de productivité des agents découle d’une interaction fluide et répétée. Tant que chaque sollicitation est indexée sur une facture fluctuante, les ingénieurs s’autocensurent par réflexe. Pour libérer la dynamique d’adoption, il fallait impérativement transformer une charge opérationnelle volatile en un investissement d’infrastructure amortissable.
56 cartes B200 ramènent le million de tokens à 0,30 dollar
Revolut a fait l’acquisition de 56 cartes accélératrices Nvidia B200 afin d’assembler un cluster privé dédié à l’exécution de GLM-5.3. En agrégeant l’amortissement du matériel, la consommation électrique et la bande passante réseau, le coût consolidé s’est stabilisé autour de 0,30 dollar par million de tokens. Le budget mensuel global alloué à l’inférence est ainsi retombé à 10 % du montant atteint au plus fort des abonnements commerciaux.
La surabondance de puissance de calcul a déverrouillé l’usage sur l’ensemble de l’organisation. Deux mille ingénieurs se sont mis à solliciter massivement le modèle pour générer des architectures de base, moderniser du code historique et compléter la couverture de tests. La baisse de 60 % du temps de développement et l’accélération de 70 % des mises en production découlent directement de la suppression des quotas. Même si David Abitbol a souligné l’absence d’un groupe témoin strictement isolé, l’accélération des déploiements en environnement réel s’est vérifiée sur le terrain.
Le cluster privé devait en outre satisfaire à des exigences de latence particulièrement rigoureuses pour préserver l’interactivité. L’équipe s’est fixé pour objectif un temps d’attente du premier token (TTFT) inférieur à 3 secondes. Les tests ont démontré qu’au-delà de 5 secondes de délai, les développeurs décrochaient et changeaient de contexte de travail. Côté débit, une vitesse de streaming d’environ 200 tokens par seconde s’est révélée idéale pour garantir un dialogue interactif et permettre aux ingénieurs de mener plusieurs refactorisations en parallèle.
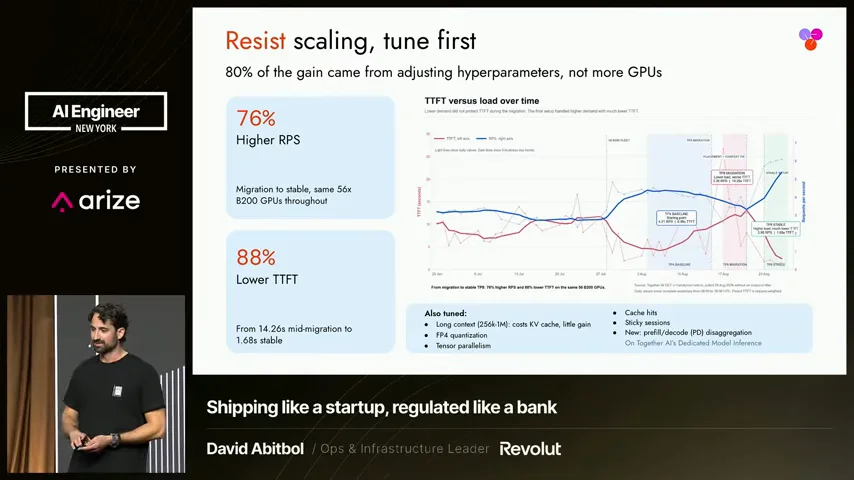 Figure : David Abitbol détaillant la migration des outils de codage pour 2 000 ingénieurs à AI Engineer NYC 2026. Source : Conférence officielle AI Engineer NYC 2026.
La saturation de la VRAM a imposé une refonte complète du moteur d’inférence
Faire l’acquisition de silicium haut de gamme ne suffit pas à garantir une plateforme à haute disponibilité. Dès les premières phases de déploiement, le cluster a subi de sévères congestions face aux pics de charge simultanés. Le TTFT moyen s’est dégradé jusqu’à un niveau critique de 14,26 secondes, générant des files d’attente chroniques.
Sans ajouter la moindre puce supplémentaire à ses 56 cartes, l’équipe a reconstruit de fond en comble sa pile d’inférence logicielle. Après un travail d’optimisation poussé, le TTFT en régime de croisière a chuté de 88 % pour s’établir à 1,68 seconde, tandis que le volume de requêtes traitées par seconde (RPS) progressait de 76 %. La maîtrise des optimisations logicielles conditionne la viabilité d’un déploiement sur site ; les gains de débit obtenus au niveau système surpassent de loin ce qu’aurait apporté un simple ajout de matériel.
La gestion de la mémoire vidéo (VRAM) a constitué le cœur de la bataille technique. Dans un contexte de forte concurrence entre requêtes, le cache KV et les fenêtres de contexte se disputent une mémoire physiquement bornée. Allouer systématiquement la fenêtre maximale de contexte fige la mémoire statique et bride l’exécution simultanée des requêtes. Revolut a réajusté la taille des contextes sur la distribution réelle des sollicitations de ses développeurs, redistribuant la mémoire ainsi récupérée au cache KV dynamique.
Sur l’architecture Blackwell de Nvidia, l’équipe a adopté la quantification en précision FP4 pour réduire l’empreinte mémoire du modèle. Si un parallélisme tensoriel sur 4 voies comprimait la mémoire cache de chaque processeur, le basculement vers 8 voies a permis au cluster de débloquer une capacité de traitement simultané bien plus élevée. De plus, les requêtes multimodales ont été aiguillées vers des modèles distincts, empêchant les calculs hétérogènes de fragmenter la VRAM allouée au codage.
 Figure : Détails d’optimisation et architecture de la pile d’inférence open-weights de Revolut. Source : Conférence officielle AI Engineer NYC 2026.
Bac à sable et télémétrie continue : ériger les fondations de la sécurité
Héberger un modèle au sein de son propre centre de données implique de tracer soi-même le périmètre des règles de sécurité et de conformité. Dans une fintech qui manipule des données bancaires critiques et des flux financiers hautement réglementés, les dérives d’un agent autonome peuvent provoquer des dégâts majeurs s’il dispose de privilèges excessifs.
Revolut a refusé de s’en remettre à de simples échantillonnages a posteriori. Chaque modification de code et exécution de test pilotée par l’agent s’opère dans des environnements sandbox éphémères et étanches. Ce cloisonnement verrouille strictement les accès au système de fichiers et aux couches réseau. Même si des commandes destructrices venaient à être produites, leur rayon d’impact resterait confiné à l’intérieur du bac à sable.
Des barrières d’approbation automatisées bloquent toute tentative d’interaction directe avec les environnements de production ou les branches maîtresses. Pour contrer les risques d’injection de prompts ou d’entrées malveillantes, l’équipe a déployé un pipeline complet de traçabilité télémétrique. Un agent d’IA exécuté localement sans audit ni télémétrie équivaut à laisser fonctionner sur son réseau d’entreprise un compte à hauts privilèges dénué de toute surveillance.
Investissement d’infrastructure : un pari conditionné à l’intensité de l’usage réel
Le débat entre modèles propriétaires et auto-hébergement reste très disputé. Les partisans de l’auto-hébergement mettent en avant la souveraineté sur les poids : maîtriser son infrastructure protège contre les hausses tarifaires unilatérales des fournisseurs et crée un espace propice aux expérimentations sans restriction budgétaire.
Les sceptiques rappellent quant à eux l’existence de coûts cachés considérables. L’amortissement financier d’accélérateurs de dernière génération constitue une charge fixe incontournable, et un écart d’ingénierie subsiste souvent entre les modèles ouverts et les grands modèles commerciaux de pointe. Par ailleurs, maintenir en interne une équipe d’ingénierie système de premier plan engendre d’importantes charges salariales et opérationnelles.
La rentabilité de l’auto-hébergement dépend directement du taux de saturation de l’infrastructure. Revolut n’a pu faire tomber son coût à 0,30 dollar par million de tokens que grâce aux flux massifs et ininterrompus de requêtes émis par ses 2 000 ingénieurs. Pour une organisation plus modeste aux volumes de requêtes sporadiques, l’amortissement du matériel inactif ferait rapidement grimper le coût unitaire bien au-delà des tarifs des API commerciales.
David Abitbol a martelé que le lieu d’exécution des poids compte davantage que leur origine première. Les obligations réglementaires variant fortement selon les juridictions bancaires, la démarche de Revolut tire parti de son échelle d’activité propre.
L’intérêt majeur d’auto-héberger des poids ouverts est d’échanger l’incertitude tarifaire contre une certitude d’ingénierie. L’obstacle levé ne réside pas seulement dans les scores de performance des benchmarks, mais dans l’hésitation psychologique qui retenait le développeur avant d’appuyer sur Entrée.
Dès lors que les restrictions d’allocation disparaissent, les agents d’assistance s’intègrent pleinement dans le quotidien du développement. L’auto-hébergement ne constitue pas une réponse universelle ; mais une fois le verrou des ressources levé, la vitesse de livraison logicielle atteint un palier inédit.
Liens de référence :
- AI Engineer NYC 2026 : Présentation de Revolut sur l’auto-hébergement de modèles ouverts
- Rapport technique officiel AI Engineer