2026 年 11 月 4 日,腾讯正式推出新一代主力模型 Hy4。官方技术文档没有优先宣传参数体量,直接把错误消除指标摆在首位。在腾讯给出的内部测试中,检索幻觉率降到了 5.45%,猜测性错误降到了 5.6%。在各家厂商争相刷新跑分峰值的阶段,将事实纠错置顶展现了不同的工程取向。
学术榜单的高分往往难以直接兑现为生产可用性。开源大模型的竞争焦点,正在从能力上限转向可信度的底线保障。腾讯给 Hy4 设定的工程路线清晰明确。团队先压制生成环节中的虚构事实行为,随后才拓展多模态与系统交互能力。
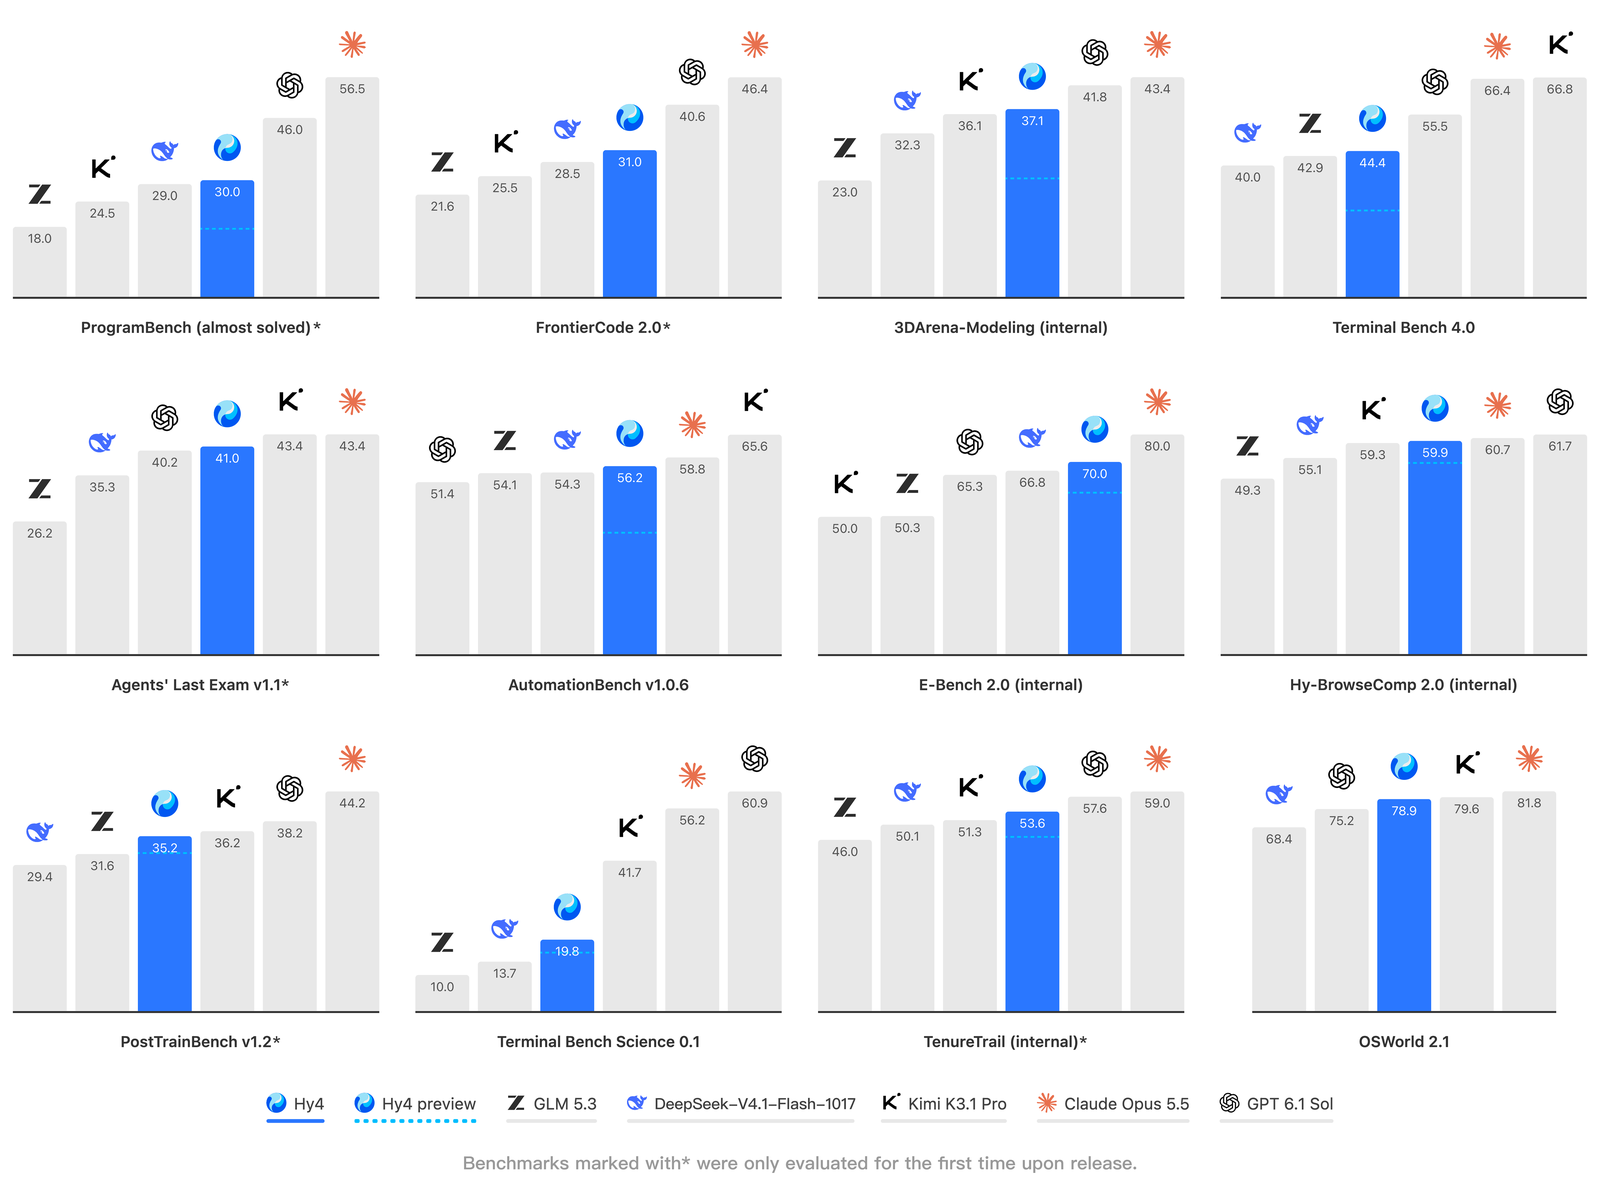 图:Hy4 主基准测试分布。重点观察其在知识检索与专业推理维度的稳定性提升。来源:腾讯混元(官方发布博客)。
削减近七成检索幻觉,工程交付不再只拼榜单上限
在企业级检索增强生成系统里,生成故障常源于检索环节的事实漂移。依据腾讯官方披露的内部评测,Hy4 的检索幻觉率由 15.76% 降至 5.45%。模型的猜测性错误发生率,也从 23.1% 同步压降至 5.6%。在严谨审计的专业领域,将幻觉率压进 6% 的刚性门槛,让自动化审查具备了运行可行性。
研发团队在后训练阶段,针对时效敏感检索与多源综合做了定向升级。团队还同步增强了输出内容的事实一致性校验机制。这项机制延伸至办公场景,重点改善了文档套件的多人实时协同编辑。多人并发修改容易导致版本冲突,注入校验机制能有效遏制状态错乱。
这些幻觉率与错误率的对比,均来自腾讯内部构建的专项评测集。自测数据主要反映了团队的优化偏好,尚待第三方的盲测复核。把错误率作为核心卖点,体现出对事实准确性的刚性量化。
213位金融人实测579个任务,开源第一靠专业场景验出来
金融业务对大模型生成错误的容忍度接近于零。腾讯金融科技联合 213 位专业人士,对 579 个真实任务展开评测。受试者中有 153 位来自头部机构,超七成拥有 5 年以上从业经历。测试任务覆盖财报数据核验与合规审查等高风险环节。
在这项 5 分制的实测中,Hy4 评测得分为 3.04 分,位列开源权重模型首位。对比模型中,DeepSeek-V4.1-Flash-1017 得分为 2.97 分。Kimi K3.1 Pro 与 GLM-5.3 的得分均为 2.68 分。这种差距主要体现在表格比对上,更低的幻觉率确保了提取指标时的稳定性。
外部行业基准也呈现出相似趋势。在包含 101 个投研任务的 IRAB 基准中,Hy4 记录为 61.63 分,比此前的预览版本高出 12.03 分。第三方机构 RabyteTech 的数据显示,Hy4 在数据查询项取得 75.4 分,超出 GPT-6.1 Sol 近 20 分。面对需要穿透多层研报的投研工作,精准检索显著压减了推演失误。
从2.8亿像素找构件到接管Blender,视觉与系统操作双向贯通
Hy4 是腾讯混元体系中首个支持视觉与计算机操作的模型。该模型同时覆盖命令行环境与图形用户界面。在官方演示中,模型在 2.8 亿像素航拍图里准确定位了屋顶微小构件。这种超高分辨率下的目标检索,直接考验了多尺度特征抽取的几何一致性。
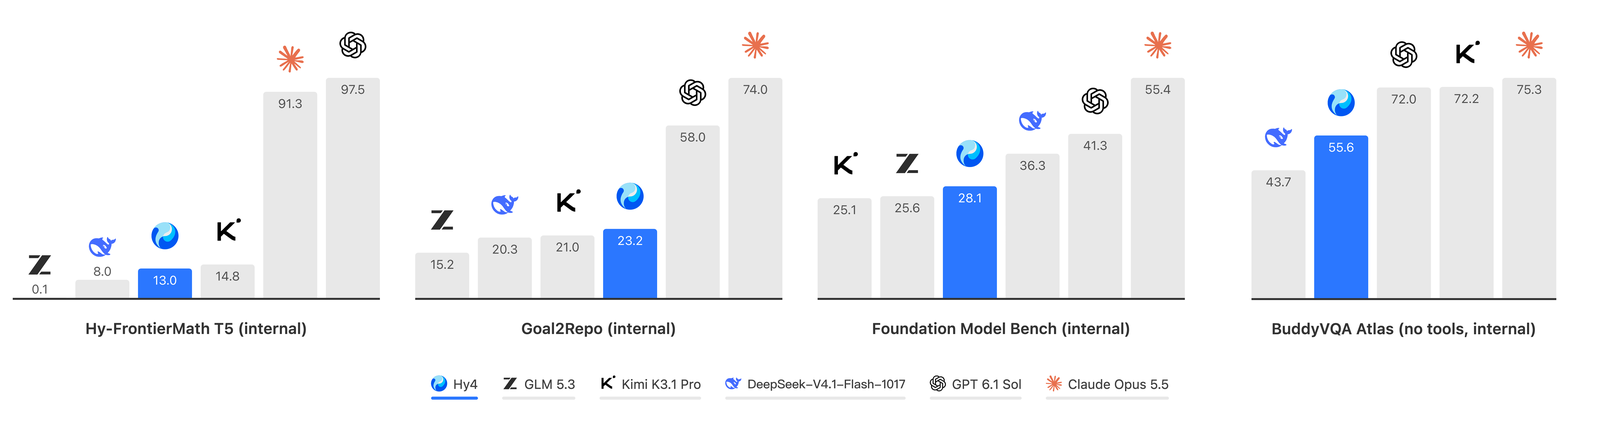 图:Hy4 在 2.8 亿像素超高分辨率航拍图中准确定位 2 米见方的屋顶构件。注意观察模型在大幅尺度缩放下对微小目标的视觉感知精度。来源:腾讯混元(官方发布博客)。
视觉感知能力的提升,直接作用于专业工程软件的交互控制。团队针对专业建模软件进行定向训练,使模型具备了跨软件执行长流程的能力。传统界面代理在面对密集二级菜单时容易丢失状态。通过将像素坐标与功能指令直接绑定,多步建模操作的操作脱轨率明显降低。
在数字内容与游戏领域,腾讯互娱参与了全套数据整理与评测设计。模型深度适配了虚幻引擎、Unity 与 Godot,并覆盖多人游戏开发。依据内部测试,Hy4 的游戏开发与逻辑生成基准分别提升 19.1% 与 9.8%。专用游戏引擎接口的融入,大幅减少了开发者手动编写样板代码的负担。
自研基础设施与严控漏洞防御,前沿差距仍写在官方卡片上
在前沿科研探索上,Hy4 开始介入复杂的专业计算流程。在覆盖 7 个基础学科的 123 项内部科研测试中,该模型保持领先。实测显示,单机仅用时 1.5 小时,便完成了 700 万细胞的胚胎三维重建。腾讯同步开源了基础模型 HyPDE 与 HyCell,并借助自研框架优化了训练效率。
 图:Hy4 完整基准评测总表。注意比对不同架构在代码、长文本与专业任务上的分项落差与追赶幅度。来源:腾讯混元(官方发布博客)。
伴随系统交互权限的开放,安全边界成为工程落地的重中之重。训练团队将网安语料收缩至防御层面,严格剔除了逆向工程与渗透攻击材料。权威实验室的红队审计显示,该模型并未抬升现实网络攻击的风险。在满分为 100 的生物安全评测中,模型得分为 30.4,未见降低生物危害门槛的证据。
官方直面技术短板,在发布说明中主动列出落差。文档坦承,模型在数学推演、长程代码构建与高难度视觉推理上仍有差距。提前标明能力边界,有助于系统设计人员合理构建故障隔离方案。清晰交代技术局限性,往往比虚高宣传更能赢得生产环境的信任。
权重未出业务先行,可信度成了工程落地的验收门槛
伴随 Hy4 发布的还有一个关键事实:模型权重尚未对外释出。官方明确表述为「计划开源权重」,权重文件与技术卡将在后续流程中同步公布。团队目前已联合 vLLM 与 SGLang 社区完成了底层推理框架的兼容支持。在权重公开发布前,腾讯优先选择自家的高并发业务线展开深度运行。
在商业化定价上,Hy4 维持了与此前预览版本相同的调用资费。缓存输入每百万 token 为 0.042 美元,标准输入与输出定价分别为 0.834 与 2.501 美元。该模型已进入腾讯云平台,后续还将推出轻量化的 Hy4 flash。稳定不变的调用资费,降低了企业客户将验证方案切入生产线的预算顾虑。
腾讯内部业务线给出的实测反馈,提供了详实的场景支撑。腾讯元宝内部评分由 65.25 升至 72.53,智能体任务完成度大幅提升。王者荣耀配置任务在自修复后准确率达 99.32%,代码缺陷定位率提升至 73.8%。WorkBuddy 浏览器操作通过率达 96.15%,验证了压低虚构率对复杂系统的关键价值。
开源大模型的演进,正在告别单纯堆砌算力与比拼榜单的早期模式。Hy4 的工程取向表明,把事实错误率压进可控区间,更能化解实际落地的核心阻碍。未公开的模型权重,仍留待开源社区给出实测检验。先用严苛业务把底线夯实,确立了务实的工程交付标准。
参考链接:
- 腾讯混元 Hy4 官方发布公告与技术博客
- 腾讯金融科技(FiT)专业场景评测报告
- RabyteTech IRAB 投研基准评测
- 腾讯玄武实验室与 Keen 安全实验室红队审计记录