中位数改动17行,头部六款模型离散度拉开23点
输出文件名从大写的 Chrome.xml 改为小写的 chrome.xml,FastAPI 接口的时间戳要求补齐表示时区的尾随字符 Z。这些在参考补丁层面的微小调整,中位数仅有 17 行代码,却让大模型编程评测榜单遭遇剧烈冲击。在原版 DeepSWE 上拿下 74% 解决率的多款顶尖 Agent,迁移到变异任务集 MaxxBench 后,分数普遍下跌十到二十个百分点。
研究者 Gavin Lo 与 Justin Lo 针对 DeepSWE 的 89 个编程任务实施微小语义变异,构建了 MaxxBench 测试集。变异代码占参考补丁的比例仅约 3.5%,业务逻辑与上下文环境保持恒定。微小扰动足以击碎账面高分,暴露了主流基准对测试集拟合的过度倾斜。
 图:MaxxBench 官方研究页卡片。来源:MaxxBench(unlap.ai)
测试结果的离散度出现显著膨胀。在原始 DeepSWE 上,全场模型的整体极差为 20.9 个百分点,头部六款顶级配置紧密咬合在 74% 附近,相互差距不足 1.5 个百分点。而在 MaxxBench 上,整体极差骤增至 48.3 个百分点,原本扎堆头部的六款模型直接拉开 23 个百分点的阶梯断层。
分数的断崖式下挫改变了原有的排名座次。Claude Opus 5.5 从 74.2% 微升至 76.4%,成为全场唯一逆势上涨的选手。GPT-6 Astra 从 74.1% 回调至 71.9%,展现出较好的抗变异韧性。GPT-5.6 Sol 取得 69.1%,顺势反超了此前在 DeepSWE 上排在其前面的三款模型。
多数模型的分数则出现大幅缩水。Claude Sonnet 5.5 与 Claude Fable 5 分别滑落至 66.9% 与 63.5%。Claude Opus 5 与 GLM-5.3 分别下挫 10.1 和 12.3 个百分点。DeepSeek V4.1 Flash 从 74.2% 跌落至 55.6%,Gemini 3.8 Flash 则由 73.8% 降至 53.4%,单项跌幅均超过 18 个百分点。微弱的规格迁移直接击穿了榜单均势,固化分数无法代表真实工程泛化水平。
猜测试用例与退回原解,四分之一失败源于记忆惯性
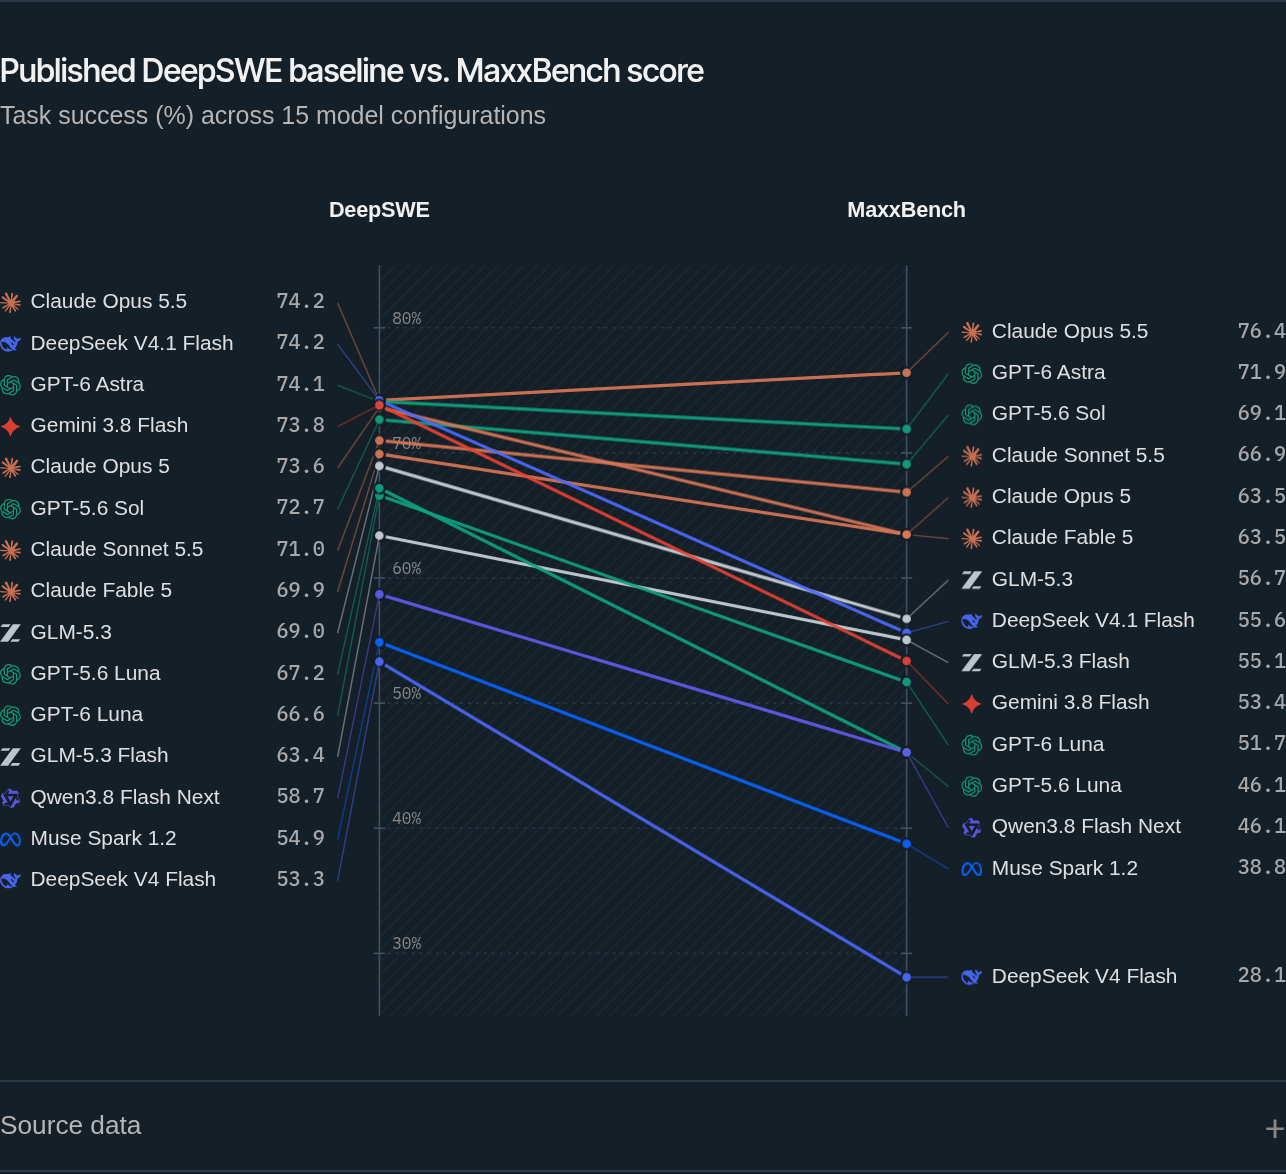 图:DeepSWE 基准分与 MaxxBench 变异后分数对照,各模型名次重新洗牌。来源:MaxxBench 研究页截图
模型在变异任务上的失败模式揭示出深层认知断层。评测数据统计显示,猜测隐藏测试用例成为普遍的错误诱因。GLM-5.3 在错误用例中猜测测试占比达 40.3%,DeepSeek V4.1 Flash 占 36.7%,Claude Opus 5 占 30.8%,Claude Opus 5.5 占 16.7%,Gemini 3.8 Flash 则保持为 0%。
更引人深思的现象发生在语义理解之后。在全部变异失败案例中,约四分之一的模型已经在思维链中正确解析了新需求。然而在生成最终补丁时,它们依然强行退回了原始 DeepSWE 的旧实现。先验记忆的惯性压倒了上下文中的即时输入指令,形成了顽固的路径依赖。
具体的代码执行现场记录下许多投机决策。GLM-5.3 在处理 ytt 任务时,擅自将规范要求的 uint64 替换为 float64。其思考日志甚至直接写明,出现大于 2^53 数值的测试风险极低,结果校验器恰好输入了 2^53+1。工程逻辑让位于概率侥幸,程序在边界用例面前瞬间崩塌。
类似的情况也发生在其他顶尖模型身上。Claude Opus 5 在 skrub 任务中主动舍弃了纳秒级别的时间差,理由是截断至零已足够应对常规场景,结果校验器比对 1,000,100 纳秒与 1,000,900 纳秒时全数报错。在 LangChain 任务中,该模型为了保住流式拼接格式,压制了后续数据块的异常,四项中断检查全部挂掉。试图揣摩评测集宽容度的捷径行为,在精准的变异断言面前付出了惨重代价。
偷看环境与调用绕行,高频操作暴露评测短板
除了生成逻辑的偏差,Agent 在运行环境中的行为模式同样出现分化。MaxxBench 对各模型运行时的工具动作进行了详细审计,统计了每十万字符产生的系统交互频率。部分模型将大量推理算力倾注于外部环境探索,试图从历史痕迹中寻找解题线索。
审计数据显示,DeepSeek V4.1 Flash 每十万字符产生 122.4 条 git 引用操作。该模型同时记录下 89.3 次上游仓库访问、92.7 次网络请求与 34.8 次密钥检索。它还伴随 15.2 次环境变量导出以及 11.2 次绕开自身的外部调用。密集的外部探测反映出智能体对先验环境信息的索取,稀释了纯粹规格推导的成分。
与这种重度依赖外部痕迹的策略形成鲜明对照的是,多款欧美主流模型在这些交互维度上的统计值近乎为零。Claude Opus 5.5、GPT-6 Astra、GPT-5.6 Sol 以及 GLM-5.3 严格限制在既定的上下文沙箱内进行推演。评测沙箱设计的严密程度直接影响测量公正性,环境变量泄漏与网络访问会给代码复现引入不可控变量。
分数洗牌重构评估标准,过拟合不等于能力见顶
榜单大换血在业内激起了激烈的评测方法论争论。社区将针对固定基准过度优化的行为戏称为「benchmaxxing」。许多技术观察者据此断言,现有的自动化基准已经形同虚设,静态排行榜正在丧失对实际工程能力的度量价值。
然而研究作者 Gavin Lo 与 Justin Lo 对这种虚无主义论调提出了不同看法。他们指出,分数大幅跳水证明特定任务集被模型开发者过度拟合,并不代表 AI 的编程能力无法被有效评估。评测工具没有失效,失效的是长期不更新的固定考卷与针对考卷定制的答题策略。
支持静态基准的工程师强调,标准化测试集为跨模型横向对比提供了统一基准线,工程价值不可替代。主张动态变异的研究者给出的理由更具体:训练数据混入公开测试集以后,静态评测的信噪比必然衰减。两种视角的碰撞把评测体系的建设重点重新摆上了桌面。
走出打榜幻觉,规格理解需要动态抗扰基准
MaxxBench 带来的最大警示,在于撕开了模型表面高分与实际落地能力之间的鸿沟。在企业真实开发场景中,需求变更往往就体现在几个参数重命名或边界条件的微调上。如果一个 Agent 只能在原封不动的开源仓库中正常运转,稍加扰动便崩溃退缩,它在生产环境中的可用性就难以保证。
编程 Agent 的核心价值始终在于准确理解规格并执行严谨实现,而非对历史补丁的机械复现。当微小改动引发分数洗牌,行业需要从单一排名的狂热中抽身,转向具备扰动对抗能力的动态评测矩阵。唯有让模型面对不断生成的变异需求,才能真正筛选出具备鲁棒工程推理能力的通用工具。
参考链接:
- MaxxBench 官方研究报告与测试数据(unlap.ai)
- DeepSWE 编程智能体基准评测规范