Le 27 octobre 2026, Google DeepMind a levé le voile sur Genie 4, son modèle de monde interactif de nouvelle génération. Une simple pression sur une touche permet de déambuler dans un décor généré en direct, le clapotis des flaques résonnant immédiatement aux oreilles de l’utilisateur. Pourtant, lors du point presse technique qui a suivi, les chercheurs n’ont pas masqué les limites du système : cet environnement façonné par les algorithmes commence à se déformer après seulement deux minutes de simulation continue.
Une touche suffit : image et son synchronisés en moins d’une seconde
Jusqu’alors, la majorité des modèles vidéo ne produisaient que des séquences silencieuses, le son devant être assemblé lors d’une phase de post-production. Genie 4 réalise pour la première fois une inférence multimodale synchronisée : bruits de pas, souffle du vent et dialogues entre personnages sont calculés nativement au cours de la même passe d’inférence que les images. DeepMind insiste sur le fait que l’ensemble des éléments sonores émane directement du modèle, éliminant tout temps de latence imputable à des modules audio distincts.
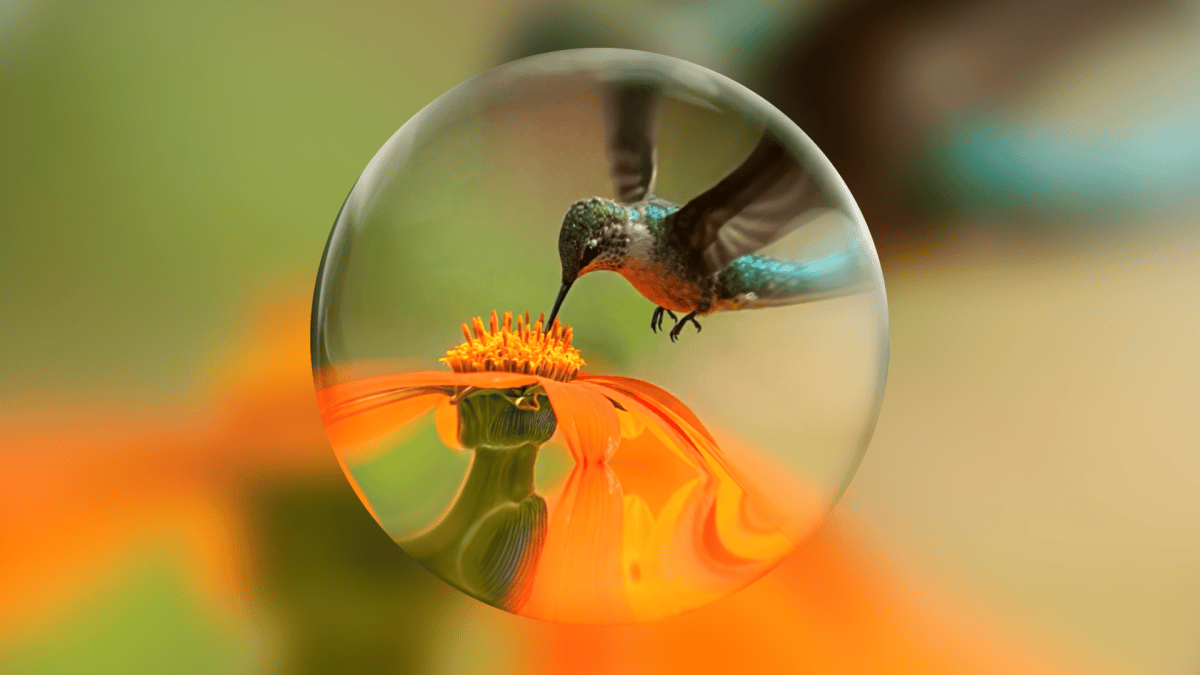 Scène interactive générée en direct par Genie 4. Le modèle calcule dynamiquement la cinématique physique et les reflets lumineux à partir des commandes au clavier. Source : TechCrunch / Google DeepMind.
Gemini Omni fait office de colonne vertébrale perceptive, calquant le rendu visuel et la dynamique des mouvements sur les lois du monde réel. Réactions aux chocs et résistance de l’air obéissent à des comportements naturels. En tâche de fond, un modèle de raisonnement scrute la scène en permanence, traduisant les requêtes saisies en langage naturel en commandes de contrôle environnemental. Il suffit d’écrire une invite pour déclencher une pluie torrentielle ou introduire de nouveaux protagonistes dans l’espace virtuel.
L’expérience ne réclame aucun script contraignant issu des moteurs de jeu classiques. Demandez au ciel de s’assombrir sous un violent orage, et le modèle simule spontanément les éclats de lumière sur le bitume détrempé. Cette capacité à métamorphoser le langage en simulation physique libère les concepteurs de la programmation manuelle des animations.
Entre deux saisies au clavier, le système perpétue son cycle de simulation autonome. Les passants poursuivent leur chemin le long des rues, le décor refusant de se figer dès que l’utilisateur relâche ses commandes. Cette avancée est accessible sous la forme d’un aperçu de recherche, et une liste d’attente s’ouvrira dans les prochaines semaines pour les abonnés à l’offre AI Ultra.
Le regard s’échappe puis revient : le livreur se coiffe soudain d’un casque
Dès la mise en ligne des vidéos de démonstration, la communauté des développeurs s’est empressée de disséquer chaque extrait image par image. Dans une ruelle hongkongaise, un coursier à moto s’élance d’abord tête nue au milieu de passages étroits. La caméra pivote pendant une demi-seconde ; lorsqu’elle revient sur le véhicule, le pilote arbore subitement un casque étincelant sur la tête. Lors d’une autre séquence montrant le vol d’un dragon, la vue contourne une crête rocheuse avant de se retourner, laissant surgir au milieu de la plaine une imposante forteresse de pierre tout juste matérialisée.
Une scène capturée sur un quai de gare a mis en lumière une anomalie semblable : des voyageurs cheminant en arrière-plan ont muté d’aspect en marchant, un long trench-coat se transformant en t-shirt à manches courtes en un clin d’œil. Tant qu’un objet demeure dans le champ visuel de la caméra, la cohérence spatiale se montre remarquablement robuste. Dès qu’un élément franchit les limites de l’écran, le système ne conserve toutefois aucune coordonnée géométrique en trois dimensions ni état spatial dans sa mémoire.
Quand la caméra revient vers l’emplacement initial, l’algorithme n’a d’autre choix que d’improviser une reconstitution de pixels en s’appuyant uniquement sur le contexte sémantique alentour. Diego Rivas, chercheur chez DeepMind, a concédé que cette dérive des détails s’accentue inexorablement avec le temps. Pour l’heure, les textes inscrits dans l’environnement restent illisibles et la texture sonore connaît des décrochages. L’équipe rappelle qu’il s’agit d’une phase de recherche exploratoire dont la forme commerciale définitive reste à inventer.
Les observateurs techniques se montrent particulièrement attentifs à ces anomalies de rendu. S’il était aisé de préserver la continuité spatiale hors champ, DeepMind aurait certainement éliminé ces artefacts avant de diffuser ses démonstrations. La présence intacte de ces faux raccords dans les vidéos officielles illustre à quel point la mémoire spatiale persistante constitue l’un des verrous théoriques et pratiques majeurs de l’IA générative.
L’évidence d’un nourrisson, le plafond de deux minutes pour les grands modèles
Vers l’âge de huit mois, les nourrissons acquièrent une intuition fondamentale : la « permanence de l’objet ». Lorsqu’un jouet est recouvert par une couverture, le bébé sait pertinemment qu’il n’a pas disparu et tend naturellement la main pour le retrouver. Les modèles génératifs actuels sont totalement dépourvus de ce principe de conservation spatiale. Ils se comportent comme un peintre improvisateur qui esquisserait frénétiquement là où porte son regard, oubliant tout dès que la perspective s’éloigne.
 Architecture de fonctionnement de Genie 4 dévoilée par DeepMind. Le modèle s’appuie sur l’inférence contextuelle pour assurer la cohérence à court terme, mais la mémoire longue subit une accumulation exponentielle d’erreurs. Source : Google DeepMind.
Sur le plan technique, Genie 4 repousse le plafond de cohérence continue à deux minutes, soit exactement le double de Genie 3, présenté en août 2025. Doubler cette durée a exigé une débauche exponentielle de puissance de calcul, et l’allongement de la fenêtre de contexte n’est pas parvenu à endiguer l’accumulation d’erreurs. Faute d’ancrage géométrique rigide, les micro-déviations d’une seule image se démultiplient en quelques dizaines de secondes jusqu’à provoquer l’effondrement visuel global du décor.
Les moteurs de jeu vidéo traditionnels stockent indéfiniment les maillages 3D et l’état des objets dans la mémoire graphique. Quelle que soit la distance parcourue par un joueur avant son retour, un verre posé sur une table demeure scrupuleusement immobile. Les modèles de monde, quant à eux, font l’économie des coordonnées pour prédire l’image suivante par de simples lois de probabilité. Cette méthode offre une richesse visuelle saisissante, mais peine à garantir une permanence physique rigoureuse.
Les géants rachètent des startups pour faire rêver et tester leurs robots
En dépit de ces lacunes évidentes, les modèles de monde suscitent un engouement frénétique de la part des géants de la tech. Il y a quelques mois, Runway dévoilait GWM Worlds 2. Le fabricant de semi-conducteurs AMD s’est emparé de World Labs, fondé par Fei-Fei Li, tandis qu’Amazon négocie le rachat de Decart. De son côté, le constructeur de véhicules électriques Rivian a racheté Third Dimension afin d’évaluer ses dispositifs de conduite autonome.
Le principal moteur de ces manœuvres financières consiste à offrir aux robots physiques un banc d’essai virtuel à faible coût pour multiplier les phases d’apprentissage par essai-erreur. Lors des expérimentations de Google en robotique, le modèle Gemini 4 Argon décompose les tâches élémentaires. Genie 4 calcule ensuite en direct les réactions physiques, permettant aux algorithmes de valider leurs mouvements dans des simulations immersives. Le directeur de recherche Tejas Kulkarni souligne que les architectures hybrides traceront la voie d’avenir du domaine.
Pour autant, Genie 4 demeure fort éloigné d’un véritable outil de simulation pour l’ingénierie. Dans le monde physique, un robot qui brise un verre laisse des éclats sur le sol ; avec un modèle de monde, pivoter la caméra puis revenir peut faire réapparaître une surface impeccablement nette. Les premiers testeurs estiment que l’usage le plus pertinent aujourd’hui réside dans la prévisualisation et la conception de storyboards conceptuels pour le cinéma et le jeu vidéo. Les artistes peuvent y esquisser des atmosphères à la volée, sans être entravés par la rigueur millimétrée de chaque détail physique.
La frontière technologique des modèles de monde continuera de reposer sur la cohérence spatiale. Genie 4 prouve que les algorithmes savent tisser en direct des univers interactifs dotés d’images et de sons réactifs. Mais tant que persistera la réinitialisation des objets hors champ, ce monde continuera de s’évanouir après deux minutes. Il offre aux créateurs un carnet de croquis d’une agilité remarquable, mais ne saurait encore tenir lieu de simulateur physique intransigeant.
Liens de référence :
- Annonce officielle de recherche de Google DeepMind
- Enquête détaillée de TechCrunch
- Débat technique au sein de la communauté des développeurs sur Hacker News