Am 27. Oktober 2026 stellte Google DeepMind Genie 4 vor, sein interaktives Weltmodell der nächsten Generation. Ein einfacher Tastendruck genügt, um eine dynamisch generierte Umgebung zu erkunden – das Platschen von Schritten in Wasserpfützen erklingt in Echtzeit. Doch im anschließenden technischen Briefing benannten die Entwickler unverblümt die Grenzen des Systems: Nach mehr als zwei Minuten ununterbrochener Simulation beginnt die algorithmisch gewebte Welt spürbar zu zerfallen.
Tastendruck genügt: Bild und Ton entstehen synchron in Echtzeit
Bisherige Videogenerierungsmodelle lieferten vorwiegend stumme Bildfolgen; Geräuscheffekte mussten in der Nachbearbeitung mühsam synthetisiert werden. Genie 4 vollzieht nun erstmals eine synchrone multimodale Inferenz. Schritte, Windgeräusche und die Stimmen interagierender Charaktere werden direkt innerhalb der Einzelbild-Inferenz des Modells berechnet. DeepMind betont, dass sämtliche akustischen Signale endogen im Modell entstehen, wodurch die Latenzzeiten separater Audiopipelines vollständig entfallen.
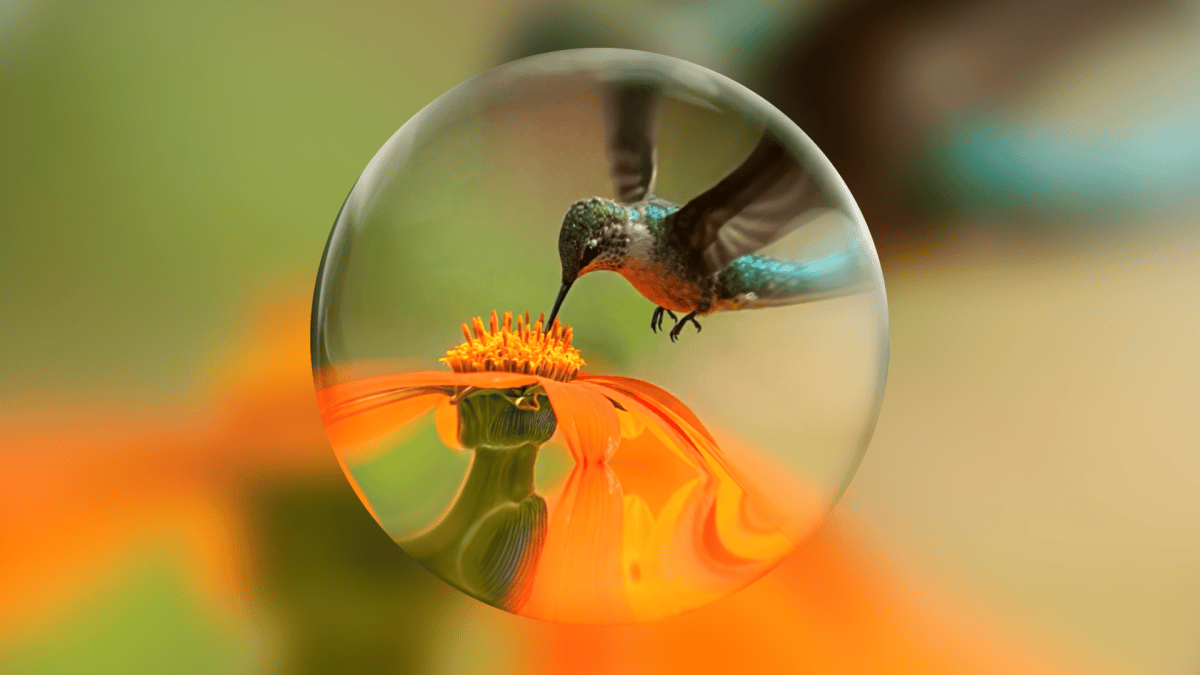 Von Genie 4 in Echtzeit generierte Szene. Das Modell berechnet physikalische Bewegungsabläufe und Lichtverhältnisse dynamisch anhand von Tastatureingaben. Quelle: TechCrunch / Google DeepMind.
Gemini Omni dient als sensorisches Rückgrat, das visuelle Erscheinung und physikalische Abläufe an der realen Welt eicht. Kollisionsdynamik und Luftwiderstand folgen intuitiven Gesetzmäßigkeiten. Im Hintergrund überwacht ein Inferenzmodell kontinuierlich das Geschehen und übersetzt spontane Texteingaben in Steuerbefehle für die Umgebung. Nutzer können durch einfache Befehle sintflutartige Regengüsse auslösen oder neue Akteure in die Szene setzen.
Die Interaktion erfordert keinerlei starre Spiel-Engine-Skripte. Tippt der Nutzer ein, dass es regnen soll, simuliert das Modell automatisch spiegelnde Wasserflächen auf dem Asphalt. Diese Fähigkeit, natürliche Sprache in physikalische Simulationen zu übersetzen, erspart das manuelle Verfassen von Skripten und Animationspfaden.
Selbst in den Pausen zwischen zwei Tastenanschlägen läuft die Simulation autonom weiter. Passanten setzen ihren Weg fort; die Welt friert bei Bedienpausen keineswegs ein. Die Technologie steht derzeit als Research Preview bereit. In den kommenden Wochen soll eine Warteliste für Abonnenten von AI Ultra freigeschaltet werden.
Kamera weggedreht und zurückgeschwenkt: Lieferfahrer trägt plötzlich Helm
In der Entwickler-Community wurden die veröffentlichten Democlips umgehend Bild für Bild seziert. In einer Straßenszene aus Hongkong fährt ein Lieferant zunächst ohne Kopfbedeckung durch eine enge Gasse. Schwenkt die Kamera für eine halbe Sekunde zur Seite und kehrt zurück, trägt der Fahrer wie aus dem Nichts einen fabrikneuen Schutzhelm. In einer anderen Sequenz mit einem fliegenden Drachen umrundet der Blickwinkel einen Gebirgskamm – beim Zurückschwenken ragt auf der zuvor leeren Ebene plötzlich eine massive Steinburg empor.
Ähnliche Inkonsistenzen traten auf einem Bahnsteig auf: Weiter entfernt laufende Passanten veränderten mitten in der Bewegung ihre Kleidung – ein langer Trenchcoat mutierte binnen Sekundenbruchteilen zu einem kurzärmeligen T-Shirt. Solange Objekte im Sichtfeld verweilen, bleibt die räumliche Konsistenz bemerkenswert stabil. Sobald Gegenstände jedoch den Bildausschnitt verlassen, speichert das System weder 3D-Koordinaten noch geometrische Zustände im Speicher ab.
Schwenkt die Kamera an die Ausgangsposition zurück, bleibt dem Algorithmus nichts anderes übrig, als Pixel anhand des umgebenden semantischen Kontexts improvisiert neu zusammenzusetzen. DeepMind-Forscher Diego Rivas räumte ein, dass diese Detaildrift mit fortschreitender Zeit zunimmt. Schriftzüge im Bild sind bislang kaum lesbar, und auch bei der Tonqualität kommt es zu Aussetzern. Das Team betont, dass es sich um eine frühe Forschungsphase handelt und die finale Produktform noch völlig offen ist.
Die Fachwelt reagiert sensibel auf diese Bildfehler. Wäre es einfach, die Kontinuität verdeckter Objekte zu gewährleisten, hätte DeepMind diesen Mangel in den offiziellen Demonstrationen zweifellos behoben. Dass die Fehler unverhüllt in den Veröffentlichungen verbleiben, belegt, dass ein persistentes räumliches Gedächtnis eine ungelöste Kernherausforderung der gesamten KI-Branche darstellt.
Was Kleinkinder intuitiv begreifen, überfordert KI-Modelle nach zwei Minuten
Menschliche Säuglinge entwickeln etwa im Alter von acht Monaten ein grundlegendes Verständnis für Objektpermanenz. Wird ein Spielzeug unter einer Decke versteckt, weiß das Kind, dass der Gegenstand weiterhin existiert, und greift gezielt danach. Heutigen generativen Modellen fehlt dieses Prinzip der Raumerhaltung völlig. Sie agieren eher wie improvisierende Maler, die fieberhaft den Bildausschnitt füllen, auf den der Blick fällt, und alles wieder vergessen, sobald sich die Perspektive abwendet.
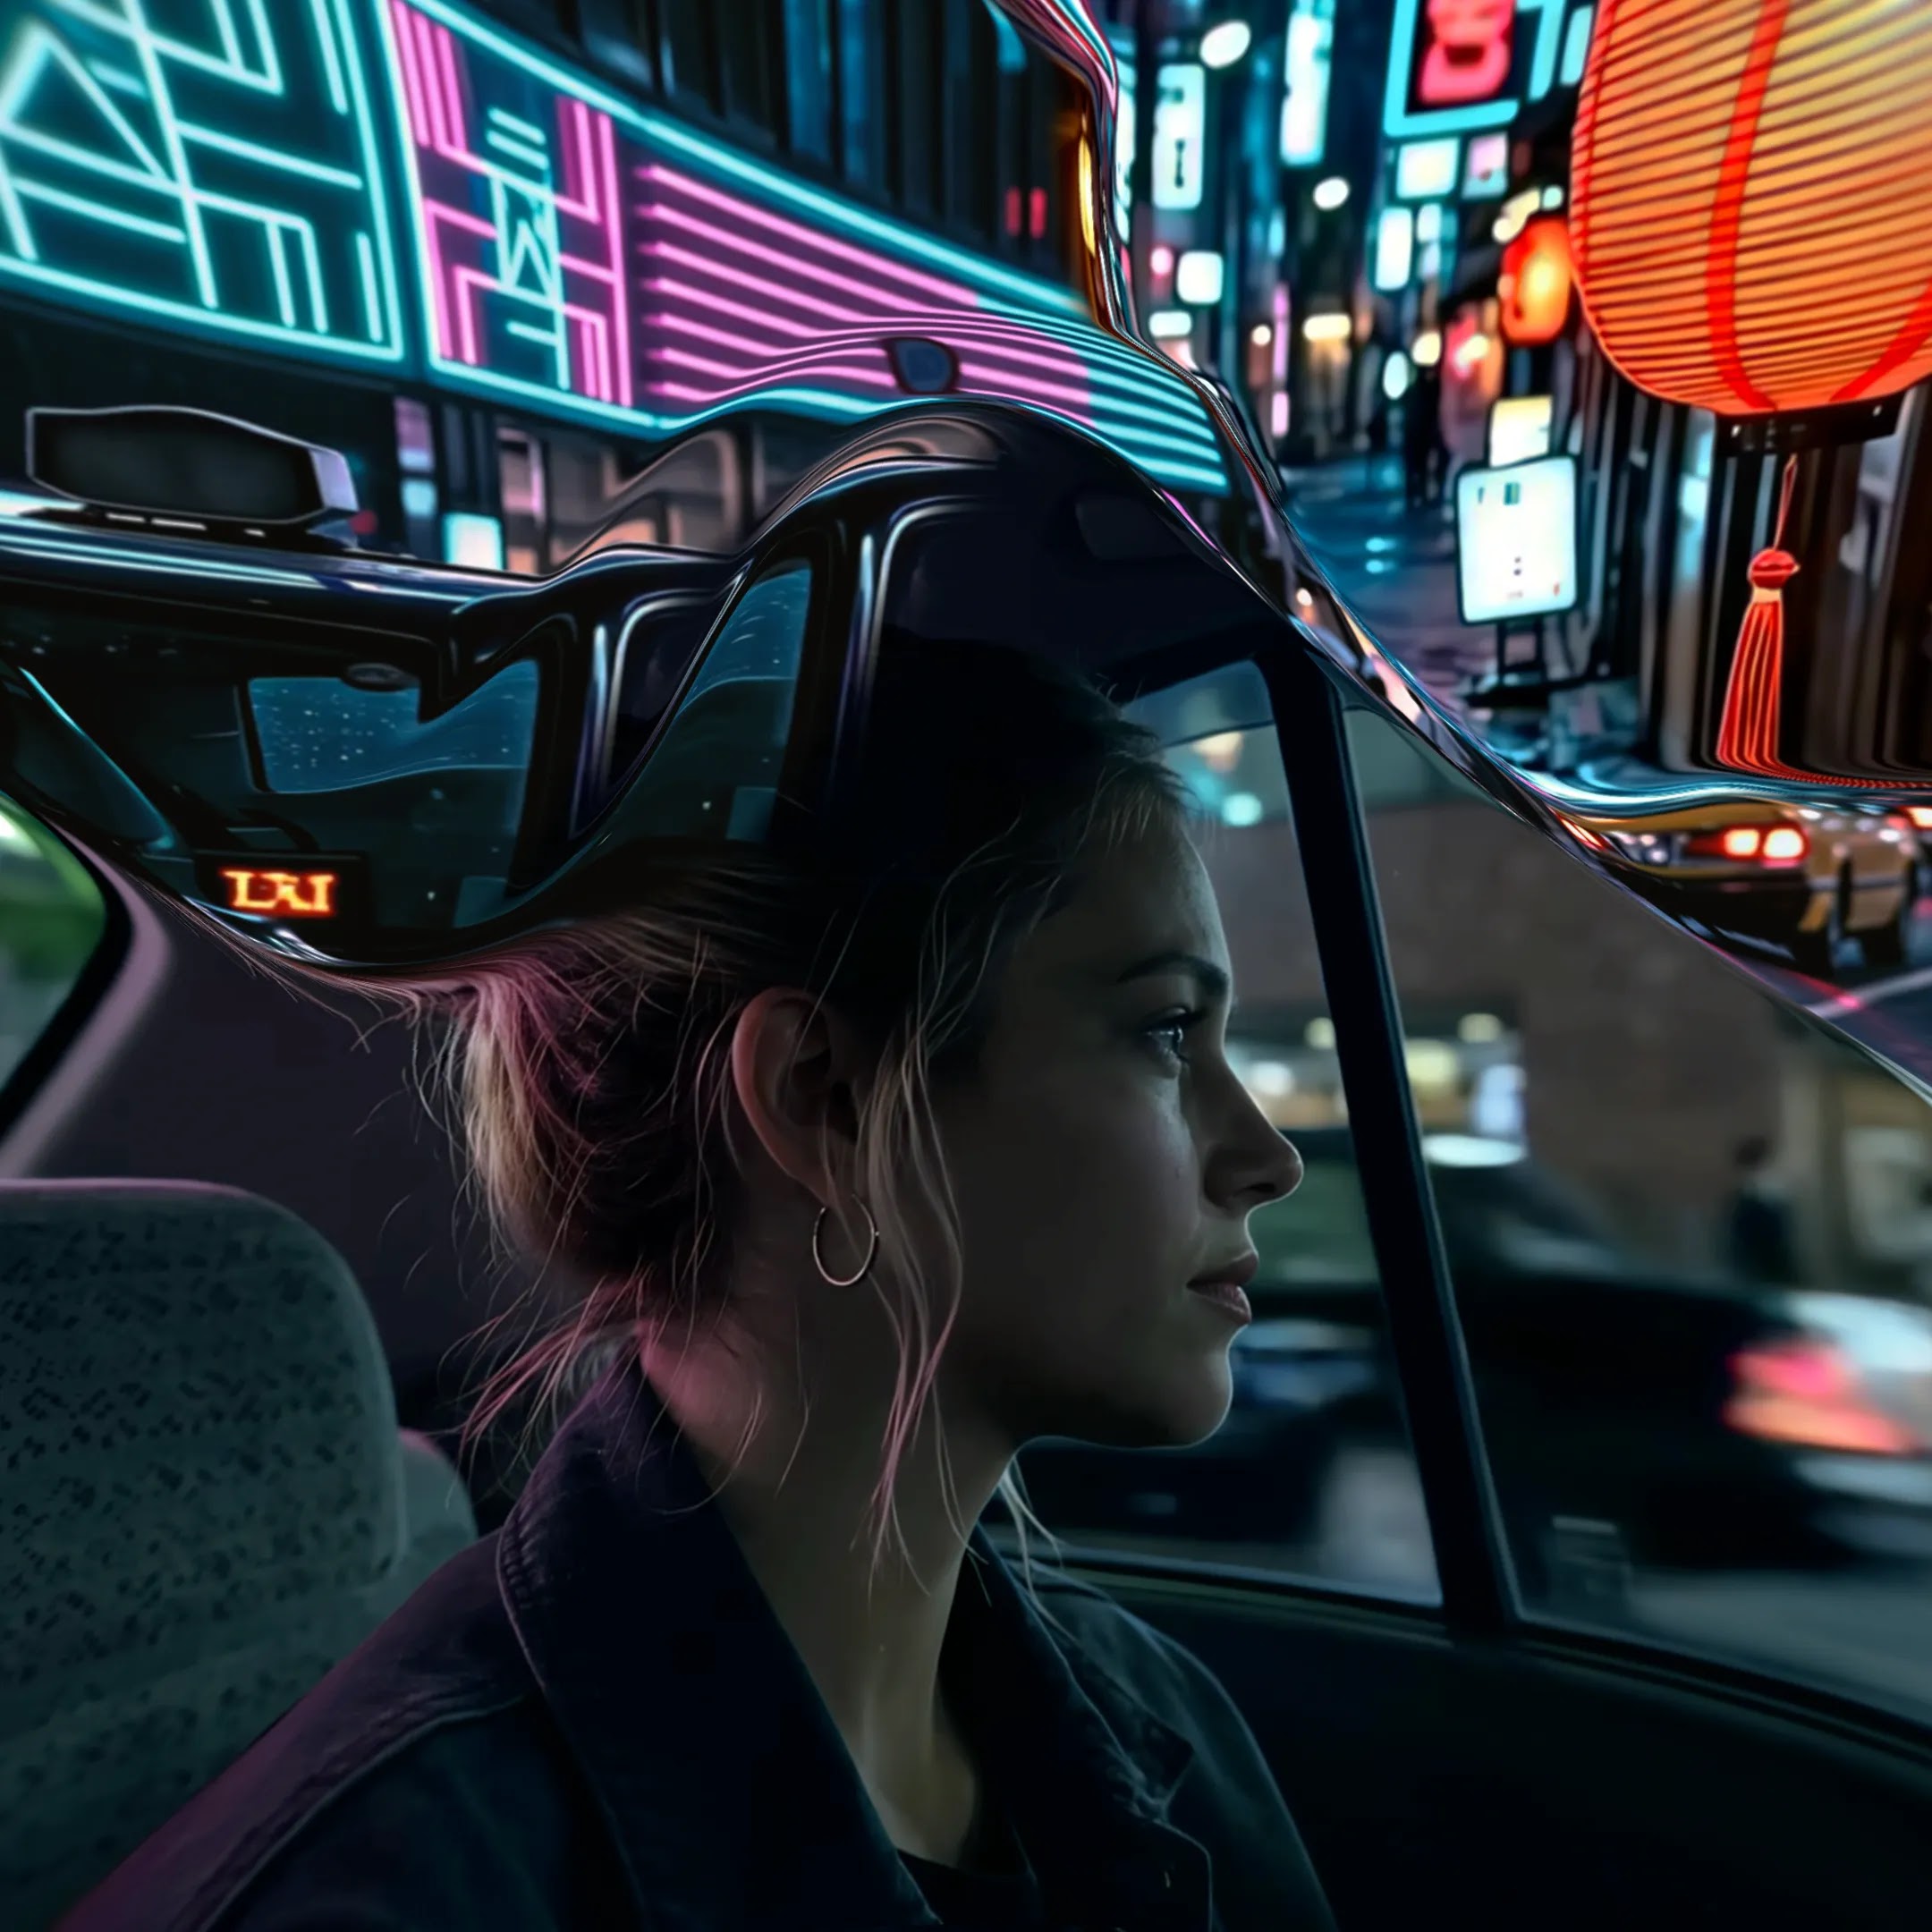 Die von DeepMind präsentierte Architektur von Genie 4: Das Modell stützt sich auf Kontextinferenz für kurzzeitige Kohärenz, kämpft im Langzeitgedächtnis jedoch mit exponentiell anwachsenden Fehlern. Quelle: Google DeepMind.
Aus technischer Sicht verschiebt Genie 4 die Grenze der Szenenkohärenz auf zwei Minuten. Das ist exakt doppelt so lang wie beim Vorgängermodell Genie 3 aus dem August 2025. Diese Verdoppelung erfordert jedoch einen exponentiellen Rechenaufwand, und das erweiterte Kontextfenster kann die Fehlerakkumulation nicht stoppen. Ohne starre geometrische Schranken summieren sich kleinste Bildabweichungen innerhalb von Sekunden zu einem vollständigen Zusammenbruch der Simulation.
Klassische Game-Engines legen 3D-Meshes und Objektzustände dauerhaft im Grafikspeicher ab. Egal wie weit sich ein Spieler entfernt und wann er zurückkehrt: Das Glas auf dem Tisch bleibt unberührt an seinem Platz. Weltmodelle hingegen umgehen geometrische Koordinaten und schätzen nachfolgende Pixel direkt aus Wahrscheinlichkeitsverteilungen ab. Das erzeugt verblüffende visuelle Vielfalt, scheitert jedoch an der Forderung nach verlässlicher physikalischer Permanenz.
Tech-Giganten kaufen Start-ups, um Roboter im virtuellen Traum zu trainieren
Trotz dieser offensichtlichen Mängel liefern sich Technologiekonzerne ein Wettbieten um aufstrebende Weltmodell-Start-ups. Vor wenigen Monaten veröffentlichte Runway sein Modell GWM Worlds 2. Der Chiphersteller AMD übernahm das von Fei-Fei Li gegründete World Labs, während Amazon Übernahmegespräche mit Decart führt. Der Elektroautobauer Rivian sicherte sich das Unternehmen Third Dimension zum Testen autonomer Fahrsysteme.
Hinter diesen milliardenschweren Investitionen steht ein klares Ziel: Physischen Robotern soll ein kostengünstiges virtuelles Übungsfeld für permanentes Ausprobieren geboten werden. In Robotikexperimenten von Google zerlegt das Modell Gemini 4 Argon komplexe Aufgabenfolgen in Einzelschritte. Genie 4 simuliert anschließend die physikalischen Rückmeldungen in Echtzeit, sodass Steuerungsalgorithmen Abläufe gefahrlos in synthetischen Welten proben können. Forschungsdirektor Tejas Kulkarni bezeichnet hybride Architekturen als den entscheidenden Zukunftspfad der Branche.
Doch das aktuelle Genie 4 ist von präzisen technischen Simulationen noch meilenweit entfernt. Zerspringt in der Realität ein Glas, bleiben die Scherben liegen; im Weltmodell ist der Boden nach einer kurzen Drehung möglicherweise wieder makellos sauber. Frühe Tester sehen das praxisnächste Einsatzgebiet derzeit in der Konzeptvisualisierung und im Storyboarding für Film- und Spielproduktionen. Kreative können blitzschnell Ideen skizzieren, ohne sich um die lückenlose physikalische Konsistenz jedes Details sorgen zu müssen.
Die entscheidende Wasserscheide für Weltmodelle bleibt die Beherrschung räumlicher Konsistenz. Genie 4 beweist eindrucksvoll, dass Algorithmen reaktive, audiovisuelle Umgebungen in Echtzeit synthetisieren können. Doch solange das Problem des Vergessens außerhalb des Blickfelds ungelöst bleibt, bricht diese Welt nach zwei Minuten unweigerlich in sich zusammen. Sie bietet Kreativen einen bemerkenswert flexiblen Skizzenblock – für kompromisslose physikalische Simulationen taugt sie vorerst nicht.
Weiterführende Links:
- Offizielle Forschungsankündigung von Google DeepMind
- Ausführlicher Vor-Ort-Bericht von TechCrunch
- Technische Diskussion in der Entwickler-Community auf Hacker News