„Wer ein Lehrbuch von einer Piratenseite kopiert, hat in genau diesem Moment das Urheberrecht verletzt, Punkt.“ (The person who copies the textbook from a pirate site has infringed already, full stop.) Mit diesen unmissverständlichen Worten zog der erfahrene US-Bundesrichter William Alsup am Bezirksgericht für den nördlichen Distrikt von Kalifornien eine scharfe Grenzlinie für die KI-Industrie. Das Lesen und Lernen durch Modelle gilt als rechtmäßige faire Nutzung (Fair Use); das massenhafte Herunterladen aus Piratenseiten zum Aufbau interner Trainingsdatenbanken stellt hingegen eine eindeutige Urheberrechtsverletzung dar.
Die Sammelklage gegen Anthropic endete mit einem Vergleich über 1,5 Milliarden US-Dollar. Dies markiert die höchste jemals in der US-Rechtsgeschichte erzielte Entschädigungssumme im Urheberrecht. Die Vereinbarung erstreckt sich auf knapp 500.000 registrierte Werke, was rechnerisch rund 2.932 Dollar pro Buchtitel entspricht. Doch selbst dieser astronomische Betrag konnte die Empörung vieler Kreativer nicht besänftigen: Prominente Autoren traten aus dem Sammelvergleich aus, um eigene Geschworenenprozesse anzustrengen.
Dieses Grundsatzurteil trennt das Lernen von Modellen erstmals strikt von der illegalen Beschaffung digitaler Bestände. Ersteres wird durch die Doktrin des Fair Use geschützt, letzteres überschreitet die rote Linie unrechtmäßiger Vervielfältigung. Zwar ist die juristische Trennlinie nun gezogen, doch die Preissetzungsmacht über menschliche Werke verbleibt weiterhin fest in den Händen der Tech-Konzerne.
Eine richterliche Wasserscheide: KI darf lesen, aber nicht stehlen
Im August 2024 reichten drei namhafte Schriftsteller Klage gegen Anthropic vor dem Bundesgericht in Nordkalifornien ein. Sie warfen dem KI-Unternehmen vor, ihre Bücher ohne Genehmigung oder Vergütung abgegriffen zu haben, um die Flaggschiff-Modelle der Claude-Reihe zu trainieren. Die Kläger forderten gerichtliche Verfügungen sowie Schadensersatz bis zur gesetzlichen Höchstgrenze.
Im Juni 2025 fällte der zuständige Richter William Alsup ein wegweisendes Teilurteil (Summary Judgment). Alsup genießt im Silicon Valley hohes Ansehen; er hatte einst eigenständig Programmieren gelernt, um komplexe Software-Urheberrechtsstreitigkeiten technisch präzise beurteilen zu können. Der technikaffine Richter verfiel nicht in pauschale Schwarz-Weiß-Muster, sondern teilte den Sachverhalt in zwei grundlegend unterschiedliche Vorgänge.
Der Richter stellte fest, dass die Verwendung urheberrechtlich geschützter Bücher zum Training von KI-Modellen grundsätzlich unter Fair Use fällt. Der Grad der transformativen Nutzung sei bemerkenswert: Claude reproduziere in seinen Ausgaben keine Originaltexte aus den eingelesenen Büchern. Stattdessen lerne das System iterative statistische Zusammenhänge zwischen Wörtern – vergleichbar mit einem Menschen, der unzählige Werke studiert, um sich Wissen anzueignen und anschließend eigenständige neue Texte zu verfassen.
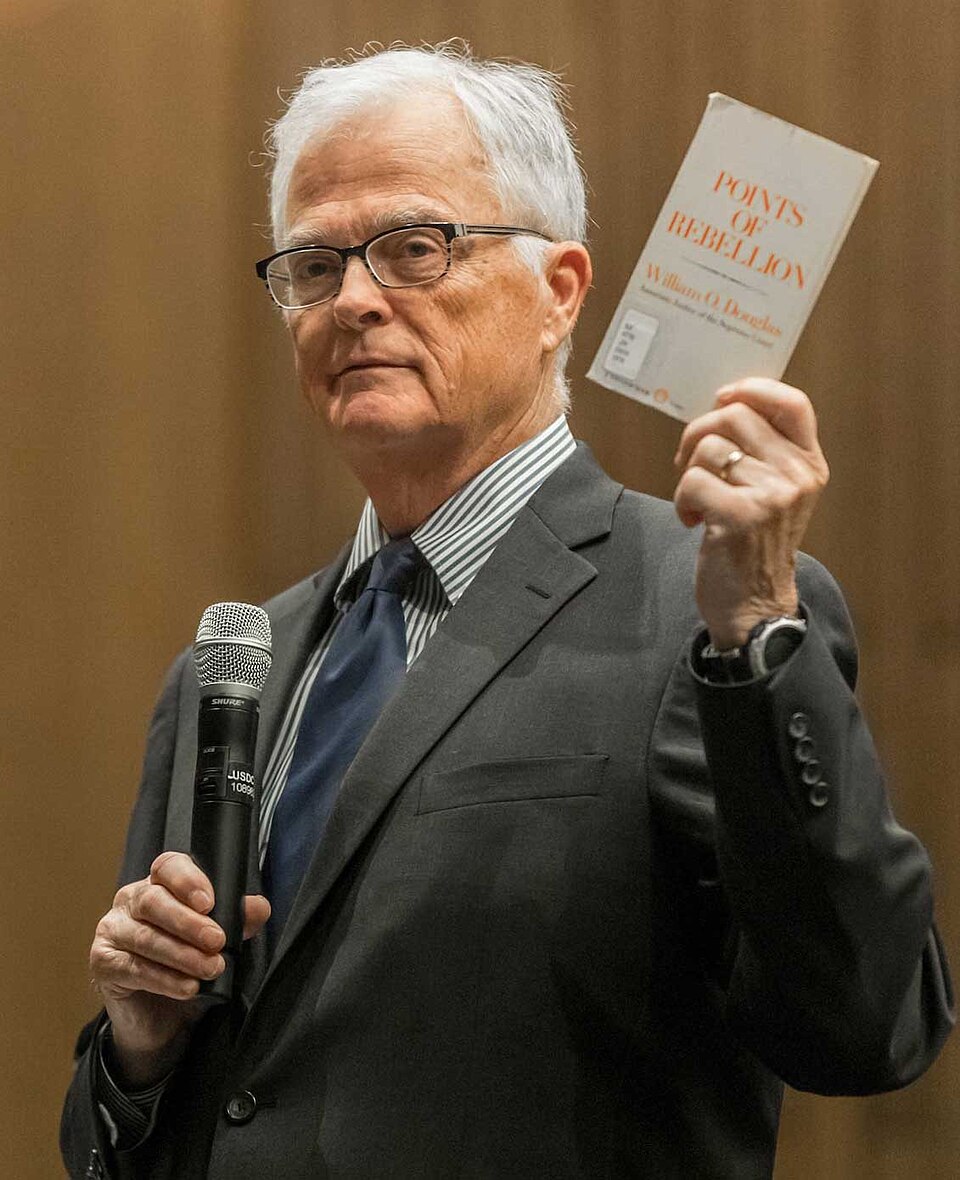 Foto: Der zuständige US-Bundesrichter William Alsup. Quelle: Wikimedia Commons (Foto: Jason Doiy Photography)
Der Schutzschirm des Fair Use rechtfertigt jedoch keine illegalen Beschaffungsmethoden. Richter Alsup wies das Argument entschieden zurück, Forschungszwecke böten einen Freibrief für die Nutzung von Raubkopien. Keine Institution könne sich auf wissenschaftliche Forschung berufen, um ungestraft Bücher aus Ladenregalen mitzunehmen. In dem Moment, in dem digitale Kopien von illegalen Schattenbibliotheken heruntergeladen wurden, war der Tatbestand der rechtswidrigen Vervielfältigung vollendet.
Schattenbibliotheken leergeräumt: Millionen Raubkopien auf den Servern
Gerichtsakten legten die tatsächliche Datenpipeline von Anthropic schonungslos offen. Getrieben vom Druck, foundation models in Rekordzeit zu skalieren, umging das Entwicklerteam langwierige Lizenzverhandlungen und griff direkt auf die Schattenseiten des Internets zu.
Die Gerichtsunterlagen dokumentieren detailliert drei zentrale Piraterie-Quellen, die Anthropic anzapfte. Die erste war der Datensatz „Books3“, der rund 183.000 aus Piratenportalen geschabte Bücher umfasst. Die zweite war die bekannte Schattenbibliothek LibGen, aus der Anthropic mindestens 5 Millionen Bände herunterlud. Die dritte Quelle war der PiLiMi-Spiegelserver, von dem weitere rund 2 Millionen Bücher massenhaft kopiert wurden.
 Foto: Bücherregale an einer Universität in Kalifornien. Quelle: The Stanford Daily (Foto: Jack Bernardo)
Dieser massenhafte Download geschah keineswegs versehentlich. In der Dokumentation zu Books3 wurde ausdrücklich festgehalten, dass der Datensatz fast ausschließlich aus urheberrechtlich geschützten Werken besteht. Auch intern hatten Anthropic-Mitarbeiter rechtliche Bedenken hinsichtlich der Nutzung illegaler Schattenbibliotheken geäußert. Doch im Wettlauf um Marktanteile wurden interne Compliance-Warnungen stillschweigend beiseitegeschoben.
Der Trainingsprozess moderner Sprachmodelle verlangt die Zerlegung und Vorverarbeitung kompletter Buchbestände. Zwar liefert das fertige Modell am Ende nur statistische Wahrscheinlichkeitsgewichte, doch vor Beginn des Trainings mussten vollständige digitale Kopien auf den Unternehmensservern gespeichert werden. Genau dieser lokale Vervielfältigungs- und Konvertierungsschritt begründete die unanfechtbare Urheberrechtsverletzung.
Rekordvergleich über 1,5 Milliarden Dollar: 2.932 Dollar pro Buch
Angesichts der erdrückenden Serverprotokolle zog es Anthropic vor, sich vor dem Hauptverfahren außergerichtlich zu einigen. Im August 2025 verständigten sich beide Parteien auf einen Vergleich über 1,5 Milliarden Dollar, der am 20. Juli 2026 gerichtlich bestätigt wurde. Dies ist die höchste Urheberrechtsentschädigung in der US-Justizgeschichte.
Die Zulassung der Sammelklage war an strenge Auflagen gebunden und umfasste insgesamt 482.460 Werke. Teilnahmeberechtigt waren ausschließlich Titel, die über eine offizielle ISBN verfügten und innerhalb von fünf Jahren nach Veröffentlichung beim US Copyright Office registriert worden waren. Diese Hürde schloss unzählige unabhängige Autoren und internationale Urheber ohne US-Registrierung aus.
Nach US-Recht liegt der gesetzliche Schadensersatz zwischen 750 und 30.000 Dollar pro Werk, bei vorsätzlicher Verletzung sogar bei bis zu 150.000 Dollar. Bei fast 500.000 Werken hätte sich das theoretische Haftungsrisiko auf über 72 Milliarden Dollar belaufen können. Aus Sicht von Anthropic stellt der 1,5-Milliarden-Vergleich daher eine wirksame Begrenzung eines existenziellen Prozessrisikos dar.
Umgerechnet auf die teilnahmeberechtigten Werke entspricht die Gesamtsumme durchschnittlich 2.932 Dollar pro Buch. Nach Abzug von rund 25 Prozent Anwaltshonoraren – etwa 375 Millionen Dollar – verbleiben den Autoren tatsächlich nur rund 2.200 Dollar pro Titel. Für den Tech-Konzern erwies sich der verspätete Scheck als lukrativer Deal, um einen gigantischen Datenbestand nachträglich zu legalisieren.
Ausstieg aus dem Vergleich: Stanford-Professoren kritisieren „Sklavenarbeit“
Längst nicht alle Urheber waren bereit, sich mit diesem pauschalen Abfindungsbetrag abzufinden. An der Stanford University stellten mehr als zehn Professoren fest, dass ihre Fachmonografien ohne jede Erlaubnis in den Claude-Trainingsdaten gelandet waren. Die Wissenschaftler sahen ihr Lebenswerk zum kostenlosen Treibstoff für kommerzielle Algorithmen degradiert.
Der renommierte Schriftsteller und emeritierte Stanford-Professor Tobias Wolff fand zehn seiner Werke im Trainingskorpus wieder. Er kritisierte die unentgeltliche Nutzung öffentlich als „Sklavenarbeit“ und betonte, der Vergleich verschaffe Tech-Giganten ein ungerechtfertigtes Privileg: Konzerne dürften sich nach Belieben am literarischen Erbe der Menschheit bedienen und daraus Profit schlagen.
Wolff und sein Fakultätskollege Chang-rae Lee verweigerten die Annahme der Vergleichssumme. Im Mai 2026 reichten sie eine separate Klage ein und forderten einen Prozess vor einer Geschworenenjury. Beide Autoren verlangen den gesetzlichen Höchstsatz von 150.000 Dollar pro Werk sowie eine dauerhafte gerichtliche Verfügung, die Anthropic die Nutzung ihrer Bücher für das Modelltraining strikt untersagt.
In der Tech-Community rief der Fall Erinnerungen an Aaron Swartz wach. Der Programmierer und Aktivist war einst wegen des massenhaften Downloads akademischer Artikel von JSTOR mit 13 Bundesstraftaten angeklagt worden. Ein kommerzieller Großkonzern hingegen, der Millionen Raubkopien abgegriffen hat, konnte sich durch einen zivilrechtlichen Vergleich schadlos halten. Diese Ungleichbehandlung von Individuen und Großkapital fachte die öffentliche Debatte weiter an.
Die Hürde der Transaktionskosten: Preissetzungsmacht bleibt bei Plattformen
Warum gehen Technologiekonzerne überhaupt das Risiko massiver Rechtsbrüche ein, anstatt Bücher regulär zu lizenzieren? Paul Goldstein, Urheberrechtsexperte an der Stanford Law School, nennt den entscheidenden Grund: Transaktionskosten. Spitzenmodelle benötigen Millionen von Büchern; mit jedem einzelnen Autor bilaterale Verträge auszuhandeln, ist in der Praxis schlicht unmöglich.
Gleichzeitig befinden sich Autoren im bestehenden Rechtssystem in einer schwachen Position. Während viele Rechtsordnungen weltweit das Urheberpersönlichkeitsrecht (wie das Recht auf Namensnennung) schützen, kennt das US-Urheberrecht bei Textwerken kein durchsetzbares Recht auf Urheberschaftsnennung. Autoren können weder angemessene Tantiemen fordern noch durchsetzen, dass Modelle ihre Werke als Quellen ausweisen.
In den USA sind derzeit mehr als 70 Urheberrechtsklagen gegen KI-Entwickler anhängig, eingereicht von The New York Times, Getty Images und Hunderten von Kreativen. Die US Authors Guild setzt sich beim Kongress für eine gesetzliche Lizenzierungspflicht ein, ähnlich den Verwertungsgesellschaften in der Musikindustrie, um standardisierte Vergütungen gesetzlich festzuschreiben.
Das Urteil von Richter Alsup hat Klarheit geschaffen: Modelle dürfen Inhalte analysieren und transformativ lernen, doch Unternehmen dürfen sich Trainingsdaten nicht über Schattenmärkte beschaffen. Auch wenn 1,5 Milliarden Dollar nach einer Rekordsumme klingen, zementiert der Vergleich letztlich einen Großhandelspreis von gut 2.000 Dollar pro Werk. Die Plattformen haben sich von ihrem Haftungsrisiko freigekauft – während die eigentlichen Schöpfer von der Preissetzungsmacht weiterhin ausgeschlossen bleiben.
Referenzen:
- US-Bundesbezirksgericht Nordkalifornien, Urteil Bartz v. Anthropic
- The Stanford Daily, Hintergrundbericht
- US-Bundesbezirksgericht Nordkalifornien, Klageschrift Cruz v. Anthropic
- Stellungnahmen der Authors Guild bei den Urheberrechts-Anhörungen des US-Kongresses