「海賊版サイトから教科書を複製した者は、まさにその瞬間に権利を侵害している。議論の余地はない」(The person who copies the textbook from a pirate site has infringed already, full stop.)カリフォルニア州北部地区連邦地方裁判所のウィリアム・アルサップ(William Alsup)判事は、判決文にそう記した。このベテラン判事は、急拡大するAI業界に向けて明確な一線を引いた。モデルが本を読んで学習する行為自体は「フェアユース(公正利用)」であるが、海賊版サイトからデータを複製して内部ライブラリを構築することは明白な権利侵害である、と。
AIスタートアップのAnthropicに対する集団訴訟は、15億ドル(約2300億円)の和解金支払いによって決着した。この金額は、米国の著作権侵害訴訟における回収額として過去最高を記録した。和解は米著作権局に登録された約50万作品を対象としており、1作品あたり平均で約2932ドルが支払われる計算となる。しかし、この巨額の和解金も作家たちの怒りを鎮めるには至らず、著名な作家らが集団和解から離脱し、個別訴訟に踏み切る事態となっている。
本判決は、「読書による学習」と「不正複製によるデータ蓄積」を明確に分離した。前者はフェアユースの法理によって保護されるが、後者は違法複製のレッドラインを踏み越えた。著作権侵害の法的境界線が定まる一方で、作品の対価決定権は依然として巨大テック企業の掌中に残されている。
判事が引いた分水嶺:AIは読書してよいが、盗みは許されない
2024年8月、3名の著名作家がAnthropicを相手取り、カリフォルニア州北部地区連邦地裁に提訴した。原告側は、同社が許可なく書籍データを収集し、大規模言語モデル「Claude」の訓練に不正利用したと主張。差止命令と法定上限額での損害賠償を求めた。
2025年6月、本件を担当するウィリアム・アルサップ判事は略式判決を下した。アルサップ判事はシリコンバレーで広く知られた名裁判官であり、過去にはソフトウェア著作権訴訟を審理するために自らプログラミング言語を習得した経歴を持つ。テクノロジーに精通した同判事は、白黒を単純化する議論を退け、争点を二つの行為に切り分けた。
判事は、著作権で保護された書籍を用いてモデルを学習させる行為はフェアユースに該当すると判断した。その変容性(トランスフォーマティブ性)は驚くべき水準にあると同判事は指摘した。Claudeは生成テキストにおいて書籍の原文をそのまま出力しているわけではない。単語間の統計的な関連性を反復的にマッピングしており、この仕組みは、人間が数多くの本を読み込んで知識を蓄え、自らの言葉で新たな文章を生み出すプロセスに極めて近い。
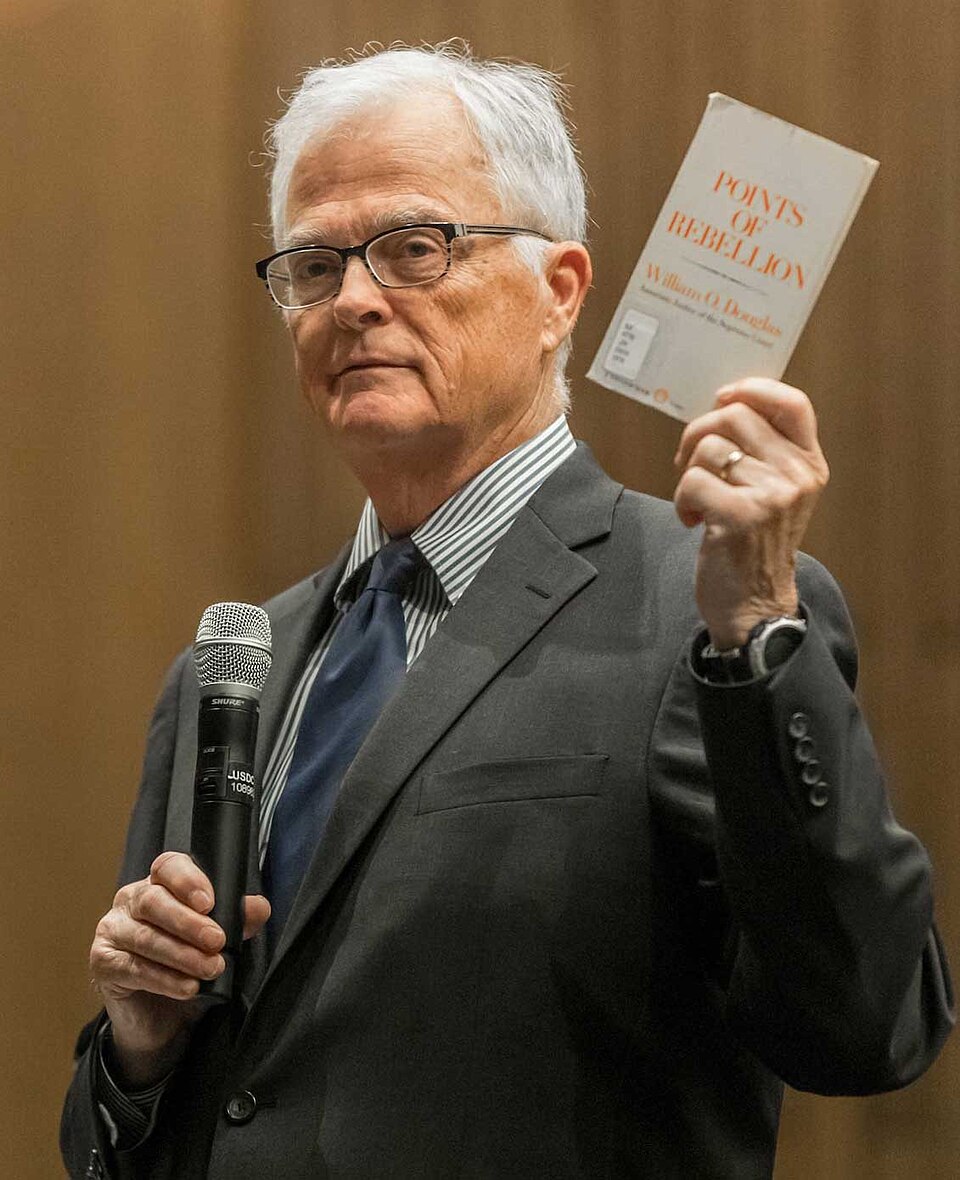 図:本件を担当したウィリアム・アルサップ(William Alsup)判事。出典:Wikimedia Commons(撮影:Jason Doiy Photography)
しかし、フェアユースの盾は、違法な取得手段まで免責するものではない。判事は、研究目的であることを理由に海賊版サイトの利用を正当化するAnthropicの主張を退けた。いかなる機関であれ、学術研究を名目に書店の棚から本を無断で持ち出すことは許されない。海賊版サイトからデジタルコピーをダウンロードした瞬間、違法複製の事実はすでに成立しているのである。
海賊版3大拠点を総ざらい:500万冊超が学習サーバーへ
裁判資料は、Anthropicが訓練データを収集した生々しいプロセスを白日の下に晒した。モデル開発を急速に進めるプレッシャーの下、同社の開発チームは正規の調達手続きを避け、インターネットのアンダーグラウンドに存在する海賊版データベースへと手を伸ばした。
裁判資料には、Anthropicが利用した3大ダウンロード元が詳細に記録されている。1つ目は海賊版サイトから収集された約18万3000冊を含むデータセット「Books3」。2つ目は著名なシャドウライブラリ「LibGen」で、ここから少なくとも500万冊以上がダウンロードされた。3つ目は「PiLiMi」のミラーサイトで、約200万冊に及ぶ書籍が一括ダウンロードされていた。
 図:米カリフォルニア州の大学図書館の書棚。出典:The Stanford Daily(撮影:Jack Bernardo)
この大規模なダウンロードは偶発的なミスではない。「Books3」のドキュメントには、収録書籍のほぼすべてが著作権保護下にある作品であることが明記されていた。さらにAnthropicの内部社員からも、海賊版サイトの利用に伴う法的リスクについて懸念の声が上がっていた。しかし、競合モデルに追いつくための開発スピードが優先され、社内のコンプライアンス警告は顧みられることなく棚上げされた。
大規模言語モデルの学習プロセスでは、書籍全体を分解・前処理する必要がある。最終的にモデルとして出力されるのは確率分布の重み付けに過ぎないが、学習を開始する前に、サーバー上にはデジタル完全複製が保存されていなければならない。このローカルにおける複製と前処理の工程こそが、言い逃れのできない侵害事実を構成した。
15億ドルの記録的和解:1冊あたり2932ドルの換算
動かぬダウンロードログを前に、Anthropicは公判を避けて和解を選択した。2025年8月に両者は15億ドルの和解条件に合意し、2026年7月20日に連邦地裁がこれを正式に承認した。この巨額の支払いは、米国の司法史上、著作権回収における最高記録を塗り替えた。
集団訴訟の対象となった作品数は合計48万2460件に上る。ただし、対象となるにはISBN(国際標準図書番号)を持ち、出版から5年以内に米著作権局に登録されているという厳しい要件が課された。この厳格な手続きにより、連邦登録を行っていなかった多数のインディペンデント作家や海外著作者は救済から除外された。
米国著作権法において、作品1件あたりの法定損害賠償額は750ドルから3万ドルの範囲と定められており、故意の侵害と認定された場合は最大15万ドルまで跳ね上がる。約50万作品で試算すると、潜在的な損害賠償額は720億ドルを超える規模に達する可能性があった。15億ドルという金額は天文学的に見えるが、Anthropicにとっては破滅的な法的リスクを管理可能な範囲に抑え込んだ結果と言える。
15億ドルを対象作品数で均等に割ると、1冊あたり約2932ドルとなる。ここから原告側代理人弁護士の報酬として約25%(約3億7500万ドル)が差し引かれるため、著作者が実際に受け取る金額は1作品あたり2200ドル程度にとどまる。後払いの小切手を切ることで数千万件規模のデータ資産を実質的に合法化した格好であり、プラットフォームにとっては極めて採算の合う取引となった。
集団和解からの離脱:スタンフォード大の重鎮教授が「奴隷労働」と批判
すべての著作者が、この買い叩かれた条件を甘受したわけではない。スタンフォード大学では、10名以上の教員の専門書がモデルの学習データに無断で組み込まれていたことが判明した。学者たちは自らの研究成果が、商業企業のアルゴリズムの礎として勝手に利用されていた現実に直面した。
著名作家でありスタンフォード大学英語学部名誉教授のトビアス・ウルフ(Tobias Wolff)氏は、自らの著書10作品が無断利用された。同氏は、正当な報酬のない著作物利用は「奴隷労働」に等しいと公に非難した。そして今回の和解案は巨大テック企業に特権を与え、人類の文学的遺産を恣意的に拾い上げてマネタイズすることを追認したに過ぎないと痛烈に批判した。
ウルフ名誉教授と同僚の李昌来(チャンレ・リー)教授は、和解金の受け取りを拒否。2026年5月に別途単独訴訟を提起し、陪審員裁判を要求した。両作家は、1作品あたり法定上限である15万ドルの賠償を求めるとともに、自らの作品をモデルの学習に二度と使用させない永久差止命令を裁判所に求めている。
テックコミュニティでは、本件を巡りプログラマーの故アーロン・スワーツ(Aaron Swartz)氏の事件が再び引き合いに出された。かつてスワーツ氏は学術論文を大量ダウンロードしたことで、米連邦検察から13件の重罪で起訴された。一方で、数百万冊の海賊版書籍を組織的に取得した巨大ハイテク企業は、民事和解によって刑事責任を問われることなく事業を継続している。個人と巨大資本に対するこの司法のダブルスタンダードは、世論の大きな議論を呼んでいる。
残された価格決定権:取引コストに阻まれるライセンス契約
個別訴訟の枠組みを超えて、なぜテック大手は法的リスクを冒してまで正規ライセンスの締結を避けたのか。スタンフォード・ロースクールのポール・ゴールドスタイン教授は、その核心的な要因として「取引コスト」を指摘する。フロンティアモデルの構築には数百万冊のテキストが必要であり、無数の著作者と個別に対面して利用許諾を結ぶことは現実的に不可能だからである。
現行の法制度において、著作者は構造的に不利な立場に置かれている。欧州など世界の多くの国が著作者の人格権(氏名表示権)を保障しているのに対し、米国の著作権法は文学作品について広範な氏名表示権を認めていない。作家たちは適正な対価を得られないばかりか、AIモデルに対して出典の明示を求める権利すら持たない。
全米では現在、ニューヨーク・タイムズ紙やゲッティイメージズ、そして数百名のクリエイターによる70件以上の著作権訴訟が進行中である。全米作家協会(The Authors Guild)は、音楽業界のような集中管理機構をモデルとし、法律によって統一料率を定めて使用料を徴収する「法定ライセンス制度」の創設を求めて米連邦議会へのロビー活動を展開している。
今回の判決は一つの明確な基準を示した。モデルがテキストを精読して学習することは認められるが、企業が地下マーケットを通じてデータを盗み出すことは許されない。15億ドルの和解は巨額に見えるが、実質的には1冊あたり約2000ドル強という「まとめ買いの卸値」を一方的に固定したに過ぎない。プラットフォームが巨額資金で法的責任を買い取った一方で、創作の現場に立つ作家たちは依然として価格決定の蚊帳の外に置かれている。
参考リンク:
- 米カリフォルニア州北部地区連邦地裁 Bartz v. Anthropic 判決文
- スタンフォード大学学生新聞『The Stanford Daily』調査報道
- 米カリフォルニア州北部地区連邦地裁 Cruz v. Anthropic 訴状
- 全米作家協会 米連邦議会著作権公聴会提出文書