「从盗版网站复制教材的人,已经在那一刻侵权了,句号。」(The person who copies the textbook from a pirate site has infringed already, full stop.)加利福尼亚北区联邦地区法院法官威廉·阿尔苏普(William Alsup)写下了这句定论。这位资深法官给 AI 产业划出了红线。模型读书学习属于合理使用,从盗版网站搬书建库则构成侵权。
这场针对 Anthropic 的集体诉讼以 15 亿美元和解。这个数字创下了美国版权追偿的历史纪录。和解协议覆盖近 50 万部登记作品,每部平均折算约 2932 美元。巨额和解金没能平息怒火,多位著名作家选择退群另告。
这份判决第一次把「读书学习」与「搬书建库」切成了两件事。前者受合理使用原则保护,后者踩中了非法复制的红线。版权侵权有了明确边界,但作品的定价权依然握在科技巨头手里。
法官劈出分水岭:AI能读书,但不能偷书
2024 年 8 月,三位知名作家在加州北区联邦法院起诉 Anthropic。原告指控这家科技公司未经许可抓取图书,训练旗下 Claude 大模型。作家们要求法院下达禁令,并按照法定上限追索巨额赔偿。
2025 年 6 月,主审法官威廉·阿尔苏普作出了简易判决。阿尔苏普在硅谷声名显赫,曾亲自学习编写代码审理软件版权案。这位懂技术的法官没有落入非黑即白的争吵,而是将案件一分为二。
法官认定,使用受版权保护的图书训练模型属于合理使用。他形容这种转换在程度上堪称惊人。模型在生成文本时并没有直接复制书里的句子。它做的是迭代映射词语之间的统计关联。这个机制类似于人类博览群书,随后运用学到的知识创作新文章。
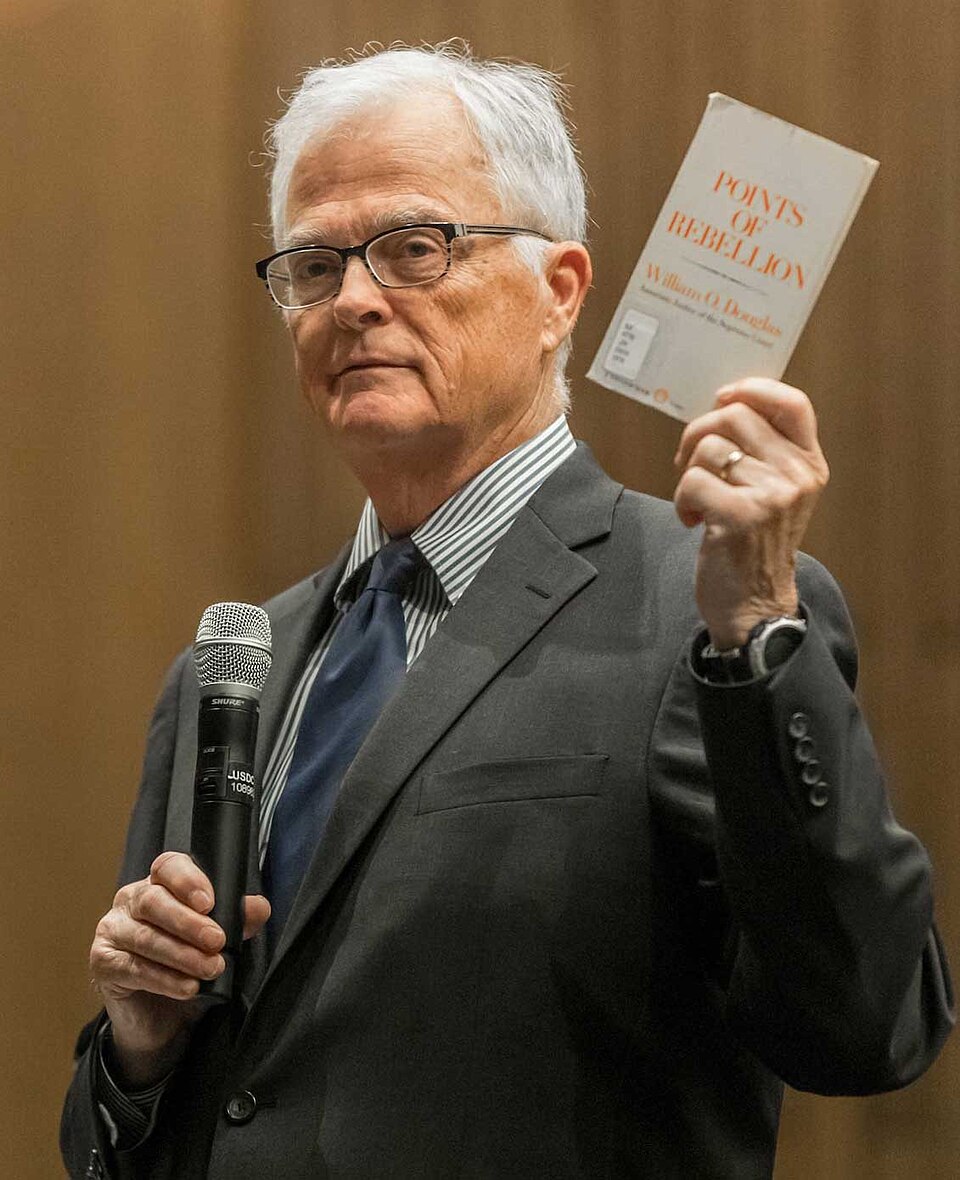 图:本案主审法官威廉·阿尔苏普(William Alsup)。来源:Wikimedia Commons(摄影 Jason Doiy Photography)
但是,合理使用的保护伞不能覆盖非法获取手段。法官明确否决了研究目的可以豁免盗版来源的辩解。任何机构都不能宣称为了科研,就合法拿走货架上的图书。从盗版网站下载数字副本的那一刻,非法复制的事实就已经坐实。
搬空三大盗版网站:500万本电子书塞进数据库
法庭文件公开了 Anthropic 获取训练语料的真实路径。为了快速喂饱庞大的模型,这家公司避开了繁琐的正规采购。工程团队直接把目光投向了互联网阴影处的盗版图书库。
法院文件详细列出了 Anthropic 调用的三大盗版源头。第一处是 Books3 数据集,包含扒自盗版站点的约 18.3 万本书。第二处是知名的影子图书馆 LibGen,下载总量至少达 500 万本。第三处是 PiLiMi 镜像站,被批量下载的书籍也多达 200 万本。
 图:加州高校图书馆书架上的成排图书。来源:The Stanford Daily(摄影 Jack Bernardo)
这种海量下载行为并非无心之失。Books3 的说明文档早就写明,该数据集几乎全是受版权保护的作品。Anthropic 内部员工也曾对使用盗版网站提出过法律风险。在追赶模型研发进度的压力下,内部的合规警告被悄悄搁置。
大模型的训练流程需要将整本图书拆解转化。模型最终交付的是概率分布。但在训练启动前,服务器必须完整存储数字拷贝。正是这道本地复制与转码的工序,构成了无可辩驳的侵权事实。
15亿美元创下赔偿纪录:每本书折价2932美元
面对确凿的下载记录,Anthropic 选择在庭审前达成和解。2025 年 8 月,双方敲定了 15 亿美元的和解金额。2026 年 7 月 20 日,法院正式批准并签署了判决。这笔巨款刷新了美国司法史上版权追偿的最高纪录。
集体诉讼的认证范围设立了严格门槛,总计覆盖 482,460 部作品。入围作品必须拥有标准书号,并在出版五年内向美国版权局登记。这道严苛程序将大量没有官方登记的独立作者挡在大门之外。
按照美国法律,单件作品侵权的法定赔偿在 750 至 30,000 美元之间。如果被法庭认定为恶意侵权,单件赔偿上限高达 150,000 美元。按近 50 万部作品推算,潜在赔偿总额足以突破 720 亿美元。15 亿美元看似天文数字,实际上将公司的毁灭性风险压缩到了可控范围。
将 15 亿美元分摊到具体作品上,每本书平均折算 2932 美元。约四分之一的和解金将直接流向原告代理律师,扣除约 3.75 亿美元。创作者最终落袋的实际赔偿只有 2200 美元左右。用一张迟到的支票换取数以万计的数据资产,平台做成了一笔合算的买卖。
退出集体和解:斯坦福老教授痛斥奴役劳动
并非所有创作者都愿意接受这种被折价的买卖。在斯坦福大学,有超过 10 位教授的专著被卷入训练库。这些学者发现自己的心血结晶,变成了商业公司的算法基石。
著名作家、斯坦福英语系荣休教授托比亚斯·沃尔夫有 10 部作品被挪用。这位老作家公开发声,指责未经报酬的使用是一种奴役劳动。他批评和解方案给了巨头特权,允许平台在人类文学作品里随意拣选套现。
沃尔夫与同系教授李昌来拒绝领取和解金。他们在 2026 年 5 月另行提起独立诉讼,要求由陪审团进行审判。两位作家主张按每部作品 150,000 美元的法定上限追索赔偿。他们同时寻求法庭下达永久禁令,严禁平台使用其作品训练模型。
技术社区在讨论该案时翻出了程序员阿伦·斯沃茨的历史案件。当年斯沃茨批量下载学术论文,面临着 13 项联邦重罪指控。商业巨头批量搬走数百万本盗版书,却能凭借民事和解全身而退。这种对待个人与资本的双重标准,成为公众争论的焦点。
定价权还在平台手里:版权授权卡在交易成本
从个案走向行业,科技巨头为何宁可冒险侵权也不进行商业采购?斯坦福法学院学者保罗·戈德斯坦点出了关键瓶颈:交易成本。前沿模型需要数百万部作品,平台在现实中无法与每一位作者逐一签约。
作者在现有法律制度下处于被动地位。全球多数国家立法保护作者的署名权,而美国至今没有这项权利。作家拿不到公平的报酬,甚至连要求模型标注来源的权利都被剥夺。
全美目前已有超过 70 起针对 AI 公司的版权诉讼。原告席上坐着纽约时报、盖蒂图片社与数百位创作者。美国作家协会正在游说国会设立强制许可机制。创作者希望复制音乐产业模式,由法律统一定价收取版税。
这份判决划清了界限。模型可以研读文本,但企业不得通过黑市搬运数据。15 亿美元的和解看似天价,实际上单方面锚定了每本书两千多美元的批发价。平台买断了侵权风险。被卷入浪潮的作家们,依然被关在定价权大门之外。
参考链接:
- 加州北区联邦法院 Bartz v. Anthropic 判决书
- 斯坦福日报(The Stanford Daily)深度报道
- 加州北区联邦法院 Cruz v. Anthropic 起诉状
- 美国作家协会国会版权立法听证公开文件