“불법 복제 사이트에서 교재를 내려받아 복제한 자는 바로 그 순간 이미 저작권을 침해한 것입니다. 더 논할 여지가 없습니다.”(The person who copies the textbook from a pirate site has infringed already, full stop.) 캘리포니아 북부 연방지방법원의 윌리엄 앨섭(William Alsup) 판사는 판결문에 이와 같이 명확한 결론을 남겼다. 이 베테랑 판사는 인공지능 산업계를 향해 분명한 한계선을 그었다. 모델이 책을 읽고 학습하는 것은 공정 이용에 해당하지만, 불법 복제 사이트에서 대규모로 책을 긁어모아 내부 데이터베이스를 구축하는 행위는 명백한 권리 침해라는 것이다.
앤트로픽(Anthropic)을 상대로 제기된 집단소송은 15억 달러(한화 약 2조 원) 규모의 합의로 마무리되었다. 이는 미국 저작권 소송 역사상 최대 배상액 기록이다. 이번 합의는 미국 저작권청에 등록된 약 50만 권의 도서를 대상으로 하며, 권당 평균 약 2932달러로 환산된다. 그러나 이 천문학적인 합의금도 작가들의 분노를 가라앉히지는 못했다. 저명한 작가들은 집단 합의를 거부하고 별도의 단독 소송에 나섰다.
이번 판결은 ‘책을 읽고 배우는 행위’와 ‘불법 복제로 저장소를 구축하는 행위’를 법적으로 분리한 첫 사례다. 전자는 공정 이용의 원칙에 따라 보호받지만, 후자는 불법 복제의 금지선을 넘었다. 저작권 침해의 경계는 한층 뚜렷해졌으나, 창작물의 가격 결정권은 여전히 거대 테크 기업의 손에 쥐여 있다.
판사가 그은 분수령: AI는 독서할 수 있지만 훔칠 수는 없다
2024년 8월, 세 명의 유명 작가가 캘리포니아 북부 연방지방법원에 앤트로픽을 제소했다. 원고 측은 앤트로픽이 사전 허가나 보상 없이 저작물을 무단 수집하여 대규모 언어 모델인 클로드(Claude) 학습에 사용했다고 주장했다. 작가들은 법원에 침해 금지 가처분 명령을 내리고 법정 최고 한도에 따른 손해배상을 청구했다.
2025년 6월, 담당 판사인 윌리엄 앨섭은 약식 판결을 내렸다. 실리콘밸리에서 널리 알려진 앨섭 판사는 과거 소프트웨어 저작권 소송을 심리하기 위해 직접 코딩을 배웠을 만큼 기술에 해박하다. 기술적 메커니즘을 꿰뚫어 보는 판사는 흑백 논리에 빠지지 않고 사건의 쟁점을 둘로 나누었다.
판사는 저작권이 있는 도서를 활용해 인공지능 모델을 학습시키는 행위 자체는 공정 이용에 해당한다고 판단했다. 앨섭 판사는 모델이 보여준 변형적 성격이 놀라운 수준이라고 평가했다. 클로드는 생성 과정에서 책 속의 문장을 그대로 복제해 출력하지 않는다. 단어들 사이의 통계적 상관관계를 반복적으로 연결할 뿐이며, 이는 인간이 수많은 양서를 탐독한 뒤 습득한 지식을 바탕으로 새로운 창작물을 집필하는 과정과 유사하다는 논리다.
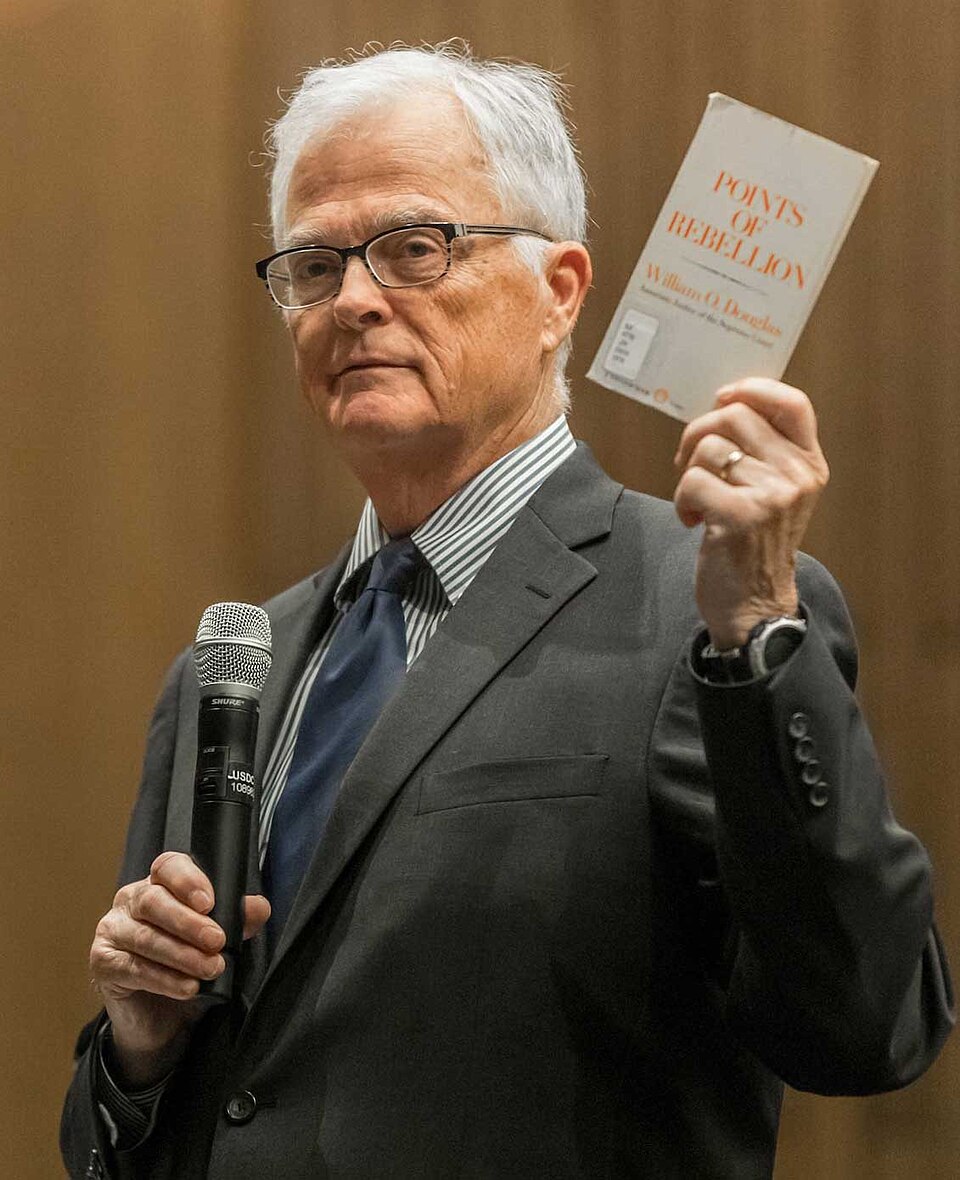 그림: 본 사건을 심리한 윌리엄 앨섭(William Alsup) 연방 판사. 출처: 위키미디어 공용(Jason Doiy Photography 촬영)
그러나 공정 이용의 방패가 불법적인 데이터 획득 수단까지 면책해 주는 것은 아니다. 판사는 연구 목적이라는 이유로 불법 복제 사이트 이용을 정당화하려 한 앤트로픽의 주장을 단호히 기각했다. 어떠한 기관도 학술 연구를 명분으로 서점 매대에 놓인 도서를 무단으로 가져갈 권리는 없다. 불법 복제 사이트에서 디지털 복제본을 내려받는 순간 이미 불법 복제의 위법성은 성립한다는 취지다.
3대 불법 복제 사이트 전수 다운로드: 500만 권이 서버로
법원에 제출된 문서는 앤트로픽이 학습 데이터를 수집한 실제 경로를 적나라하게 드러냈다. 모델 개발 경쟁에서 앞서나가야 한다는 압박 속에서, 엔지니어링 팀은 번거로운 정식 라이선스 계약을 우회하고 인터넷 어둠 속에 자리한 불법 복제 서고로 향했다.
법원 기록에는 앤트로픽이 활용한 3대 불법 복제 출처가 구체적으로 적시되어 있다. 첫 번째는 불법 복제 사이트에서 긁어모은 약 18만 3000권의 도서가 포함된 ‘Books3’ 데이터셋이다. 두 번째는 유명한 그림자 도서관 ‘LibGen’으로, 최소 500만 권 이상을 내려받았다. 세 번째는 ‘PiLiMi’ 미러 사이트로, 약 200만 권에 달하는 도서를 일괄 다운로드했다.
 그림: 미국 캘리포니아 대학 도서관 서가에 정돈된 서적들. 출처: 스탠퍼드 데일리(Jack Bernardo 촬영)
이러한 대규모 다운로드는 단순한 실수가 아니었다. Books3의 설명 문서에는 수록된 데이터의 거의 전량이 저작권 보호 대상이라는 사실이 명시되어 있었다. 앤트로픽 내부 구성원들 사이에서도 불법 복제 사이트 사용에 따른 법적 위험을 경고하는 목소리가 나왔다. 그러나 모델 출시 일정을 맞춰야 한다는 조급함 속에 내부 준법 경고는 조용히 묵살되었다.
대규모 언어 모델의 학습 절차는 도서 전문을 분해하고 전처리하는 과정을 필요로 한다. 모델의 최종 결과물은 확률 분포 가중치에 불과하지만, 학습을 시작하기 전 서버에는 완전한 디지털 복제본이 반드시 저장되어야 한다. 바로 이 로컬 복제와 변환 공정이 반박할 수 없는 저작권 침해 사실을 입증했다.
15억 달러의 사상 최대 합의: 권당 2932달러의 헐값 정산
명백한 다운로드 기록 앞에서 앤트로픽은 정식 재판 대신 합의를 선택했다. 2025년 8월 양측은 15억 달러의 합의금에 도달했고, 2026년 7월 20일 법원이 이를 공식 인가했다. 이 거액의 합의금은 미국 사법 역사상 저작권 침해 배상액 최고치를 경신했다.
집단소송의 인증 범위에는 엄격한 기준이 적용되어 총 48만 2460권의 작품이 포함되었다. 대상에 오르려면 국제표준도서번호(ISBN)를 보유하고 출간 5년 이내에 미국 저작권청에 공식 등록되어 있어야 했다. 이러한 까다로운 조건으로 인해 공식 등록을 마치지 못한 수많은 독립 작가와 해외 저자들은 구제 대상에서 배제되었다.
미국 법률상 저작물 1건당 법정 손해배상금은 750달러에서 3만 달러 사이이며, 법원에서 고의적 침해로 인정될 경우 권당 최대 15만 달러까지 치솟는다. 약 50만 권을 기준으로 산정하면 잠재적 배상 총액은 720억 달러를 넘어설 수 있었다. 15억 달러라는 수치는 겉보기에 천문학적이지만, 앤트로픽 입장에서는 회사의 존폐를 흔들 수 있는 위험을 감당 가능한 수준으로 묶어둔 셈이다.
15억 달러를 실제 도서 수로 나누면 1권당 평균 2932달러가 된다. 원고 측 대리인 변호사 비용으로 약 25퍼센트에 달하는 3억 7500만 달러가 공제되므로, 창작자가 손에 쥐는 실질 보상액은 권당 2200달러 안팎에 불과하다. 뒤늦은 수표 한 장을 건네 수천만 건에 달하는 데이터를 합법화했으니, 플랫폼으로서는 남는 장사를 한 셈이다.
집단 합의 거부: 스탠퍼드 원로 교수가 비판한 ‘노예 노동’
모든 창작자가 이처럼 평가절하된 정산 방식을 수용한 것은 아니다. 스탠퍼드 대학교에서는 10명 이상의 교수진이 집필한 전문 서적이 클로드의 학습 데이터에 포함된 것으로 확인되었다. 학자들은 평생을 바친 연구 결과물이 영리 기업의 알고리즘 밑거름으로 무단 전용된 사실에 경악했다.
저명한 소설가이자 스탠퍼드대 영문학과 명예교수인 토비아스 울프(Tobias Wolff)는 자신의 저작물 10권이 무단 사용되었다. 울프 교수는 아무런 대가 없는 무단 도용은 일종의 “노예 노동”과 다름없다고 공개적으로 비판했다. 그는 이번 합의안이 테크 거인들에게 특권을 부여하여 인류 문학 작품을 마음대로 골라 현금화하도록 면죄부를 주었다고 일갈했다.
울프 교수와 동료 창래 리(Chang-rae Lee) 교수는 합의금 수령을 거부했다. 두 작가는 2026년 5월 독자적인 개별 소송을 제기하고 배심원 재판을 요구했다. 이들은 권당 법정 최고 한도인 15만 달러의 배상을 청구하는 동시에, 향후 모델 학습에 자신의 저작물을 일절 사용하지 못하도록 하는 영구 금지 명령을 법원에 요청했다.
기술 커뮤니티에서는 이 사건을 두고 과거 프로그래머 에런 스워츠(Aaron Swartz)의 비극을 떠올렸다. 과거 스워츠는 학술 논문을 대량 다운로드했다는 이유로 연방 검찰로부터 13건의 중범죄 혐의로 기소되었다. 반면 상업적 거대 기업은 수백만 권의 불법 복제 서적을 긁어모으고도 민사 합의를 통해 아무런 형사 책임 없이 빠져나갔다. 개인과 거대 자본을 대하는 사법 제도의 이중 잣대는 대중의 뜨거운 논쟁거리로 떠올랐다.
가격 결정권은 여전히 플랫폼에: 거래 비용에 갇힌 저작권 계약
개별 사건을 넘어, 왜 테크 대기업들은 법적 위험을 무릅쓰면서까지 정식 저작권 계약을 맺지 않는 것일까. 스탠퍼드 로스쿨의 폴 골드스타인(Paul Goldstein) 교수는 핵심 원인으로 ‘거래 비용’을 꼽았다. 최첨단 모델을 학습시키려면 수백만 권의 도서가 필요한데, 현실적으로 플랫폼이 모든 저자와 일일이 계약을 체결하는 것은 불가능에 가깝다.
현재의 법률 체계 아래서 저자는 구조적으로 불리한 위치에 처해 있다. 세계 여러 국가가 저작자의 인격권(성명표시권)을 법적으로 보호하는 반면, 미국 저작권법은 일반 문학 저작물에 대해 광범위한 성명표시권을 보장하지 않는다. 작가들은 정당한 보상을 받지 못할 뿐만 아니라, 모델에 출처 표시를 요구할 권리조차 누리지 못한다.
현재 미국 전역에서는 뉴욕타임스, 게티이미지, 그리고 수백 명의 창작자가 제기한 70건 이상의 인공지능 저작권 소송이 진행 중이다. 미국작가협회(The Authors Guild)는 음악 산업의 저작권 집중관리 방식을 모티브로 삼아, 법률에 따라 통일된 사용료율을 책정하는 ‘법정 라이선스 제도’ 도입을 위해 의회를 상대로 로비 활동을 펼치고 있다.
이번 판결은 명확한 경계선을 그었다. 모델이 텍스트를 읽고 분석하는 학습은 허용되지만, 암시장을 통해 데이터를 불법 조달하는 행위는 용납되지 않는다. 15억 달러의 합의금은 천문학적으로 보이지만, 실상은 권당 2천 달러 남짓의 도매가격을 일방적으로 고정한 것에 불과하다. 플랫폼이 막대한 자금력으로 법적 책임을 털어내는 동안, 거대한 물결에 휩쓸린 작가들은 여전히 가격 결정의 울타리 밖에 머물러 있다.
참고 자료:
- 캘리포니아 북부 연방지방법원 Bartz v. Anthropic 판결문
- 스탠퍼드 데일리(The Stanford Daily) 심층 보도
- 캘리포니아 북부 연방지방법원 Cruz v. Anthropic 소장
- 미국작가협회 미 의회 저작권 청문회 공개 자료