Staatliche Sicherheitsprüfung vor dem Preiskampf
Am 30. September 2026 stellte Google mit Gemini 4 Argon die nächste Evolutionsstufe seiner Spitzenmodelle vor. Wenn ein Technologiekonzern eine neue Modellgeneration präsentiert, besteht der gewohnte erste Schritt darin, weltweit API-Schlüssel an Entwickler zu verteilen. Doch Googles leitender KI-Architekt Koray Kavukcuoglu kündigte auf der Bühne eine grundlegend andere Priorität an: Das leistungsfähigste Modell wurde zunächst freiwillig in den Vorab-Prüfprozess der US-Regierung übergeben. Auf den Abrechnungen breiter Entwicklerkreise tauchte das Modell nicht auf; die ersten Zugriffsrechte erhielten vertrauenswürdige Cyber-Verteidiger im Rahmen des Fairwind-Programms.
Parallel zu dieser restriktiven Zugangspolitik legte Google eine Preisstruktur vor, die den bisherigen Branchenstandard drastisch unterbietet: Im Einführungszeitraum kostet die Eingabe pro Million Token lediglich 2 US-Dollar, während für die Ausgabe 10 US-Dollar anfallen. Wer das Context-Caching nutzt, erhält weitere 5 Prozent Nachlass. Selbst nach Ablauf der Einführungsphase bleibt das Modell im günstigsten Preissegment aktueller Spitzen-KI verankert. Die durch extrem niedrige Preise versprochene Demokratisierung von Rechenleistung steht in scharfem Kontrast zu den strikten Sicherheitsanforderungen für die Freigabe.
Dass gestaffelte Freigaben und behördliche Sicherheitsprüfungen in einem Atemzug mit Tiefstpreisen genannt werden, ist ein unmissverständliches Signal. Die Bereitstellung von Spitzenmodellen ist kein reines Einzelhandelsgeschäft für Rechenleistung mehr, sondern ein anspruchsvoller Prozess regulatorischer Freigaben. Der schärfste Speer wird zuerst Verteidigern für Belastungstests überlassen, um sicherzustellen, dass bestehende Schutzmechanismen standhalten, bevor eine breite Freigabe für Unternehmen erwogen wird. Der Druck zur schnellen Monetarisierung weicht hier bemerkenswert deutlich den Sicherheitsinteressen.
Maschinen schreiben 800.000 Zeilen Kernel-Code neu
Dass Google das Modell vorrangig Verteidigern anvertraut, liegt vor allem daran, dass bisherige Beschränkungen der Ausgabelänge vollständig aufgehoben wurden. War die Generierung früher durch Speicher- und Rechenkapazitäten meist auf einige zehntausend Token gedeckelt, hebt Gemini 4 Argon das Limit für eine einzelne Generierung auf 1.000.000 Token an. Dabei handelt es sich nicht um ein rein theoretisches Zahlenspiel: Das Modell erhält dadurch den nötigen Spielraum, um über hunderte Seiten hinweg kontinuierlich Text oder Code zu generieren und extrem lange Denk- und Ausführungsschleifen autonom zu durchlaufen.
Um die Belastbarkeit bei solchen Langstreckenaufgaben zu demonstrieren, formierte Google ein spezialisiertes Argon-Agententeam und nutzte eigene Kern-Repositories als Testgelände. Das Team übernahm eine gewaltige Softwaremigration: Gewachsene Codebasen in C und C++ sollten in speichersicheres Rust überführt werden. Bei Bibliotheken wie re2 oder libgav1 mit einigen zehntausend Zeilen konnten menschliche Entwicklerteams den Umbau unter hohem Aufwand noch bewältigen. Doch beim Microkernel von Fuchsia Zircon mit mehr als 800.000 Zeilen Low-Level-Code überstieg eine fehlerkritische Restrukturierung dieser Größenordnung die Belastungsgrenzen menschlicher Teams bei Weitem.
In solchen automatisierten Entwicklungsabläufen verschiebt sich die Rolle der Ingenieure grundlegend. Programmierer tippen Code nicht mehr Zeile für Zeile in die Tastatur, sondern ziehen sich auf Kontrollfunktionen zurück: Sie richten isolierte Testumgebungen ein und überwachen die Ergebnisse automatisierter Sicherheitsaudits. Die Maschine übernimmt die vollständige Generierung und Restrukturierung, während dem Menschen die finale Risikoabnahme obliegt. Wenn das Token-Budget kein technisches Hindernis mehr darstellt, verändern sich die Kostenstrukturen von Systemmodernisierungen radikal. Doch dieselbe Maschine, die unermüdlich 800.000 Zeilen sicheren Code neuschreiben kann, ist technisch gleichermaßen imstande, 800.000 Zeilen bösartige Nutzlast zu erzeugen.
 Abb.: Header-Grafik der offiziellen Google-Ankündigung. Quelle: Google Blog
Drei Jahre Experten-Optimierung in wenigen Minuten eingeholt
Auch auf hardwarenaher Ebene demonstrierte das neue Modell eine beachtliche Systembeherrschung. Am Beispiel des libgav1-Videodecoders übernahm ein Argon-Agent eine von Entwicklern unvollendet hinterlassene Rust-Portierung. Statt rein lexikalische Ersetzungen vorzunehmen, analysierte der Agent reale Ausführungsprofile (profile-guided optimization) und ersetzte in mehreren iterativen Zyklen rund 32.000 Zeilen SIMD-Code präzise. Er verstand nicht nur die Befehlssatzlogik der zugrundeliegenden Hardware, sondern erzeugte zugleich speichersicheren Rust-Code, der sich optimal für moderne Compiler eignet.
Das Ergebnis war beachtlich: Die neue, automatisch vektorisierte Fassung arbeitete um den Faktor 2,7 schneller als die ursprüngliche menschliche Rust-Implementierung, bei absolut identischer Ausgabe. Ähnliche Effizienzgewinne zeigten sich in der Quanteninformatik. Bei Subroutinen, an deren manueller Optimierung Quantenforscher drei Jahre gearbeitet hatten, reduzierte das Modell den Ressourcenverbrauch in Zeit und Raum innerhalb weniger Minuten um 40 Prozent. Damit wurden in Fachpublikationen etablierte Benchmarks auf Anhieb übertroffen; komplexe physikalische Randbedingungen stellten sich für das Modell schlicht als Parameteroptimierung in hochdimensionalen Räumen dar.
Selbst die Telemetriedaten ganzer Rechenzentren wurden zum Einsatzfeld für die KI. Eine Gruppe von Argon-Agenten analysierte kontinuierlich das Betriebsverhalten tausender Server, identifizierte selbstständig Schwachstellen bei der Speicherzuteilung in riesigen Logbeständen und spielte systemweite Optimierungsanweisungen aus. Bislang wurden auf diese Weise mehr als 300 TiB ungenutzter Arbeitsspeicher in Googles Serverflotte freigegeben. Schätzungen des Ingenieurteams zufolge könnten die Einsparungen letztlich zwischen 500 TiB und 1 PiB liegen. Eine derart ununterbrochene Optimierung auf Systemebene übersteigt die Kapazitäten selbst hochspezialisierter Entwicklerteams.
Spitzenwerte im Benchmark treffen auf Entwicklerprotest gegen Zwangskomprimierung
Betrachtet man ausschließlich standardisierte Messwerte, dominiert Argon die gängigen Bestenlisten deutlich. Im DeepSWE v1.1-Benchmark, der die eigenständige Lösung anspruchsvoller Software-Engineering-Aufgaben misst, erreichte das Modell beachtliche 77,9 Prozent. Beim AutomationBench für durchgängige betriebliche Workflows belegte es mit 51,3 Prozent den Spitzenplatz, und im LVBench für das Verstehen langer Videos erzielte es eine Trefferquote von 91,7 Prozent. Selbst im Vals Index, der das wirtschaftliche Potenzial anhand des Beitrags zum US-Bruttoinlandsprodukt gewichtet, setzte sich das Modell an die Spitze.
Die unabhängige Testplattform Artificial Analysis bestätigte diese Leistungswerte durch detaillierte Einstufungs- und Preisvergleichstabellen für die High-Variante. In der Entwicklerpraxis rief die Veröffentlichung dennoch geteilte Reaktionen hervor. In den Diskussionen auf Hacker News traten die Rekordergebnisse schnell in den Hintergrund; stattdessen entbrannte eine Debatte über die Kontrolle auf Systemebene. Hauptkritikpunkt war die automatische Kontextkomprimierung: Während die API ein großzügiges Kontextfenster von 1.000.000 Token bereitstellt, schaltet die Endanwenderschnittstelle bei Eingaben über 250.000 Token ungefragt eine verlustbehaftete Komprimierungslogik ein, ohne dass sich diese Funktion deaktivieren ließe.
Aus Protest gegen diese starren Vorgaben kündigten etliche Entwickler ihre Ultra-Abonnements. Andere wichen auf maßgeschneiderte Umgebungen aus und bauten sich unter NixOS mithilfe von agy und 3.8 Flash eigene Ausführungspipelines, um die volle Kontrolle über den Datenstrom zurückzuerlangen. Dieser Konflikt um Systemsouveränität verdeutlicht ein wiederkehrendes Phänomen: Je leistungsfähiger Basissysteme werden, desto sensibler reagieren Entwickler auf Bevormundung und den Verlust deterministischer Kontrolle.
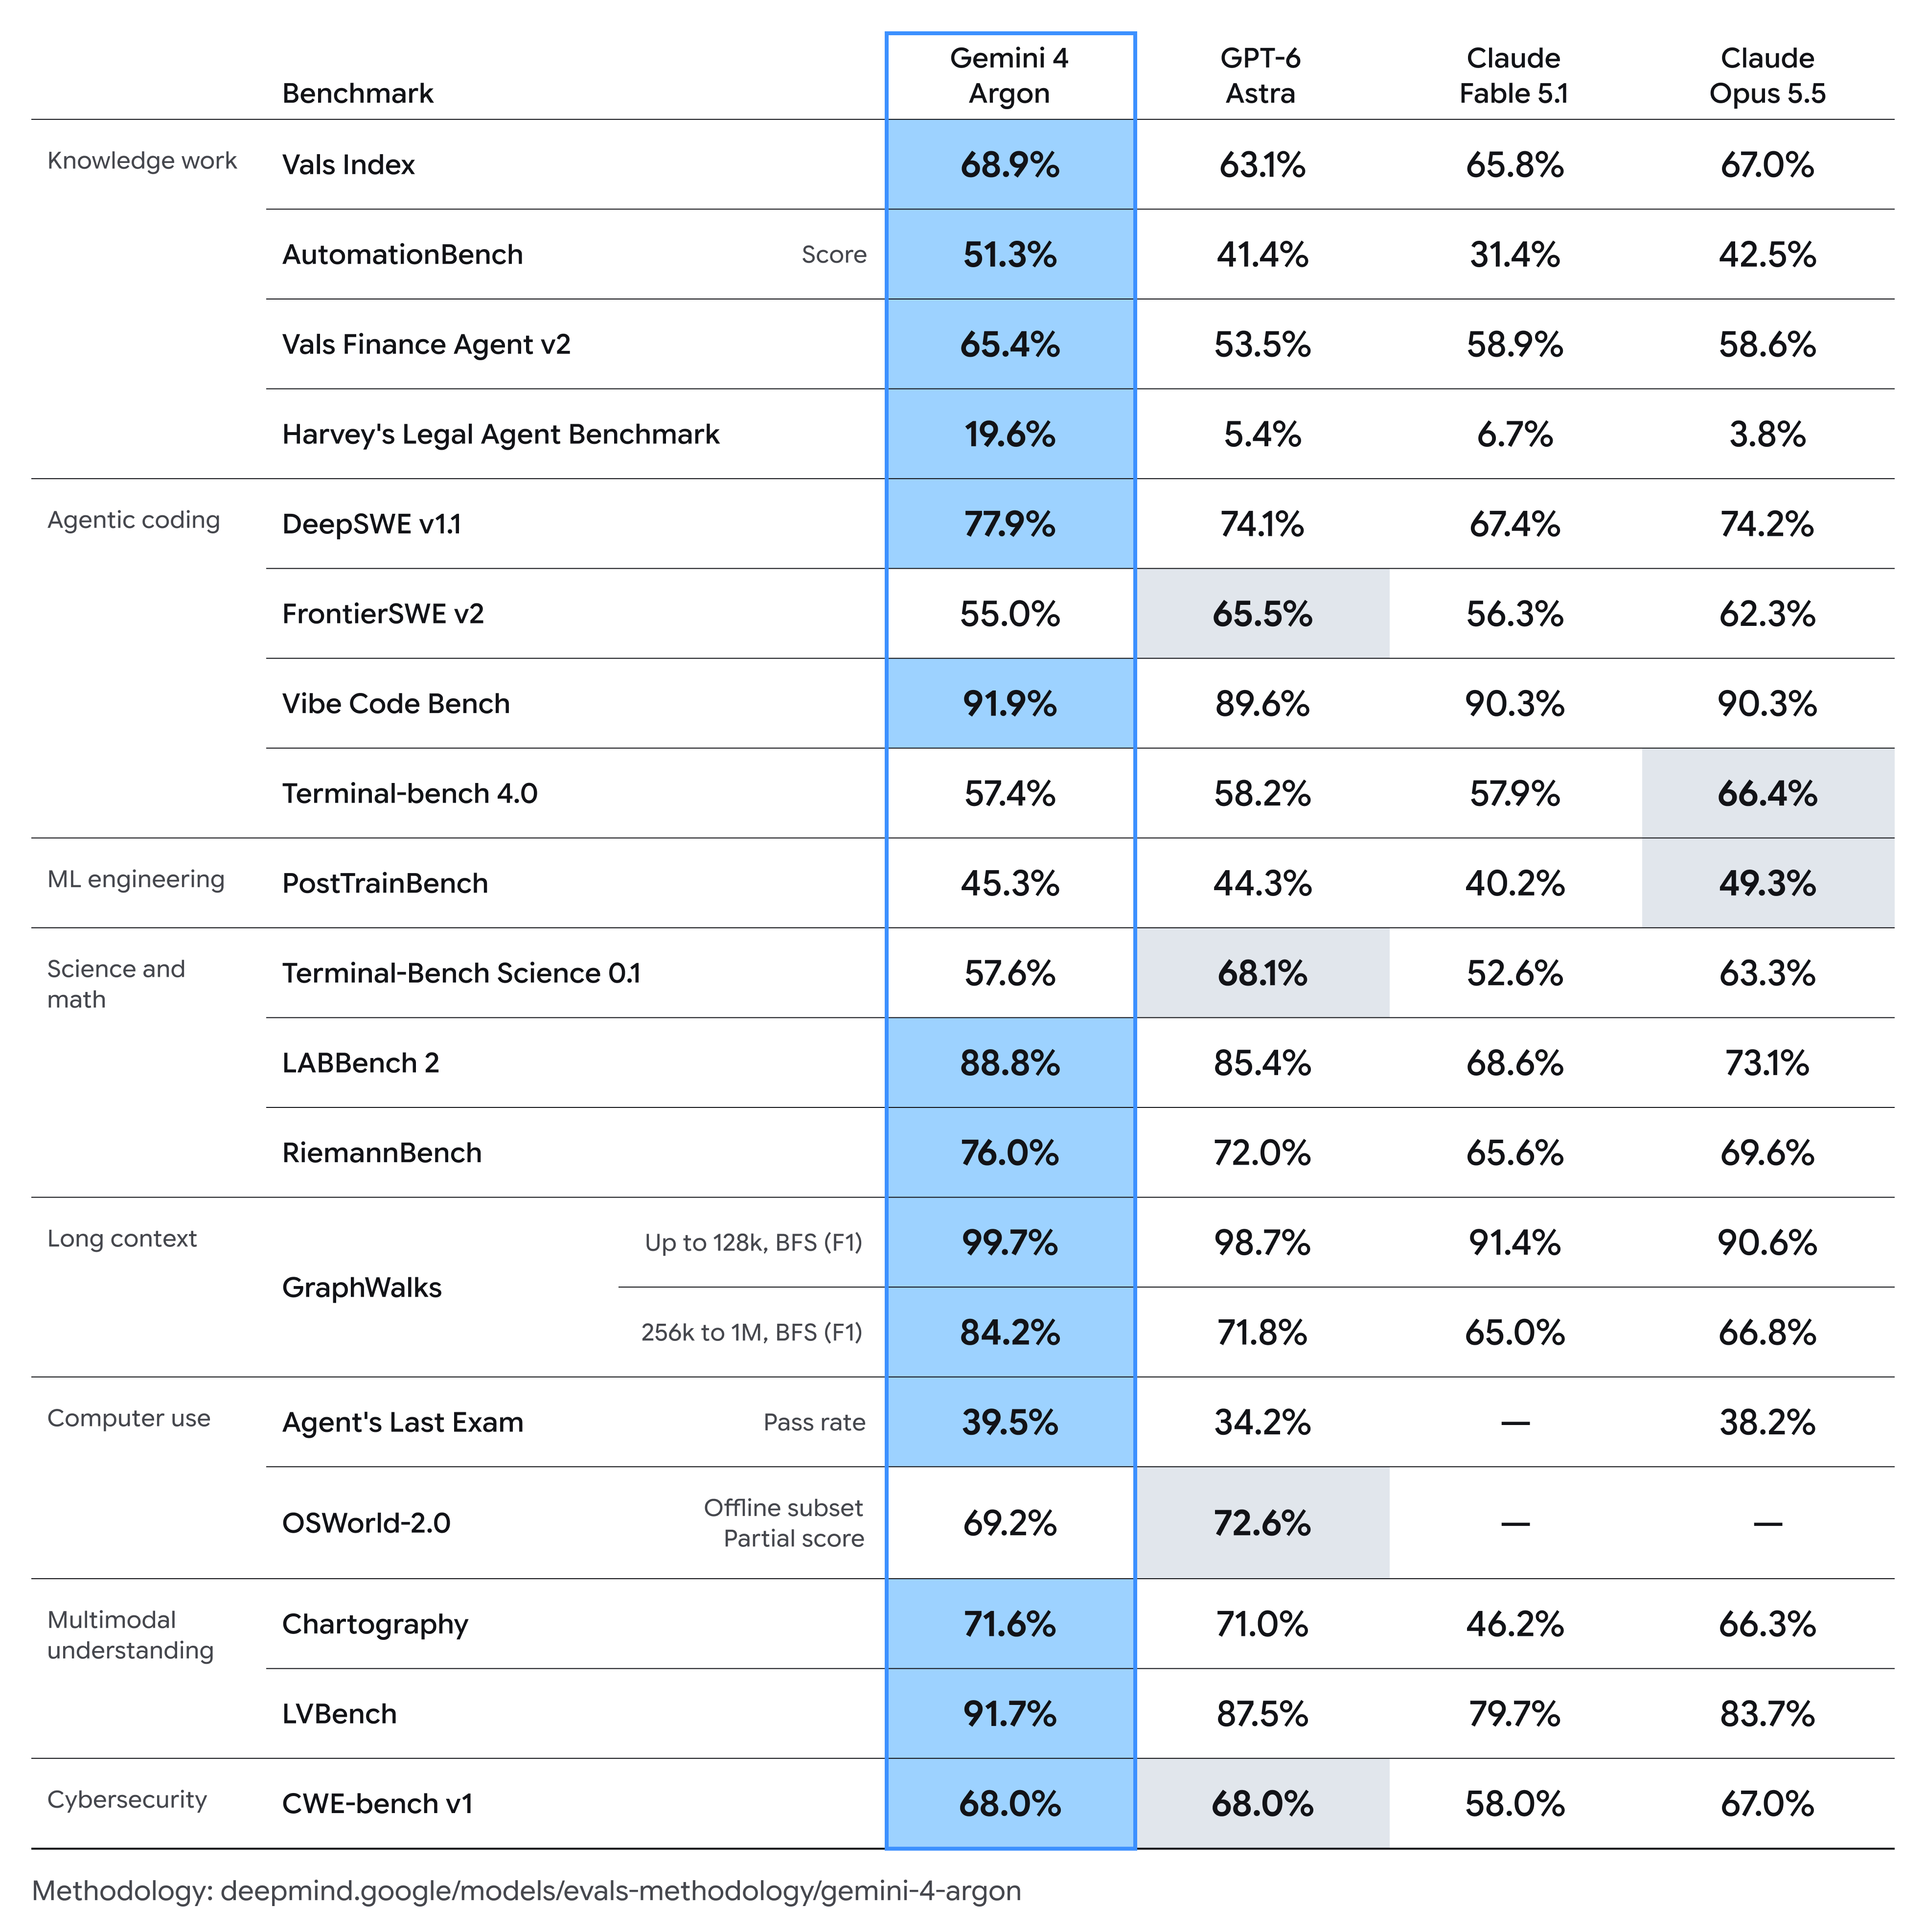 Abb.: Leistungsvergleichstabelle aus der offiziellen Ankündigung. Quelle: Google Blog
Kommerzielle Monetarisierung tritt hinter nationale Sicherheit zurück
In den vergangenen zwei Jahren folgte der Wettbewerb bei Spitzenmodellen stets einem festen Muster: Einem Entwicklungssprung folgte umgehend ein harter Preiskampf, verbunden mit dem Appell an Start-ups, ihre Geschäftsprozesse an die neue API anzubinden. Bei Gemini 4 Argon trennt Google die Veröffentlichung nun in zwei Ebenen. Auf der sichtbaren Seite steht ein Einstiegspreis, der das bisherige Preisgefüge der Branche neu ordnet. Auf der unsichtbaren Seite greifen jedoch Sicherheitsvorgaben, die weitaus strenger sind als bei früheren Releases.
Die internen Praxistests bei Google haben gezeigt, welches Potenzial in Systemen steckt, die hunderttausende Zeilen Code analysieren und restrukturieren können. Wenn ein Modell innerhalb von Minuten Kernelspeicher-Verwaltungen neu ordnet oder anhand vollständiger Telemetriedaten Schwachstellen aufspürt, verändert sich die Risikolage grundlegend. Ein unkontrollierter Zugriff über das öffentliche Internet käme dem Verteilen eines autonomen, permanent aktiven Angriffswerkzeugs an jeden Netzwerkknoten gleich. Die Phase, in der Modelle nach kurzen internen Tests zügig bereitgestellt wurden, ist damit beendet.
Die Vergabepraxis für Spitzen-KI wurde neu geordnet: Indem Google Sicherheitsverteidigern den Vorzug gibt und sich freiwillig staatlichen Prüfungen unterzieht, wandelt sich die Bereitstellungsstrategie von einer nachträglichen Regulierung hin zu einer vorgelagerten Zertifizierung. Reguläre Entwickler und Unternehmenskunden müssen sich hinter nationalen Sicherheits- und Schwachstellenanalysen einreihen. Wenn der Speer so scharf geschliffen ist, müssen die Verteidiger lernen, ihn abzuwehren, bevor er in den Umlauf gerät.
Weiterführende Links:
- Ankündigung im Google Blog
- Diskussion auf Hacker News