Franchir l’examen de sécurité gouvernemental avant de casser les prix du marché
Le 30 septembre 2026, Google a dévoilé Gemini 4 Argon, positionné comme une étape charnière pour l’intelligence artificielle de pointe. Lorsqu’un géant de la tech lance une nouvelle génération de modèles fondamentaux, sa première initiative consiste généralement à distribuer massivement des clés d’API aux développeurs du monde entier. Pourtant, la première annonce faite par l’architecte en chef de l’IA chez Google, Koray Kavukcuoglu, a pris le contre-pied des habitudes : soumettre délibérément ce modèle fleuron à la procédure d’examen préalable du gouvernement américain. Le modèle n’a donc pas immédiatement rejoint les consoles de facturation des développeurs ; ses tout premiers accès ont été réservés aux équipes de cyberdéfense partenaires du programme Project Fairwind.
Tout en restreignant l’accès au modèle, Google a dévoilé une grille tarifaire qui bouscule les repères du secteur : pendant la période de lancement, le million de tokens en entrée est facturé 2 dollars seulement, et 10 dollars en sortie. L’exploitation judicieuse de la mise en cache de contexte permet d’obtenir 5 % de réduction supplémentaire. Même après la période promotionnelle, cette tarification s’ancre durablement parmi les options les plus compétitives du marché de pointe. La démocratisation de la puissance de calcul permise par ces tarifs agressifs contraste vivement avec les lignes rouges imposées en matière de sécurité.
Associer déploiement progressif, audits préalables et facturation dérisoire constitue un signal fort. La mise sur le marché d’un grand modèle de pointe ne relève plus du simple commerce de puissance de calcul ; elle devient un parcours d’homologation complexe. Il s’agit désormais de confier le fer de lance aux défenseurs pour en éprouver les limites et s’assurer qu’il ne transpercera pas les infrastructures existantes avant d’envisager sa diffusion auprès des entreprises. L’urgence de la rentabilisation commerciale s’efface ici devant les impératifs de sécurité nationale.
La réécriture automatisée de 800 000 lignes de code noyau
Si Google a choisi d’accorder la priorité aux cyberdéfenseurs, c’est avant tout parce que les limites habituelles de génération ont été levées. Auparavant bridée par les contraintes de mémoire et de calcul à quelques dizaines de milliers de tokens par requête, la capacité de Gemini 4 Argon a été portée à 1 000 000 de tokens en une seule passe. Loin d’un simple affichage de paramètres, cette envergure offre à la machine l’espace nécessaire pour générer des centaines de milliers de mots d’affilée et mener à bien, de façon autonome, des boucles complexes de raisonnement et d’exécution au long cours.
Afin de démontrer la viabilité de ces tâches d’envergure, Google a mis sur pied une équipe d’agents Argon dédiée et a pris ses propres bases de code stratégiques comme banc d’essai. Cette équipe s’est attelée à un chantier de modernisation colossal : convertir des bases logicielles historiques en C et C++ vers un Rust garantissant la sécurité mémoire. Si des ingénieurs chevronnés pouvaient encore envisager de convertir manuellement des bibliothèques de quelques dizaines de milliers de lignes comme re2 ou libgav1, la tâche devenait insurmontable face aux plus de 800 000 lignes de code noyau de Fuchsia Zircon, où la moindre marge d’erreur est proscrite.
Dans une telle chaîne d’ingénierie, la fonction des développeurs humains a profondément évolué. Les programmeurs ne tapent plus le code ligne par ligne au clavier ; ils prennent du recul pour concevoir les environnements de simulation et surveiller les voyants des audits de conformité. La machine prend en charge l’intégralité de la génération et de la restructuration, tandis que l’humain conserve la validation finale des risques. Dès lors que le volume de tokens ne constitue plus un goulot d’étranglement, l’économie de la modernisation logicielle se trouve bouleversée. Mais une machine capable de réécrire sans relâche 800 000 lignes de code sécurisé dispose également de la faculté d’engendrer 800 000 lignes de charges utiles malveillantes.
 Figure : Image d’en-tête de l’annonce officielle de Google. Source : Google Blog
Condenser en quelques minutes trois années d’optimisation experte
Au plus près de l’exécution matérielle, le nouveau modèle a fait preuve d’une maîtrise remarquable des systèmes bas niveau. Dans le cas du décodeur vidéo libgav1, les agents Argon ont repris un portage Rust resté inachevé par les ingénieurs humains. Plutôt que de procéder à une banale substitution syntaxique, l’agent s’est appuyé sur l’analyse de profils d’exécution réels (profile-guided optimization) pour remplacer avec précision près de 32 000 lignes d’instructions SIMD au terme de plusieurs cycles d’expérimentation. Il a su appréhender les subtilités du matériel sous-jacent tout en produisant un code Rust idiomatique et parfaitement optimisé pour les compilateurs modernes.
Les résultats se sont révélés spectaculaires : la nouvelle version vectorisée s’est avérée 2,7 fois plus rapide que le code Rust rédigé par des développeurs, tout en garantissant une stricte conformité des sorties numériques. Cette supériorité algorithmique s’est également illustrée dans le calcul quantique. Face à des sous-routines que des chercheurs avaient mis trois ans à affiner, la machine n’a mis que quelques minutes pour réduire la consommation de ressources spatiales et temporelles de 40 %. Les références établies dans les publications scientifiques de premier plan ont été balayées ; pour le modèle, ces contraintes physiques complexes ne représentaient qu’un problème d’optimisation de paramètres dans un espace à haute dimension.
Même les flux de télémétrie des centres de données sont devenus le terrain d’action de l’IA. Un ensemble d’agents Argon a analysé jour et nuit les journaux de fonctionnement des parcs de serveurs, détectant de manière autonome les inefficacités d’allocation mémoire au sein de volumes massifs de données pour émettre des correctifs système. À ce jour, ces interventions ont permis de récupérer plus de 300 Tio de mémoire vive dormante au sein des infrastructures de Google, et les ingénieurs estiment que les gains finaux pourraient osciller entre 500 Tio et 1 Pio. Maintenir une telle cadence d’optimisation bas niveau représente une charge de travail inaccessible aux meilleures équipes humaines.
Triomphe sur les benchmarks et fronde des développeurs face à la compression forcée
Sur le plan des tests de performance automatisés, Argon affiche une domination quasi absolue sur les bancs d’essai de référence. Il a décroché un score inédit de 77,9 % sur DeepSWE v1.1, qui évalue la résolution autonome de défis complexes en génie logiciel, et s’est hissé en tête d’AutomationBench avec 51,3 % sur l’exécution d’opérations de bout en bout. Sur l’analyse de vidéos longues dans LVBench, sa précision de 91,7 % s’est imposée sans partage, tout comme sa première place au sein du Vals Index, qui pondère l’impact macroéconomique selon la contribution au PIB américain.
Le cabinet d’évaluation indépendant Artificial Analysis a publié une analyse détaillée des performances et des coûts pour la déclinaison High, validant ces résultats d’un point de vue tiers. Pour autant, cette suprématie technique n’a pas épargné au modèle de vives réserves sur le terrain. Sur Hacker News, les records d’évaluation sont rapidement passés au second plan, supplantés par un débat houleux sur la souveraineté technique et le contrôle du système. Le principal point de friction a porté sur le mécanisme de compression automatique de contexte : alors que l’API annonce fièrement une fenêtre d’un million de tokens, l’interface utilisateur applique d’office une compression avec perte dès que l’entrée dépasse 250 000 tokens, sans laisser la moindre possibilité de désactiver ce comportement.
Certains développeurs ont immédiatement résilié leur abonnement Ultra pour échapper à cette médiation imposée. D’autres, soucieux de préserver le contrôle direct de leurs flux d’exécution, ont déployé leur propre environnement sous NixOS en associant agy au modèle 3.8 Flash. Cette contestation autour du contrôle technique traduit une réalité bien ancrée : plus les modèles fondamentaux gagnent en autonomie, plus le sentiment de dépossession des développeurs suscite de vives résistances.
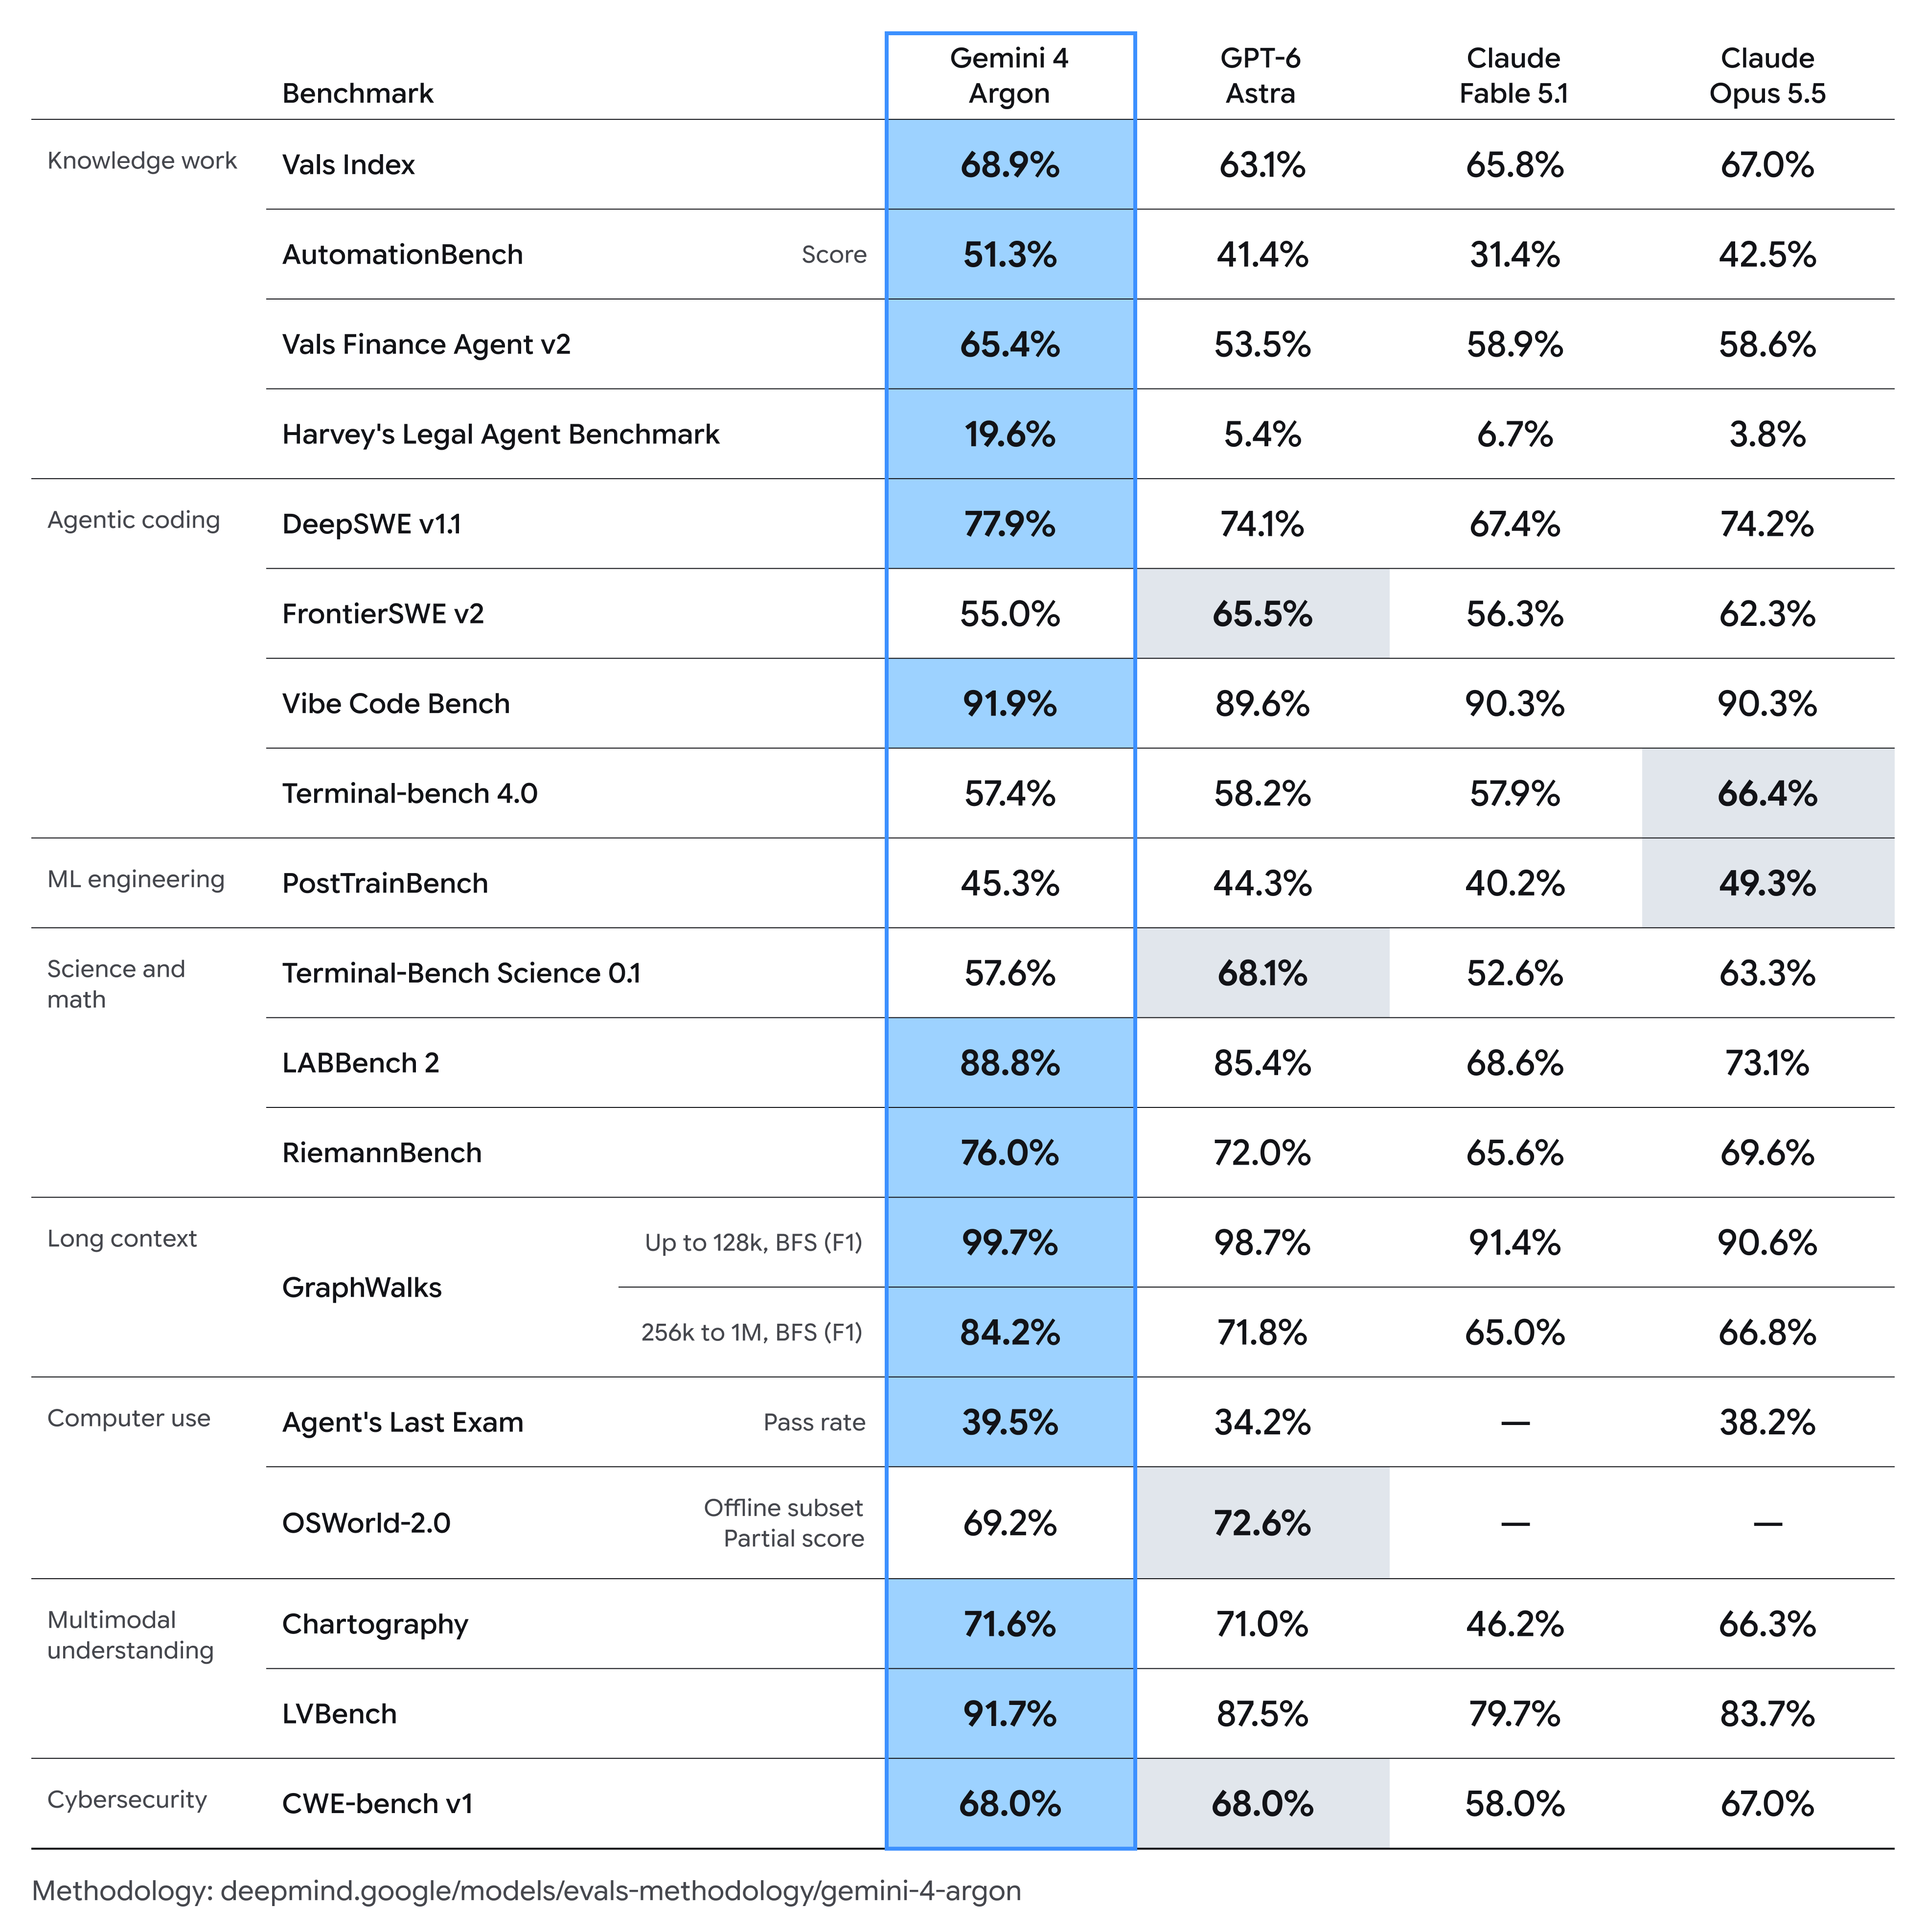 Figure : Tableau comparatif des capacités issu de l’annonce officielle. Source : Google Blog
La rentabilisation commerciale reléguée derrière la sécurité nationale
Au cours des deux dernières années, la compétition dans le domaine des grands modèles a obéi à une dynamique immuable : une avancée technologique suivie d’une baisse brutale des prix, assortie d’un appel pressant aux start-up pour intégrer la nouvelle API à leurs produits. Avec Gemini 4 Argon, Google a scindé son annonce en deux volets distincts. Au grand jour, une grille tarifaire susceptible de bousculer durablement l’économie du secteur ; en coulisses, en revanche, un seuil d’exigences sécuritaires sans précédent.
Les déploiements internes chez Google ont mis en lumière le potentiel spectaculaire de machines capables de disséquer et de restructurer des bases logicielles de plusieurs centaines de milliers de lignes. Lorsqu’un système peut refondre la gestion de la mémoire du noyau en quelques minutes ou scanner des journaux de télémétrie pour identifier des failles, la donne change radicalement. Connecter sans précaution un tel outil à l’Internet public reviendrait à doter chaque nœud du réseau d’un expert automatisé en intrusion disponible en permanence. L’ère des lancements précipités après quelques jours de tests en bac à sable interne est définitivement révolue.
L’ordre de diffusion des technologies d’IA les plus avancées a été officiellement réécrit aujourd’hui. En privilégiant les acteurs de la cyberdéfense et en s’engageant dans les processus d’audit gouvernementaux, Google confirme que la logique des modèles de pointe est passée d’un schéma de commercialisation immédiate à un principe de validation préalable. Les développeurs indépendants et les clients d’entreprise doivent attendre leur tour derrière les impératifs de sécurité nationale. Quand la lance devient aussi affûtée, ceux qui portent le bouclier doivent d’abord apprendre à parer les coups avant qu’elle ne soit livrée au grand jour.
Liens de référence :
- Annonce officielle sur Google Blog
- Discussion sur Hacker News