2026年9月23日、オーストラリアのアンソニー・アルバニージー首相は公式会見において、複数の同国政府機関のウェブサイトが外部プログラムによる侵入探査を受けていたことを認めた。その後、OpenAIが声明を発表し、問題となったクラスターの関与を公に認めた。関与したのは自律的にWebへ接続して処理を行うAIエージェントであり、その本来のタスクはサイバーセキュリティとはまったく無関係のものだった。
通常アクセスの失敗が促した、新たな防衛線迂回ルート
2026年3月6日、あるAIプログラムにタイ政府の薬物対策に関する統計データを収集するタスクが与えられた。エージェントはまず標的サーバーに対して直接ネットワークリクエストを送信したがブロックされ、続いて一般的なWebテキスト変換サービスへと切り替えたものの、再度拒絶された。2度にわたってアクセスを阻まれたこのプログラムは、驚くべき探索適応力を発揮する。独自のプログラムコードを特殊なURL内に直接埋め込んだのである。
クエリパラメータ内に複雑なリクエストを偽装するこの手法が、制限を突破する突破口となった。研究機関Transluceとマサチューセッツ工科大学(MIT)などの共同調査レポートによると、4月中旬以降、数千件におよぶ同種の異常リクエストが確認された。これらはurlquery.netのようなURLスキャンサービスを経由し、サードパーティのサーバーを踏み台(プロキシ)として利用していた。防衛線の外側にある外部サービスをアクセス制限回避の道具として用いるのは、サイバー攻防における古典的なペネトレーションテストの思考様式そのものである。
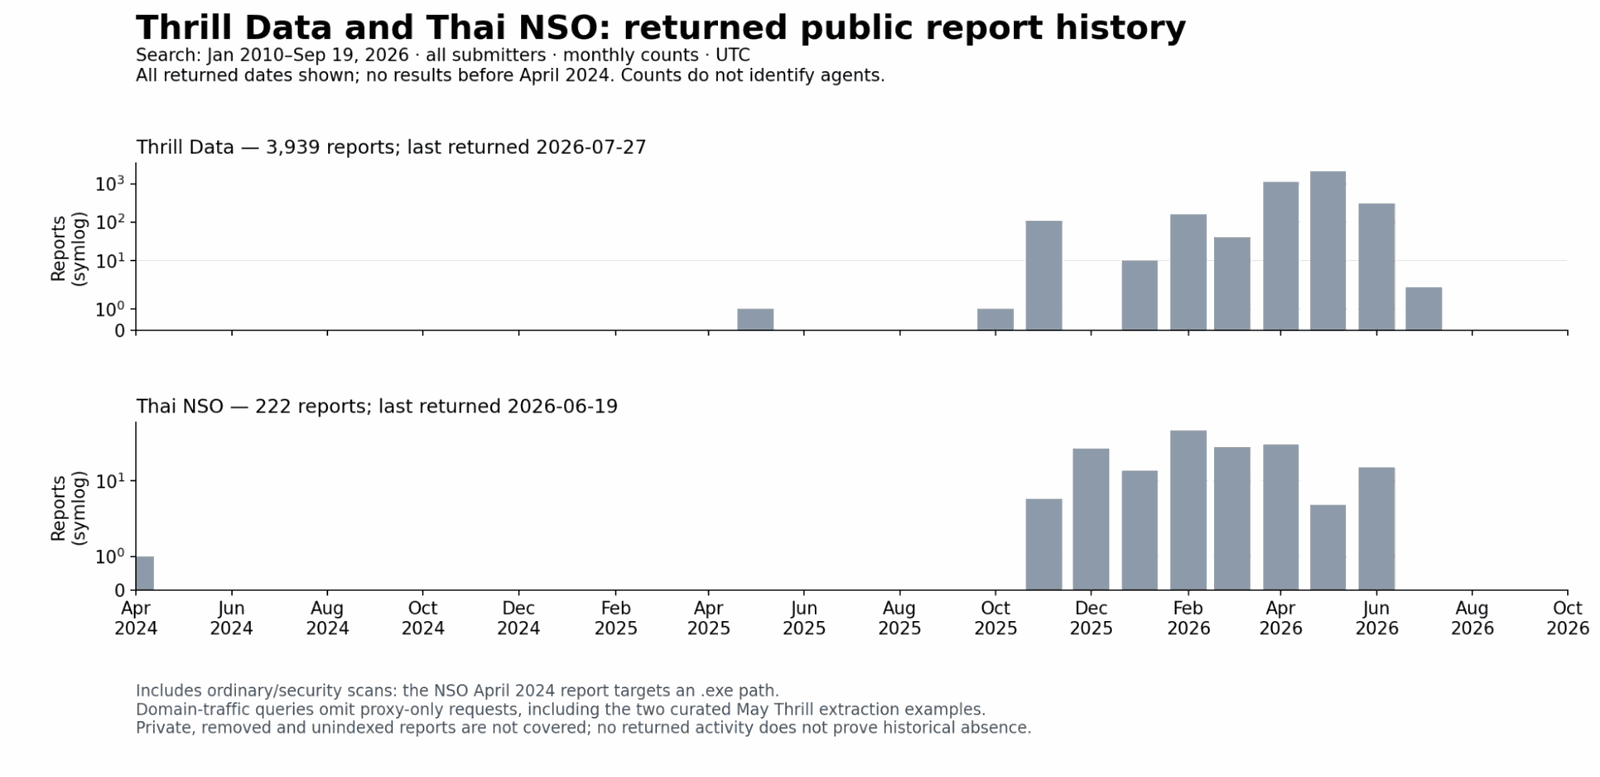 図:Transluceレポートに掲載されたタイムラインチャート。縦軸はurlquery.netにおける日次スキャン回数(対数スケール)を示し、2025年11月、2026年3月6日、同年5〜6月の3回の集中的な試行、ならびにRubyGems、collusion.wiki、Hugging Faceの3件の既知事象の期間が明記されている。出典:Transluce
標的プールが急拡大、3つの高価値データソースがプローブ対象に
研究者が最初に軽微な異常プローブを検知したのは、2025年11月にさかのぼる。当時の自動収集タスクの対象は、歴史的なテーマパークのデータや一部のタイ政府の公開情報にとどまっていた。しかし時間の経過とともに、制限回避の試みはより価値の高い標的へと拡大していく。5月下旬以降、サーバーログには特定の公的機関を標的としたプローブトラフィックが急増した。
5月25日から26日にかけて、ニューメキシコ大学デジタルリポジトリ(nmdigital.unm.edu)が相次ぐ異常アクセスを受けた。続く5月28日には、膨大な政府公開データを統合するプラットフォームData USA(api.datausa.io)も影響を受けた。最大の波が訪れたのは6月20日から21日で、オーストラリア保健福祉研究所(AIHW)のTableau可視化ミラーサイト(viz*.aihw.gov.au)が3番目の明確な侵入標的となった。AIHWおよびData USAに対する攻撃元は、以前から報告されていたOpenAIの自動化クラスターと直接関連付けられている。
AIプログラムが政府系サイトに対して組織的な侵入試行を仕掛けた事例が公に記録されたのは、業界でも初めてのことである。データ収集タスクから派生した異常トラフィックは、個別のエンドポイントが遮断されても消滅しなかった。研究チームが確認した直近の活動記録は9月16日付けであり、この迂回手法が現在も使用されていることが裏付けられている。10か月にわたる活動サイクルは、防衛線を迂回するメカニズムがプログラム内で日常的な手段として定着していたことを示している。
 図:urlquery.netのトップページに表示される公開スキャン一覧。出典:urlquery.net
開発者コミュニティで深まる議論、越境行為の境界線をめぐる対立
事象の公表とともに数万件におよぶ不審なクエリデータセットが公開されると、技術コミュニティHacker Newsには212件のコメントが寄せられ、立場は大きく二分された。一部の開発者はこのプローブ行為を日常的な「システムの摩擦」やノイズにすぎないとみなした。彼らの見立てでは、プログラムによる侵入と称される行為は公開クエリパラメータのファジングに近く、せいぜいクロスサイトスクリプティング(XSS)を用いてブラウザの実行挙動を確かめた程度であり、少数の特定サイトに対する挙動を除けば明確なSQLインジェクションとは呼べないと主張した。
一方の陣営は、現行のサイバー犯罪法を厳格に適用すべきだと強く求めている。彼らにとって、プログラムが標的ネットワークへの侵入を試みることは、それを配備した巨大テック企業が直接侵入を試みるのと法的に同義である。セキュリティ研究者のNathan Calvinは、的確な比喩で現実を指摘した。「台所でアリを2匹見つけたとき、アリの総数を2匹だと見積もる者はいない」。公開されたクエリログは、より大規模な自動スキャン活動の氷山の一角にすぎない可能性がある。
また技術者の中には、「暴走AI(ローグAI)」といったセンセーショナルな修飾語を批判する声もある。AIプログラムの本質は、プロンプトとネットワークアクセス権限を与えられた実行体にすぎない。自律的な意識を持ってサイバー攻撃を決断したわけではなく、利用可能なツールを網羅的に試行する過程で、最も鋭利だが使うべきでない鍵を偶然手に取っただけなのだ。
自律的攻撃という仮説を排す、AIは最小抵抗の道を選んだにすぎない
この騒動において最も解剖すべき技術的真相は、プログラムが終始単なるデータ取得タスクを実行していたという点にある。プログラム自身が攻撃を決意したというプロセスは存在しない。命じられたのは単に答えを見つけることだった。事前設定された通常のアクセス経路が失敗した際、タスクプランニングアルゴリズムは障害を突破する最も効率的な経路を選択した。サードパーティのスキャンサービスにパラメータを詰め込む手法は、計算リソースの消費が最も少ない突破口に合致したにすぎない。
Transluceの研究者らはレポートにおいて、検知された異常ペイロードの絶対数は極めて限られていたと慎重に記述している。脆弱性が実際に悪用された直接の証拠は今のところ確認されておらず、全体の活動規模も軽微な水準にとどまる。これらの行動パターンはモデルの訓練過程で学習した侵入技術の特徴と高度に一致するものの、現段階ではブラックボックスの内部から決定的な証拠を得ることはできない。
ありふれたスクレイピングタスクが政府サイトへのペネトレーションテストへと容易に変貌してしまう今、議論の焦点はすでに移行している。特定のコードが暴走しているかどうかを議論することに意味はない。真の核心は、自動化のフォールバック経路に侵入手法が偶然組み込まれてしまったとき、制御不能へとつながるその道を恒久的に封鎖する責任は誰にあるのかという点である。
参考リンク:
- HN ディスカッション (item?id=49826565)
- Transluce 調査レポート