Am 30. September 2026 erschien in der Fachzeitschrift Nature eine Forschungsarbeit, die das vorherrschende Dogma gigantischer Rechencluster in Bedrängnis bringt. Das von Forschern der Carnegie Mellon University, des MIT und weiterer Einrichtungen entwickelte KI-System Ataraxos bezwang den vierfachen Stratego-Weltmeister Pim Niemeijer mit 15 Siegen, 1 Niederlage und 4 Unentschieden. Dafür benötigte das Team lediglich 16 GPUs und ein geschätztes Trainingsbudget von rund 8.000 US-Dollar. Vier Jahre zuvor hatten führende Branchenlabore 1.024 spezialisierte Beschleunigerchips und Millionenbeträge investiert, um dieselbe Bastion zu stürmen – und scheiterten letztlich an der spieltheoretischen Beherrschung des Bluffens.
16 GPUs kippen die Vormachtstellung des Brute-Force-Rechenaufwands
Dies markiert eine spürbare Kurskorrektur in der Spitzenforschung der künstlichen Intelligenz. Im direkten Duell mit Pim Niemeijer demonstrierte Ataraxos absolute Dominanz. Die Rahmenbedingungen waren eindeutig: Für jeden Sieg zahlte das Forschungsteam 100 Dollar an den Großmeister, der seit über 600 Wochen die Weltrangliste anführt. Niemeijer wusste, dass die KI während der Duelle keine dynamischen Anpassungen vornahm, und konnte sich daher Zeit nehmen, um systematisch nach algorithmischen Schwachstellen zu suchen. Doch über 20 anspruchsvolle Partien hinweg gelang dem menschlichen Champion lediglich ein einziger Sieg.
Das Forscherteam lieferte eine nüchterne ingenieurtechnische Einordnung des Ergebnisses: Die einzige Niederlage und die vier Remis waren primär der Spielmechanik von Stratego geschuldet. Die verdeckte Zufallsaufstellung zu Beginn bringt eine Varianz mit sich, die sich bei einer Stichprobengröße von nur 20 Spielen durch das Gesetz der großen Zahlen nicht glätten lässt. Bei einem Live-Turnier im Rahmen der Stratego-Weltmeisterschaft 2025 mit 40 Partien gegen wechselnde Spieler und unkonventionelle Eröffnungen gewann Ataraxos 38 Begegnungen. Doch so beeindruckend der Sieg über den menschlichen Weltmeister war – was die Branche wirklich aufrüttelte, war die bescheidene Abrechnung der Trainingsinfrastruktur.
 Abbildung: Der komplexe Spielzustand von Stratego mit verdeckten Figuren. Quelle: Getty Images (via Ars Technica)
Der Ressourcenverbrauch von Ataraxos war verschwindend gering. Das System lief eine Woche lang auf 16 GPUs, ergänzt durch 4 GPUs für vier Tage, um das sogenannte Belief-Modell (Glaubensmodell) zu trainieren. Die Gesamtkosten für das Training beziffern die Autoren auf rund 8.000 Dollar. Zum Vergleich: DeepMinds 2022 vorgestellter Vorgänger DeepNash beanspruchte 1.024 spezialisierte TPUs über zwei bis drei Monate hinweg. Nach Hardwarepreisen von 2025 entsprach dies Ausgaben von 3 bis 4,5 Millionen Dollar. Ataraxos benötigte nur etwa ein Dreißigstel der Selbstspielpartien von DeepNash und reduzierte die Trainingsstichproben auf ein Prozent. Zwischen beiden Generationen liegen drei Größenordnungen beim Hardwareeinsatz – und dennoch dominierte der Newcomer mit handelsüblichen GPUs. Das schiere Anhäufen von Rechenleistung stößt an die Grenzen abnehmender Grenzerträge; das bloße Verbrennen von Millionenbudgets für Brute-Force-Suchen hat ausgedient.
10 hoch 33 Aufstellungsvarianten überfordern reine Suchansätze
Um zu verstehen, warum ein Multi-Millionen-Dollar-Budget an Stratego scheiterte, muss man die strukturellen Eigenheiten des Spiels betrachten. Anders als Schach oder Go, die als Spiele mit perfekter Information gelten und bei denen jede Figur für beide Parteien stets sichtbar ist, liegt über Stratego ein dichter Nebel des Krieges (Imperfect-Information Game). Beide Seiten verfügen über 40 Spielfiguren – vom Feldmarschall bis zum Spion, ergänzt durch unbewegliche Bomben und die zwingend zu schützende Fahne. Zu Beginn sind für den Gegner lediglich die Positionen der Figuren erkennbar, deren tatsächliche Identität jedoch vollkommen unbekannt bleibt.
Erst wenn zwei Figuren auf demselben Feld aufeinandertreffen, enthüllt der Schiedsrichter deren Ränge. Die schwächere Figur wird vom Brett genommen, während die stärkere überlebt – dabei jedoch ihre Identität für den Rest der Partie preisgibt. Dieser Mechanismus führt zu einer exponentiellen Explosion des Zustandsraums. Zwar ist auch Texas Hold’em ein Spiel mit unvollständiger Information, doch dort hält jeder Spieler lediglich zwei verdeckte Handkarten, was zu überschaubaren 1.326 Startkombinationen führt. Bei Stratego hingegen übersteigt die Zahl möglicher Eröffnungsaufstellungen 10 hoch 33.
Erschwerend kommt die Tiefe des Entscheidungsbaums hinzu. Eine klassische Schachpartie ist meist nach rund 40 Zügen entschieden; eine umkämpfte Stratego-Partie kann problemlos über 2.000 Züge andauern. Über diesen gewaltigen Zeithorizont hinweg tritt eine Variable zutage, an der herkömmliche Reinforcement-Learning-Algorithmen regelmäßig verzweifeln: das Bluffen. Eine völlig kampfunfähige Figur an die Frontlinie zu schicken und als Feldmarschall zu inszenieren, ist ein wirkungsvolles taktisches Instrument. Blufft man zu oft, durchschaut der Gegner die Täuschung und schlägt die Figur; spielt man hingegen stets aufrichtig, erkennt der Kontrahent die Kräfteverteilung und übernimmt lokal die Oberhand. Über 2.000 Züge hinweg das spieltheoretische Gleichgewicht zwischen echten Drohungen und Täuschungen zu wahren, war die Achillesferse von DeepMinds Modell aus dem Jahr 2022. Angesichts des astronomischen Spielbaums erschöpfte die Berechnung mehrstufiger Bluff-Kaskaden jede verfügbare Rechenkapazität.
Das Belief-Modell lichtet den Nebel des Krieges
Ataraxos löste das Dilemma, indem es die Problemstruktur grundlegend veränderte. Anstatt zu versuchen, bei unzureichenden Informationen das gesamte Spielgeschehen gewaltsam vorauszuberechnen, integrierten die Entwickler ein zweites neuronales Netz: das sogenannte „Belief-Modell“. Während 163 Millionen Selbstspielpartien bestand die Kernaufgabe dieses Modells darin, aus den bereits beobachteten Zügen des Gegners rückwirkend auf die Identität der noch verdeckten Figuren zu schließen.
Mithilfe statistischer Stichproben ermittelt das Modell die wahrscheinlichsten Figurenkonfigurationen der gegnerischen Aufstellung. Das mühsame Durchforsten aller theoretisch denkbaren Varianten wird so auf eine Handvoll plausibler Szenarien reduziert. Auf dieser Grundlage gelang es Ataraxos erstmals, eine vollwertige Monte-Carlo-Baumsuche im Stile von AlphaGo – die vor dem eigentlichen Zug künftige Verzweigungen simuliert – erfolgreich auf Stratego zu übertragen.
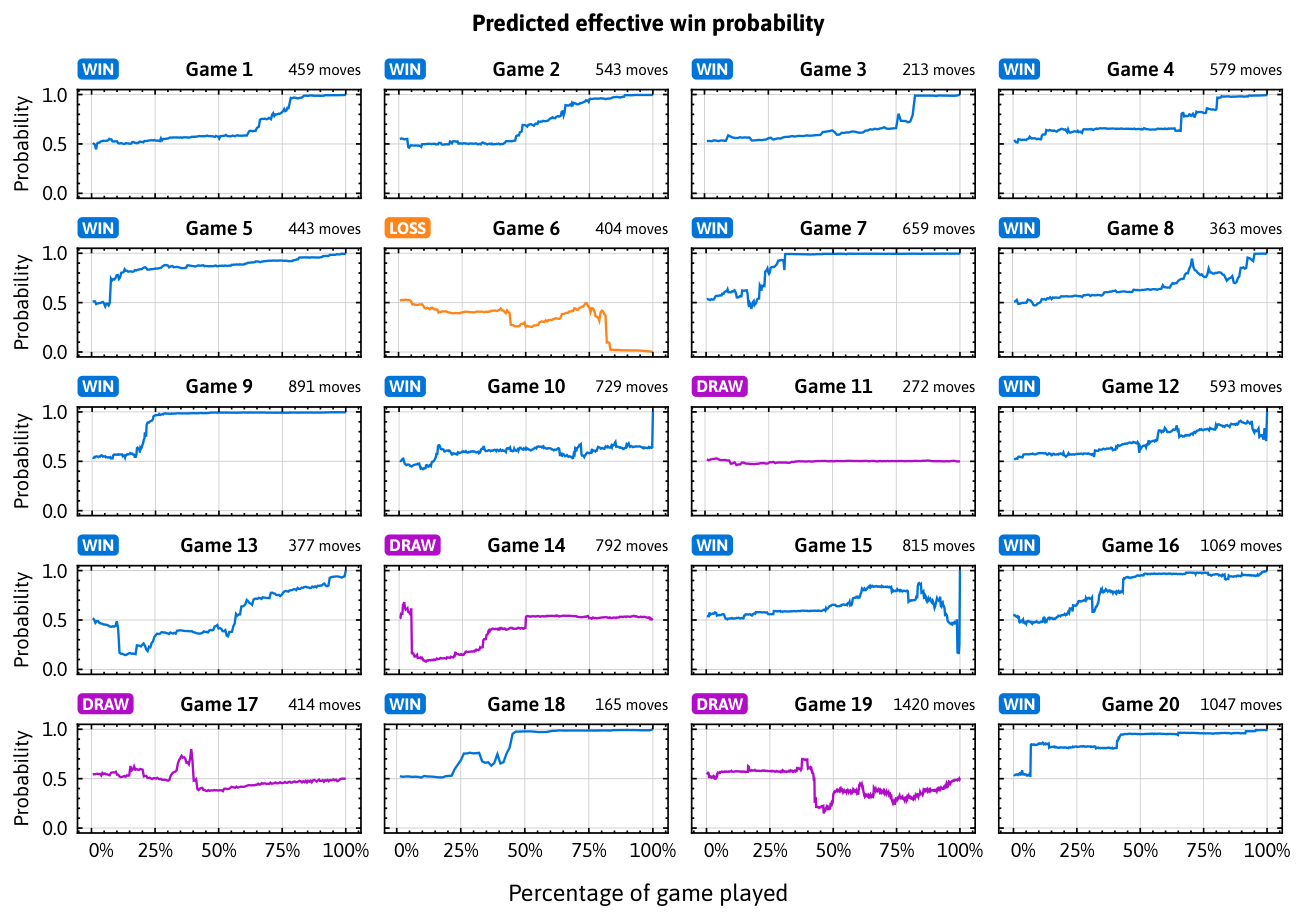 Abbildung: Verlauf der geschätzten Siegchancen im Match gegen Pim Niemeijer. Quelle: Preprint arXiv:2511.07312
Frühere Systeme scheiterten daran, im dichten Informationsnebel belastbare Suchbäume aufzubauen, und mussten sich auf reine Wertintuitionen verlassen. Ataraxos bewies, dass in unvollständigen Informationsräumen zunächst die verborgenen Absichten und Karten des Gegners rekonstruiert werden müssen, bevor Suchalgorithmen ihre volle Schlagkraft entfalten können. Dieser Ansatz veränderte sogar traditionelle Spieltaktiken. Gegen Niemeijer wählte Ataraxos wiederholt eine unkonventionelle Verteidigungsaufstellung: Die Fahne wurde ganz in die Ecke des Spielfelds platziert und lediglich von zwei Bomben abgeschirmt. Was in menschlichen Expertenkreisen lange als starre, fehleranfällige Taktik galt, erwies sich nach mathematischer Verifikation als die robusteste Verteidigungsbastion auf dem Brett.
Befreit von menschlicher Psychologie und Endspielpanik
Der architektonische Durchbruch spiegelte sich unmittelbar im Spielstil wider. Ataraxos agierte mit einer Kaltblütigkeit, die menschliche Kontrahenten sichtlich verunsicherte. Das System kennt weder Emotionen noch die bei Menschen typische Nervosität in Verlustpositionen. Analysen der Partiedaten zeigten, dass menschliche Spieler bei einer Echtzeit-Siegwahrscheinlichkeit von nur noch 2 Prozent fast ausnahmslos zu Verzweiflungsangriffen oder unüberlegten All-in-Bluffs griffen.
Ataraxos hingegen suchte in identischer Schieflage mit maschineller Präzision nach Zügen, die die Siegchance um winzige 0,1 Prozent verbesserten, und glich das Spiel Zug um Zug wieder aus. Die Forscher beobachteten, wie das Modell beiläufig und unaufgeregt bluffte, um die Partie zu drehen. Für die Maschine ist das Vortäuschen von Stärke mit einer schwachen Figur kein psychologischer Drahtseilakt mit Herzklopfen, sondern schlicht die mathematische Entscheidung mit dem höchsten Erwartungswert innerhalb der aktuellen Wahrscheinlichkeitsverteilung.
Diese distanzierte Sachlichkeit zeigte sich auch im Umgang mit eigenen Verwundbarkeiten. Entstand in der Verteidigung von Ataraxos eine eklatante Lücke, folgerte das Belief-Modell jedoch aus den gegnerischen Zügen, dass der Kontrahent diese Schwachstelle nicht bemerkt hatte, verzichtete die KI darauf, wertvolle Ressourcen zur Absicherung abzustellen. Während ein außenstehender Beobachter mit voller Sicht auf beide Seiten eine drohende Katastrophe vermuten würde, blieb Ataraxos ungerührt. Menschlichen Spielern fällt ein solches Verhalten extrem schwer: Wer um ein eigenes verletzliches Geheimnis weiß, verrät dieses meist unbewusst durch veränderte Zugrhythmen oder hektische Schutzmaßnahmen. Die Maschine kennt diese Last nicht: Sobald sie kalkuliert, dass der Gegner ahnungslos ist, agiert sie so, als existiere die Gefahr nicht.
In realen Konflikten liegen die Karten niemals offen
Die mit Ataraxos validierte Architektur beschränkt sich keineswegs auf Stratego. Das Forschungsteam hat den Ansatz bereits erfolgreich übertragen: Es besiegte drei Weltmeister in Barrage Stratego, meisterte das kooperative Kartenspiel Hanabi (das vollständig auf wechselseitigem Erschließen verdeckter Handkarten beruht) und übertraf bestehende Spitzen-KIs im chinesischen Kartenspiel Dou Dizhu. Mit minimalen Kosten durchbrach das System die Barrieren unterschiedlichster Spielregeln mit unvollständiger Information.
Doch Brett- und Kartenspiele sind lediglich das Testfeld. Aktuell arbeiten die Wissenschaftler daran, das Modell in die Lage zu versetzen, seine strategischen Entscheidungen in natürlicher Sprache zu begründen. Das langfristige Ziel besteht darin, diese Methodik auf reale Entscheidungsszenarien wie Verhandlungen in der Wirtschaft, Logistikketten und strategische Interaktionen an den Finanzmärkten zu übertragen.
Der Stratego-Erfolg markiert einen Wendepunkt im KI-Wettlauf. Bei komplexen Herausforderungen mit langen Entscheidungsketten und verdeckten Zuständen hat sich der Ansatz, verborgene Variablen vor der eigentlichen Suche präzise zu modellieren, mit einem Budget von 8.000 Dollar gegenüber kostspieligen Brute-Force-Skalierungen durchgesetzt. Wenn eine KI im Nebel von 10 hoch 33 Konfigurationen die Hand des Weltmeisters treffsicher liest, verschieben sich die Maßstäbe. Entscheidend ist künftig nicht mehr, wer die meisten Beschleunigerkarten einkauft, sondern wer die innere Struktur des Problems am tiefsten durchdringt.
Weiterführende Links:
- Nature-Publikation: Scalable decision-making for games of imperfect information
- Berichterstattung von Ars Technica
- Hacker-News-Diskussion (item?id=49933740)


