2026 年 9 月 30 日,Nature 发表了一篇让大模型算力霸权显得有些尴尬的论文。一个由卡内基梅隆大学、MIT 等高校联合开发的系统 Ataraxos,用区区 16 块 GPU 和大约 8000 美元的训练成本,在军棋(Stratego)项目上以 15 胜 1 负 4 平的战绩,击溃了四次世界冠军 Pim Niemeijer。四年前,行业顶尖机构投入 1024 块专用芯片、耗资数百万美元尝试攻克同一座堡垒,却未能解决游戏中的诈唬难题。
16 块显卡掀翻算力霸权
这是前沿 AI 研发路线的一次剧烈修正。在与 Pim Niemeijer 的对决中,Ataraxos 表现出绝对的压制力。规则设定十分明确:每赢一局,团队就向这位霸占世界第一超 600 周的冠军支付 100 美元。Niemeijer 清楚 AI 不会针对他做动态调整,因此可以花时间缓慢试探系统漏洞。但在 20 局施压下,人类仅拿下一局。
研究团队对战绩给出了冷静的工程拆解:唯一的败局和四场平局,很大程度上是因为军棋开局必须随机盲摆棋子,运气成分无法在几十局样本里被大数定律抹平。而在 2025 年军棋世锦赛现场的 40 局挑战赛中,Ataraxos 顶着不同选手的怪异开局赢下了 38 局。打赢人类冠军固然震撼,但真正刺痛行业神经的,是那张寒酸的账单。
 图:军棋复杂的棋盘状态与隐匿棋子。来源:Getty Images(经 Ars Technica 报道使用)
Ataraxos 的算力消耗少得可怜。它只动用了 16 块 GPU 跑了一周,再加上 4 块 GPU 训练了四天信念模型。研究团队估算,训练成本在 8000 美元量级。作为对照,DeepMind 在 2022 年推出的前作 DeepNash,动用了 1024 块专用芯片训练两到三个月。如果按 2025 年的硬件市价折算,开销高达 300 万到 450 万美元。Ataraxos 玩的自对弈局数大约是 DeepNash 的三十分之一,训练样本被压缩到了百分之一。两代系统在算力投入上差了三个数量级,后起之秀却用廉价的显卡拿到了统治力。算力堆叠碰到了边际效益递减的墙,纯靠烧钱暴力穷举的方法论失效了。
10 的 33 次方种摆法拖垮穷举路线
要理解 400 万美元为什么会在军棋上吃瘪,必须看清这个游戏的结构缺陷。与国际象棋或围棋那种棋盘上信息公开的完美信息博弈不同,军棋是一个充满战争迷雾的盲盒。双方各持 40 枚棋子,军衔从元帅到间谍,外加无法移动的炸弹和必须被保护的军旗。在开局阶段,你只能看到对手棋子的位置,对它们的真实身份一无所知。
只有两枚棋子发生物理碰撞时,裁判才会揭晓双方军衔。较弱的一方被移除,胜者虽然存活,但也同时向全场暴露了自己最核心的底牌。这种设定带来的状态空间膨胀是指数级的。德州扑克虽然也是隐藏信息博弈,但玩家手里只有两张暗牌,起手组合不过 1326 种。而军棋在开局阶段,可能的棋子摆法组合数量超过了 10 的 33 次方。
更致命的是决策链路深度。一局国际象棋通常在 40 步左右分出胜负,而军棋的拉锯战可以轻松超过 2000 步。这种超长线交互,催生了一个连强化学习也极易陷入死胡同的变量:诈唬。游戏中把一个毫无战斗力的底层弱子伪装成元帅推上前线,是一种破坏力极强的战术。你诈唬多了,对手就会看穿你的虚张声势直接吃掉你的子;但如果你永远打诚实牌,对手摸透了真实战力分布,就会在局部形成压制。如何在漫长的 2000 步里维持真假参半的威胁平衡,正是 DeepMind 2022 年那版模型没能解开的死穴。面对庞大的状态树,传统算法在处理多步连环诈唬时,算力直接被耗干。
信念模型在迷雾里锁定底牌
Ataraxos 的解法是直接改变问题的结构。它放弃了在匮乏已知信息里强行推演全局,转而引入了一个专门的第二个神经网络,研究团队将其命名为「信念模型」。在 1.63 亿局的自对弈训练中,这个信念模型的核心任务,是根据对手已经走出的步法,去逆向猜测那些尚未暴露的棋子身份。
它通过采样筛选出当前局面下对手最有可能的几种阵型。把遍历所有可能摆法降维成在几个可信摆法里推演,直接重构了逻辑链路。有了信念模型,Ataraxos 终于能够把 AlphaGo 那个级别的树搜索(在真正落子前对未来可能的分支进行局部推演)引入到军棋中。
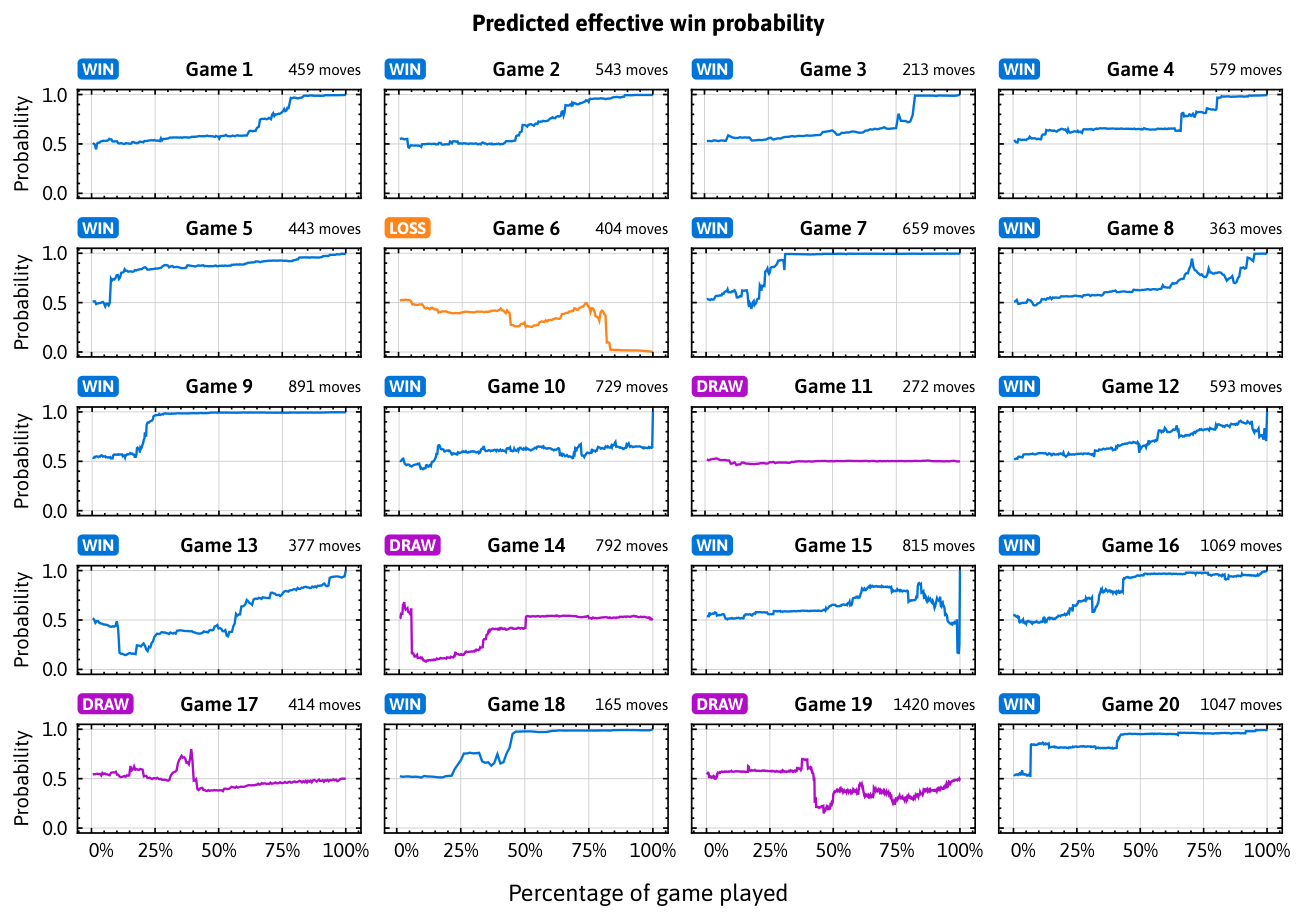 图:系统在对决 Pim Niemeijer 时的胜率预估变化。来源:论文 arXiv:2511.07312
当年受困于隐藏信息太多,前代系统根本无法在军棋里把搜索树建立起来,只能依赖直觉网络。Ataraxos 证明了,在信息残缺的场域里,先去猜透对手的底牌,把不可知的迷雾转化为高概率的近似已知,搜索算法的威力才能真正释放出来。这种重构甚至改变了游戏的传统战术。在与人类冠军的对战中,Ataraxos 经常采用一种少见的防御阵型:把最关键的军旗直接塞进棋盘角落,外围只用两颗炸弹进行死守。这种在人类世界里被认为死板、容错率低的摆法,在经过算力严格验证后,成为了效率最高的防御壁垒。
机器剥离了心理包袱
架构上的突破直接反映在了具体的博弈风格上。Ataraxos 展现出了一种让人类选手不适的特质:它剥离了情绪,也没有人类在劣势下的焦虑。研究者在复盘数据时发现,当人类玩家的实时胜率跌到 2% 这种绝境时,往往会选择孤注一掷,发起自杀式冲锋或者毫无章法的绝望诈唬。
但 Ataraxos 在同样劣势下,会像机器一样精密地寻找胜率上哪怕 0.1% 的回升机会,慢慢把局面磨平。研究者形容它能非常随意地诈唬着赢回来。对它而言,用弱子去骗对方的强子,不需要经历人类那种心跳加速的心理挣扎,这只是在当前置信区间下,期望收益最高的数学选择。
这种剥离了同理心的冰冷计算,还体现在它对自身破绽的处理上。如果在棋盘的某个区域,Ataraxos 留下了一个巨大的防守漏洞,而通过分析对手的走步,它判断对手并没有意识到这个漏洞。此时,即使从拥有全知视角(能同时看到双方底牌)的观察者看来,那里随时会遭遇毁灭性打击,Ataraxos 也会视若无睹,绝不去浪费棋子补漏。人类很难做到这一点,当你知道自己有一个秘密随时爆发时,你的防守动作、兵力调动甚至落子节奏,都会不自觉地流露出焦虑。机器没有这个包袱,它判断你不知道,它就直接当你不知道。
真实世界博弈从不发底牌
Ataraxos 验证成功的这套架构,并没有局限在军棋这一个盘子上。研究团队已经将同样的框架平行迁移,击败了 Barrage Stratego 的三位世界冠军,还成功掌握了高度依赖默契与暗牌推理的合作卡牌游戏 Hanabi,打赢了斗地主最强的人工智能。这套系统用极低的成本,在不同规则的暗牌池里杀穿了防御。
但这远不是终点。研究者正致力于让模型尝试用人类语言解释决策原因。他们长远的目标,是把这套处理不完全信息的方法论,推广到商业谈判、金融市场博弈等真实场景中。
军棋这一局说明的是路线之争。在信息大量隐藏、局面可以拖得很长的复杂问题里,先猜出对手隐藏信息再进行搜索的路线,用 8000 美元的成本赢了纯靠算力硬堆的暴力路线。当 AI 能够在 10 的 33 次方种迷雾中精准锁定人类冠军的底牌时,下一阶段的前沿竞争已经变了。不再是谁能买到更多最先进的加速卡,而是谁能更早洞察到问题的内在结构。
参考链接:
- Nature 论文:Scalable decision-making for games of imperfect information
- Ars Technica 报道
- Hacker News 讨论 (item?id=49933740)