2026年9月30日、学術誌『Nature』に、近年の巨大モデルによる計算資源偏重の風潮に一石を投じる論文が掲載された。カーネギーメロン大学やMITなどの研究チームが共同開発したAIシステム「Ataraxos」が、わずか16基のGPUと約8000ドルの学習コストで、ストラテゴ(Stratego)の世界王者に4度輝いたピム・ニーマイヤー(Pim Niemeijer)を15勝1敗4引き分けという圧倒的な戦績で打ち負かしたのである。4年前、業界トップの研究機関が1024基もの専用アクセラレータと数百万ドルの予算を投じて同じ砦の攻略に挑みながら、このゲーム最大の特徴である「ブラフ(ハタリ)」の壁に阻まれていた。
16基のGPUが覆した計算資源の覇権
これは先端AIの研究開発指針における劇的な方向転換と言える。ニーマイヤーとの対決において、Ataraxosは終始圧倒的な強さを見せつけた。ルールは明快で、AIに1勝するごとに、世界ランク1位の座を600週以上にわたって維持してきた同氏へ100ドルの賞金が支払われるというものだった。ニーマイヤーはAIが対戦中に動的な適応を行わないことを知っており、時間をかけてシステムの盲点を探ることができた。しかし、20局にわたる攻防の末、人類王者がもぎ取ることができたのはわずか1勝にとどまった。
研究チームは対戦結果について冷静なエンジニアリング的分析を行っている。唯一の敗戦と4つの引き分けは、ストラテゴのルール上不可避である「序盤のランダムなブラインド配置」に起因するところが大きい。わずか20局というサンプル数では、初期配置による運の要素を大数の法則で相殺しきれないためだ。一方、2025年のストラテゴ世界選手権の会場で行われた40局のエキシビションマッチでは、多種多様なプレイヤーの奇策に対峙しながら38勝を記録した。人類の頂点に勝利したこと自体も衝撃的だが、業界関係者の度肝を抜いたのは、その信じられないほど安価な計算資源の請求書だった。
 図:ストラテゴの複雑な盤面状態と隠匿された駒。出典:Getty Images(Ars Technica報道より)
Ataraxosが消費した計算リソースは驚くほど少ない。稼働させたのは16基のGPUを1週間、それに加えて「信念モデル」の学習に4基のGPUを4日間使っただけである。チームの試算によると、学習コストは8000ドル前後に収まる。これと対照的なのが、2022年にDeepMindが発表した先代システム「DeepNash」だ。DeepNashは1024基の専用チップを2〜3カ月稼働させており、2025年のハードウェア相場で換算すれば300万ドルから450万ドル規模のコストに達する。Ataraxosの自己対局数はDeepNashの約30分の1で済み、必要な学習サンプル数に至っては100分の1にまで圧縮された。投じられた計算資源には3桁もの開きがあるにもかかわらず、後発のシステムが一般的なGPUだけで完全な優位性を確立したのだ。力づくの計算資源拡大は収穫逓減の壁に突き当たり、ひたすら資金を燃やして全探索を行うアプローチの限界が露呈した。
10の33乗通りの初期配置が計算の力技を阻む
なぜ400万ドルもの巨費を投じてもストラテゴを完全攻略できなかったのか。その理由は、このゲーム固有の構造的な難しさに潜んでいる。チェスや将棋、囲碁のようにすべての情報が盤上に開示されている「完全情報ゲーム」とは異なり、ストラテゴは濃密な戦場の霧(フォグ・オブ・ウォー)に包まれた「不完全情報ゲーム」である。プレイヤー双方が40個ずつの駒を持ち、元帥からスパイまでの階級に加え、動けない爆弾、そして防衛必須の軍旗で構成される。ゲーム開始時、相手に見えるのは駒の配置場所だけであり、それぞれの正体は一切分からない。
駒の階級が審判によって明かされるのは、2つの駒が直接接触して戦闘が発生した瞬間だけである。階級の低い駒は盤上から取り除かれ、勝利した側の駒は生き残るが、同時にその正体が相手に完全に露呈する。この仕組みがもたらす状態空間の爆発は指数関数的だ。テキサスホールデムも不完全情報ゲームだが、プレイヤーが伏せて持つ手札は2枚だけであり、手牌の組み合わせは1326通りにすぎない。一方のストラテゴでは、開幕時の駒の配置パターンだけで10の33乗通りを超える。
さらに過酷なのがゲームの深さである。一般的なチェスの対局が約40手前後で決着するのに対し、ストラテゴの長期戦は容易に2000手を超える。この長大な相互作用の中で、強化学習がもっとも苦手とする変数が前面に出てくる。それが「ブラフ」だ。まったく戦闘力のない下級の駒を元帥に見せかけて前線へ進軍させる戦術は、極めて強力な心理的効果を持つ。ブラフを多用しすぎれば、相手に見破られて即座に撃破されるが、常に正直な手を指していれば、戦力配置を完全に見抜かれて局所的に制圧されてしまう。2000手という果てしない攻防の中で、本物の脅威と虚勢の均衡をいかに保ち続けるか。これこそがDeepMindの2022年版モデルが解き明かせなかった急所であった。天文学的な状態ツリーを前に、複数手におよぶ連続したブラフを処理しようとすれば、計算資源は瞬く間に枯渇してしまう。
霧の中で相手の伏せ札を特定する「信念モデル」
Ataraxosのアプローチは、問題の構造そのものを再設計することだった。不完全な情報環境の中で盤面全体を力任せに先読みすることを放棄し、専用の第2のニューラルネットワークを導入した。研究チームが「信念モデル(Belief Model)」と名づけた機構である。1億6300万局に及ぶ自己対戦訓練の中で、この信念モデルに課された中核的任務は、相手がこれまでに指した手の履歴から、未だ判明していない敵駒の正体を逆算して推論することだった。
信念モデルは、現在の盤面において相手が取っている可能性の高い配置をサンプリングによって絞り込む。考えられるすべての配置パターンを探索する代わりに、蓋然性の高い少数の配置候補に絞って先読みを行うことで、論理の連鎖を抜本的に再構成した。この信念モデルの確立によって、AtaraxosはAlphaGoと同等の高度な木探索(実際に駒を動かす前に将来の分岐展開を先読みする手法)を、ついにストラテゴの盤上へ持ち込むことに成功したのである。
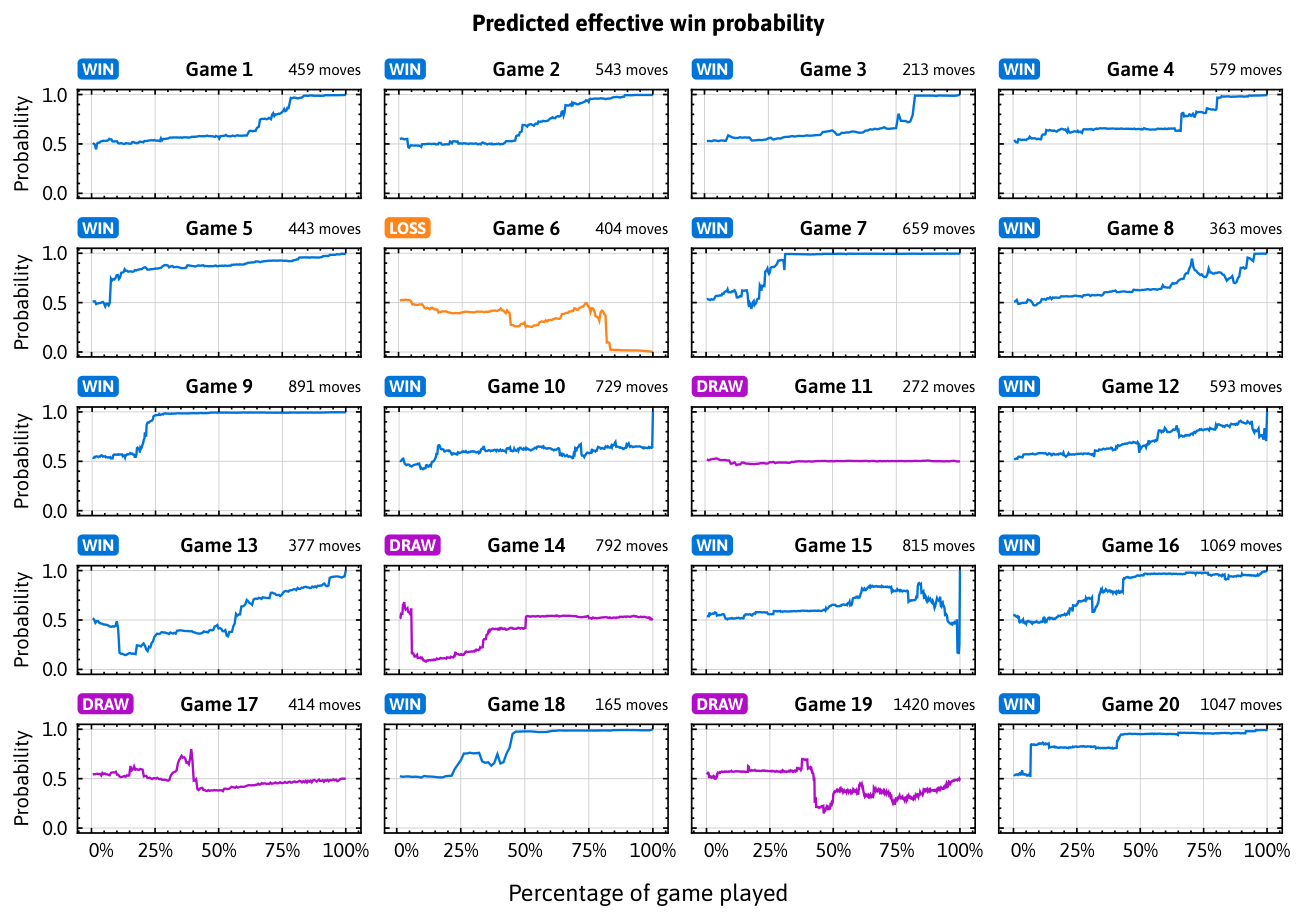 図:ピム・ニーマイヤーとの対戦時における勝率予測の推移。出典:論文 arXiv:2511.07312
かつてのシステムは、隠された情報が多すぎるために探索木を構築できず、モデルフリーな価値観直感に頼るほかなかった。Ataraxosが示したのは、情報が欠落した場においては、まず相手の手牌を推論し、未知の霧を高確率の近似情報へと変換して初めて、探索アルゴリズムの真価が発揮されるという事実である。このパラダイムシフトは、ゲームの伝統的な戦術常識すら塗り替えた。ニーマイヤーとの対戦において、Ataraxosはきわめて珍しい防御陣形を頻繁に用いた。最重要の軍旗を盤面の最奥の隅に配置し、その周囲をわずか2つの爆弾だけで固める配置である。人間界では「融通が利かず、ミスの許されない悪手」と見なされていたこの陣形が、計算による厳密な検証を経て、もっとも効率的な防壁であることが実証されたのだ。
心理的重圧から完全に解放された機械の冷徹さ
アーキテクチャの革新は、具体的な指し手のスタイルにも色濃く反映された。Ataraxosが見せたのは、人間の対局者を狼狽させる独特の振る舞いである。そこには感情の揺らぎがなく、劣勢に立たされた際の人間の焦りも存在しない。研究者が対局ログを検証したところ、人間のプレイヤーはリアルタイムの推定勝率が2%前後の絶体絶命の危機に陥ると、自暴自棄な突撃や無謀なブラフといった一か八かの博打に出がちであることが分かった。
しかし、まったく同じ窮地に立たされたAtaraxosは、精密機械のように探索を行い、勝率がわずか0.1%でも上向く分岐を淡々と探し出し、数時間をかけて形勢を五分に引き戻していった。研究者は、AIが不気味なほどの平然さでブラフを仕掛けて逆転していく様子を記録している。機械にとって、弱い駒で相手の強力な駒を欺く行為に動悸や心理的葛藤は伴わない。それは現在の確率分布において、もっとも期待値の高い数学的選択にすぎないからだ。
この感情を排した冷徹な計算は、自らの弱点の扱い方にも現れている。もし盤上の一角に致命的な守りの隙が生じていたとしても、相手の手順を分析した結果「相手はその隙に気づいていない」と判断した場合、Ataraxosはその弱点を塞ぐために駒を一切割かない。双方の配置をすべて見通せる観戦者の視点からは、いつ壊滅的な打撃を受けてもおかしくない危うい場面に見えても、AIは平然と放置する。人間には到底真似のできない芸当だ。重大な弱点を抱えていると自覚している人間は、駒の動かし方や着手のテンポに無意識の動揺が滲み出てしまう。だが機械にそんな心理的負荷はない。「相手が気づいていない」と判定したなら、何事もないものとして盤面を進めるだけだ。
現実世界のゲームに「手牌の公開」はない
Ataraxosが実証したアーキテクチャは、ストラテゴ単体にとどまるものではない。研究チームはすでに同様のフレームワークを水平展開し、バラージュ・ストラテゴ(Barrage Stratego)で3人の世界王者を撃破したほか、プレイヤー間の意思疎通と手札推論が鍵を握る協力型カードゲーム「花火(Hanabi)」を攻略し、闘地主(Dou Dizhu)でも最高峰のAIを打ち負かしている。極めて低廉なコストで設計されたこのシステムは、ルールの異なる多様な不完全情報環境を次々と制圧していった。
しかし、ボードゲームやカードゲームの制覇は通過点にすぎない。研究チームは現在、AIが自身の意思決定の根拠を自然言語で説明できるようにする取り組みを進めている。最終的な目標は、この不完全情報処理のフレームワークを、企業間のビジネス交渉や金融市場での取引戦略といった現実世界の複雑な意思決定シナリオへ応用することだ。
ストラテゴにおける勝利が突きつけたのは、AI開発における根本的なアプローチの転換である。大量の隠れ情報を含み、膨大な手数に及ぶ複雑な問題において、「まず相手の隠れ情報を推論し、その上で探索を行う」という設計は、8000ドルのコストで数百万ドル級の力技アプローチを凌駕した。10の33乗通りの霧の中から人間の王者の伏せ札を正確に見抜けるようになった今、最先端の競争軸は塗り替えられた。もはや誰がより多くの最新アクセラレータを買い占めるかではなく、誰が問題の本質的な構造を見抜けるかの勝負が始まっている。
参考リンク:
- Nature 論文:Scalable decision-making for games of imperfect information
- Ars Technica 報道
- Hacker News ディスカッション (item?id=49933740)