Le 30 septembre 2026, la revue Nature a publié un article venu bousculer avec fracas le culte de la puissance de calcul brute. Un système nommé Ataraxos, développé conjointement par des chercheurs de l’université Carnegie Mellon, du MIT et d’autres institutions partenaires, a terrassé le quadruple champion du monde de Stratego Pim Niemeijer sur le score sans appel de 15 victoires, 1 défaite et 4 nuls. Pour accomplir cet exploit, l’équipe n’a mobilisé qu’un modeste parc de 16 GPU et un budget d’entraînement estimé à environ 8 000 dollars. Quatre ans plus tôt, les laboratoires les plus prestigieux de l’industrie déployaient 1 024 puces accélératrices dédiées et des millions de dollars pour assiéger la même forteresse, sans parvenir à maîtriser l’art subtil du bluff.
16 GPU renversent le dogme de la puissance brute
Il s’agit d’un réalignement stratégique majeur pour la recherche en IA de pointe. Face à Pim Niemeijer, Ataraxos a fait preuve d’une écrasante supériorité. Le cadre de la confrontation était limpide : pour chaque partie remportée, l’équipe versait 100 dollars au grand maître, qui régnait sur la première place mondiale depuis plus de 600 semaines. Niemeijer savait que l’IA ne s’adapterait pas dynamiquement d’une partie à l’autre, ce qui lui laissait tout le loisir d’explorer patiemment d’éventuelles failles logicielles. Pourtant, au terme de 20 manches sous haute pression, le champion humain n’a pu décrocher qu’une seule et unique victoire.
L’équipe de recherche a posé un diagnostic d’ingénierie sans fard : la seule défaite et les quatre nuls découlent pour l’essentiel de la disposition initiale à l’aveugle, obligatoire à Stratego, où les caprices du hasard ne peuvent être lissés par la loi des grands nombres sur un échantillon d’une vingtaine de parties. En revanche, lors d’une session de 40 parties disputées en direct aux Championnats du monde de Stratego 2025 face à divers compétiteurs aux stratégies déroutantes, Ataraxos s’est imposé 38 fois. Faire plier l’élite mondiale est déjà spectaculaire en soi, mais ce qui a véritablement ébranlé l’industrie, c’est la dérision de la facture matérielle.
 Figure : La complexité du plateau de Stratego et ses pièces masquées. Source : Getty Images (via Ars Technica)
L’empreinte computationnelle d’Ataraxos défie les ordres de grandeur habituels : 16 GPU sollicités pendant une semaine, complétés par 4 GPU pendant quatre jours pour entraîner le « modèle de croyance » (Belief Model). Les auteurs évaluent le coût d’entraînement global aux alentours de 8 000 dollars. En miroir, DeepNash, le précurseur dévoilé par DeepMind en 2022, avait mobilisé 1 024 processeurs spécialisés pendant deux à trois mois, soit une facture estimée entre 3 et 4,5 millions de dollars aux prix du matériel de 2025. Ataraxos n’a requis qu’un trentième du volume d’auto-jeu de DeepNash et a comprimé la taille de l’échantillon d’apprentissage à 1 %. Trois ordres de grandeur séparent les deux approches en matière d’infrastructures, mais le nouveau venu a établi une domination totale avec des cartes graphiques courantes. L’empilement frénétique de silicium se heurte au mur des rendements décroissants ; la méthode consistant à brûler du capital pour tout résoudre par recherche exhaustive a trouvé sa limite.
10 puissance 33 configurations initiales paralysent la recherche exhaustive
Pour comprendre pourquoi des millions de dollars se sont enlisés devant Stratego, il faut analyser l’architecture même de ce jeu. Contrairement aux échecs ou au go, jeux à information parfaite où chaque pion est visible de part et d’autre, Stratego est un jeu à information imparfaite plongé dans un épais brouillard de guerre. Chaque joueur dispose de 40 pièces — du Maréchal jusqu’à l’Espion, en passant par des bombes immobiles et le Drapeau qu’il faut sanctuariser à tout prix. Dès l’ouverture, on ne voit que l’emplacement des unités adverses, sans connaître leur identité réelle.
Ce n’est que lorsqu’une collision survient sur une case que l’arbitre dévoile les grades respectifs. L’unité la plus faible est retirée du plateau, tandis que la gagnante survit, révélant par là même son identité stratégique à l’ensemble du champ de bataille. Cette mécanique engendre une explosion combinatoire vertigineuse de l’espace d’états. Si le Texas Hold’em appartient aussi à la famille des jeux à information imparfaite, chaque joueur n’y manipule que deux cartes privées, représentant 1 326 combinaisons de départ. À Stratego, le nombre de dispositions initiales possibles dépasse l’effarant chiffre de 10 puissance 33.
Plus redoutable encore est la profondeur de l’arbre de décision. Si une partie d’échecs se dénoue généralement en une quarantaine de coups, une confrontation serrée à Stratego franchit aisément le cap des 2 000 tours. Sur une telle échelle d’interaction, une variable piège pour l’apprentissage par renforcement traditionnel s’invite au centre de l’échiquier : le bluff. Avancer une pièce subalterne sans valeur offensive en la faisant passer pour un Maréchal constitue un levier tactique dévastateur. Mais si vous abusez du bluff, votre adversaire évente l’imposture et capture votre pion ; si vous jouez avec une honnêteté absolue, il déchiffre la cartographie de vos forces et vous asphyxie localement. Maintenir un équilibre de théorie des jeux entre menaces authentiques et faux-semblants sur 2 000 coups consécutifs, tel était l’angle mort que le modèle 2022 de DeepMind n’avait su résoudre. Face à un arbre de jeu aussi colossal, les algorithmes conventionnels voyaient leur puissance de calcul s’évaporer dès qu’il s’agissait de calculer des cascades de bluffs sur plusieurs tours.
Un modèle de croyance pour dissiper le brouillard de guerre
Ataraxos a contourné l’obstacle en reformulant la structure même du problème. Plutôt que de prétendre calculer l’avenir à l’aveugle au milieu d’un vide informationnel, les chercheurs ont introduit un second réseau de neurones dédié : le « modèle de croyance » (Belief Model). Au fil de 163 millions de parties en auto-jeu, la mission cruciale de ce réseau consistait à inférer rétrospectivement l’identité des pièces adverses encore dissimulées, en analysant la dynamique des coups déjà joués.
Par échantillonnage statistique, ce modèle filtre et isole les quelques dispositions ennemies les plus probables à chaque instant. Transformer une quête exhaustive en une projection ciblée sur un faisceau d’hypothèses crédibles a permis de refonder l’arbre décisionnel. Fort de ce modèle de croyance, Ataraxos a enfin pu déployer à Stratego la recherche arborescente de Monte-Carlo façon AlphaGo — celle qui simule des arborescences de coups futurs avant d’engager le moindre mouvement.
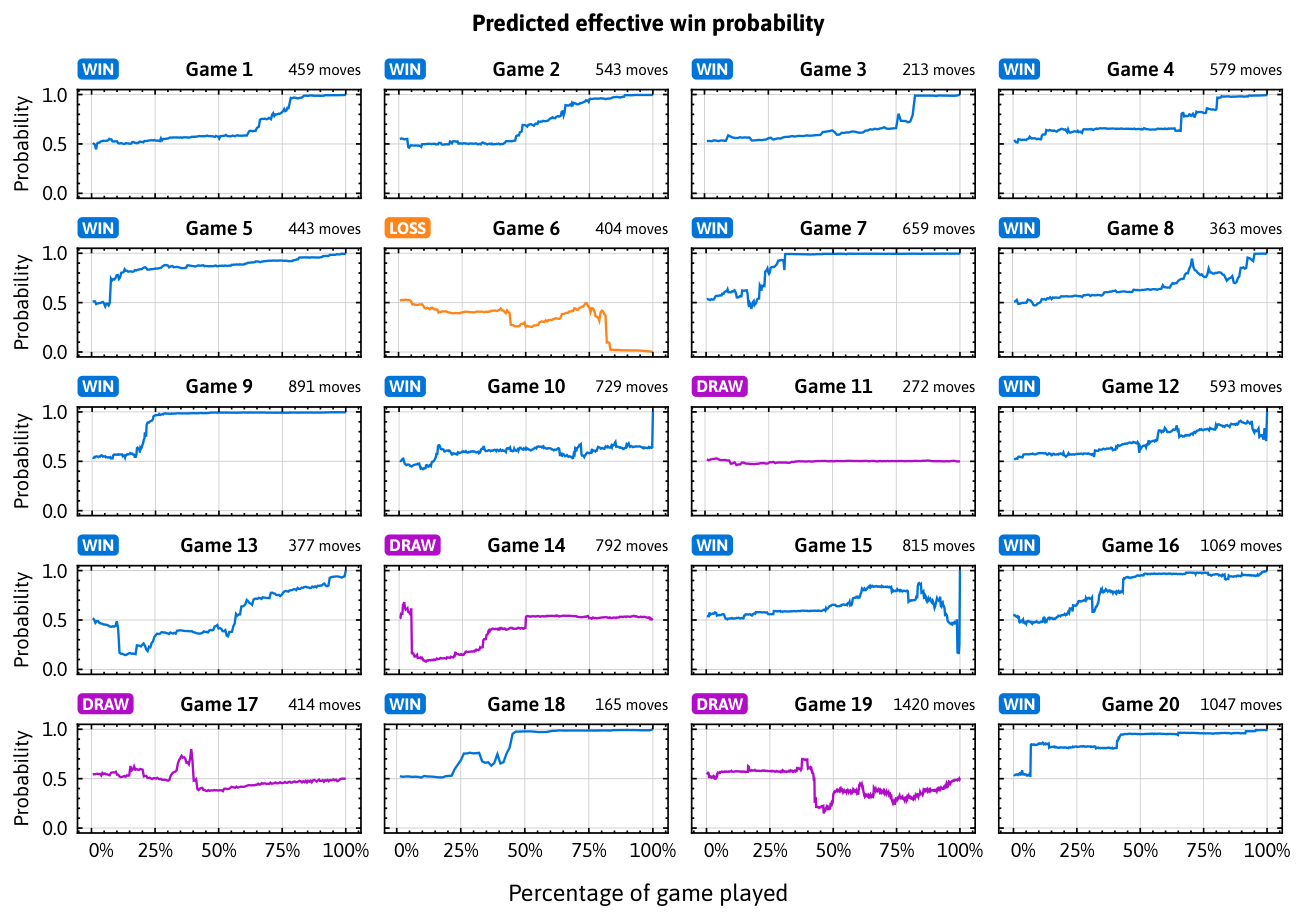 Figure : Évolution des probabilités de victoire estimées face à Pim Niemeijer. Source : arXiv:2511.07312
Jadis entravés par l’incertitude des états masqués, les modèles précédents ne parvenaient pas à ériger d’arbres de recherche viables et devaient s’en remettre à des intuitions de valeur sans modèle. Ataraxos a prouvé que dans un univers d’information incomplète, percer d’abord le jeu caché de l’adversaire — pour convertir le brouillard en approximations hautement fiables — constitue le prérequis absolu pour libérer la puissance des algorithmes de recherche. Ce basculement méthodologique a même bouleversé les dogmes tactiques séculaires. Face à Niemeijer, Ataraxos a fréquemment recouru à une disposition défensive singulière : placer le Drapeau dans le coin le plus retranché du plateau, cadenassé par seulement deux bombes. Jugée rigide et impardonnable à la moindre erreur par les maîtres humains, cette configuration s’est révélée, après validation algorithmique rigoureuse, être le rempart défensif le plus robuste du jeu.
Une mécanique dépouillée de toute psychologie humaine
Cette rupture d’architecture s’est traduite sur le terrain par un style de jeu déstabilisant pour ses rivaux humains. Ataraxos a affiché une impassibilité absolue, exempte d’émotions et de la panique qui étreint l’être humain lorsqu’il est acculé. En disséquant les données de jeu, les chercheurs ont constaté que lorsqu’un joueur humain voit ses chances de gain s’effondrer en temps réel autour de 2 %, il se résout presque invariablement à des offensives suicides ou à des bluffs inconsidérés.
Ataraxos, confronté au même gouffre, explorait avec une rigueur de métronome les branches offrant ne serait-ce qu’un regain de 0,1 % d’espérance, rétablissant patiemment l’équilibre coup après coup. Les chercheurs ont relevé avec quelle décontraction déconcertante le système bluffait pour remonter la pente. Tromper l’ennemi en brandissant un pion mineur ne déclenche chez la machine ni palpitations ni cas de conscience ; c’est simplement le choix mathématique maximisant l’espérance de gain dans l’espace probabiliste actuel.
Cette neutralité chirurgicale s’est également illustrée dans la gestion de ses propres failles. Si une béance défensive critique apparaissait sur un flanc, mais que le modèle de croyance déduisait des mouvements adverses que l’autre joueur ne l’avait pas remarquée, Ataraxos refusait de gaspiller la moindre ressource pour la combler. Alors qu’un observateur omniscient voyant l’ensemble des cartes redoutait une catastrophe imminente, Ataraxos demeurait imperturbable. Les joueurs humains sont rarement capables d’un tel détachement : la conscience d’un secret vulnérable contamine fatalement le tempo, les hésitations et les replis défensifs hâtifs. La machine ne porte pas ce fardeau : dès lors qu’elle évalue que vous l’ignorez, elle agit comme si la menace n’existait pas.
Dans le monde réel, les cartes ne sont jamais abattues
L’architecture validée par Ataraxos dépasse largement le cadre strict de Stratego. L’équipe a déjà transposé son modèle avec succès pour défaire trois champions du monde de Barrage Stratego, maîtriser le jeu de cartes coopératif Hanabi (qui repose entièrement sur la déduction mutuelle de cartes invisibles pour soi-même) et surclasser la meilleure IA existante au Dou Dizhu. À une fraction dérisoire des coûts historiques, le système a percé les défenses d’environnements à cartes cachées régis par des règles radicalement divergentes.
Mais les jeux de plateau ne sont qu’un banc d’essai. Les chercheurs s’attachent désormais à doter le système de la capacité d’expliciter ses raisonnements stratégiques en langage naturel. Leur dessein à long terme est d’exporter cette méthode de traitement de l’information imparfaite vers des théâtres réels tels que les négociations commerciales, la logistique stratégique et les arbitrages sur les marchés financiers.
La victoire acquise à Stratego tranche un débat fondamental sur l’orientation de l’intelligence artificielle. Face à des problèmes complexes combinant horizons lointains et informations masquées, le parti pris de déduire la réalité invisible avant d’enclencher la recherche l’a emporté sur la course aux armements de silicium, pour seulement 8 000 dollars. Quand une IA sait repérer la main d’un champion du monde au milieu de 10 puissance 33 configurations de brouillard, la donne technologique change. La victoire n’appartiendra plus à ceux qui empilent les cartes accélératrices, mais à ceux qui sauront déchiffrer la géométrie profonde du problème.
Liens de référence :
- Article Nature : Scalable decision-making for games of imperfect information
- Couverture par Ars Technica
- Discussion Hacker News (item?id=49933740)