Ein 284B MoE auf einem 128-GB-Notebook
DwarfStar 4 (ds4), eine vom Redis-Schöpfer Salvatore Sanfilippo entwickelte C-Inferenz-Engine, verschiebt die Einstiegshürde für den lokalen Betrieb von Spitzenmodellen grundlegend: Entscheidend ist nicht mehr, ob man sich teure Beschleunigerkarten leisten kann, sondern ob der Arbeitsspeicher groß genug ist. DeepSeek V4 Flash, ein gigantisches Mixture-of-Experts-Modell (MoE) mit 284 Milliarden Parametern, verlangt im nativen Zustand nach enormen Mengen an Videospeicher (VRAM). Für herkömmliche Consumer-Hardware war ein Modell dieser Größenordnung bisher schlicht unerreichbar.
ds4 setzt auf asymmetrische 2-Bit-Quantisierung, bei der gezielt geroutete Experten komprimiert werden. Dadurch wird peripheres Gedächtnis reduziert, während die zentrale Rechenfähigkeit unangetastet bleibt. Die Anwendung dieser Quantisierung auf zig Milliarden Parameter gerouteter Experten beweist, dass eine Kompression entlang kritischer Pfade keineswegs mit einem logischen Intelligenzverlust gleichzusetzen ist. Indem ds4 ein 284B MoE auf ein handelsübliches 128-GB-Gerät zwingt, ebnet dieser Entwurf – Speicherkapazität gegen Durchsatz einzutauschen – den Weg von spezialisierten Rechenzentren direkt auf den Desktop.
Im High-End-Bereich erreicht ein Mac Studio mit 512 GB ein Durchsatzprofil von 150 t/s beim Prefill und 10–13 t/s bei der Dekodierung von V4 PRO. Diese Kombination reicht bereits aus, um rechenintensive Codebase-Analysen zuverlässig zu bewältigen. Die Anschaffung einer kompletten Workstation für rund 12.000 US-Dollar als einmalige Investition bildet die wirtschaftliche Basis, um Großmodelle aus der Cloud in die lokale Entwicklungsumgebung zurückzuholen. Dieses Hardware-Modell befreit Teams von den unkalkulierbaren Kosten tokenbasierter Cloud-Abrechnungen.
790 t/s Prefill enthüllt den wahren Flaschenhals
Auf einem M5 Max mit 128 GB Unified Memory erzielte ds4 bei einem Kontext von 2048 Tokens einen Prefill-Durchsatz von 790,2 t/s, was die Wartezeit bis zum ersten Token drastisch verkürzt. Auf derselben Maschine lag die Generierungsrate jedoch bei 39,4 t/s – ein Beleg dafür, dass Architekturen mit Unified Memory in speicherbandbreitenintensiven Phasen weiterhin durch physikalische Bandbreitenlimits ausgebremst werden. Diese markante Leistungsdiskrepanz zwischen den Inferenzphasen erzwingt Strategien, die Stärken gezielt auszuspielen und Schwächen zu umschiffen.
Ein direkter Vergleich zwischen dem M5 Max und dem DGX Spark macht die architektonischen Schwerpunkte deutlich. Gegenüber den 825,8 / 18,1 t/s des DGX Spark behält die Serverplattform zwar bei der reinen Prefill-Rechenleistung die Oberhand, doch bei der Generierung kann sie sich kaum absetzen. Unter langen Kontexten wird die Belastungsprobe noch deutlicher: Bei 65.536 Tokens hält der M5 Max stabile 398,5 / 27,6 t/s. Dass die Prefill-Werte derart robust bleiben, zeigt, dass das Anwachsen des KV-Caches die Pipeline nicht zum Erliegen bringt.
Dass die Prefill-Rate bei langen Kontexten kaum einbricht, während sich die Generierungsgeschwindigkeit halbiert, prägt das Design von Coding-Agenten grundlegend. Orchestrierungsschichten müssen lange, kontinuierliche Ausgabeströme vermeiden und stattdessen auf hochfrequente Eingaben und kurze Interaktionszyklen setzen. Die physikalischen Gegebenheiten der Hardware zwingen das Software-Ökosystem zu leichtgewichtigen Interaktionsmustern, die auf schnellem Kontext-Neuladen basieren.
SSD-Streaming, wenn der Arbeitsspeicher knapp wird
Erschöpft sich die Speicherkapazität, ist das gewaltsame Hineinpressen des gesamten Modells in das physische RAM nicht der einzige Ausweg. ds4 liefert eine pragmatische Systemlösung: Die Auslagerung des KV-Caches auf die Festplatte kombiniert mit dem Streaming von Modellgewichten über NVMe-SSDs. Übersteigen die Parameter das verfügbare RAM, lagert das System inaktive Expertengewichte auf der SSD aus und lädt sie bedarfsgesteuert nach. Die Mikrosekunden-Latenzen moderner NVMe-SSDs schaffen dafür das verlässliche Hardware-Fundament.
Der festplattenbasierte KV-Cache unterstützt eine Wiederherstellung anhand von Prompt-Hashes, sodass nach einem Neustart kein erneutes Prefilling erforderlich ist. Nach einem Absturz oder Neustart lässt sich der zwischengespeicherte Zustand unmittelbar von der SSD laden, was langwierige Doppelberechnungen von Eingabedaten überflüssig macht. Solche Low-Level-Details wiegen für die Praxistauglichkeit unter Ressourcenbeschränkungen oft schwerer als die bloße Wahl des Modells.
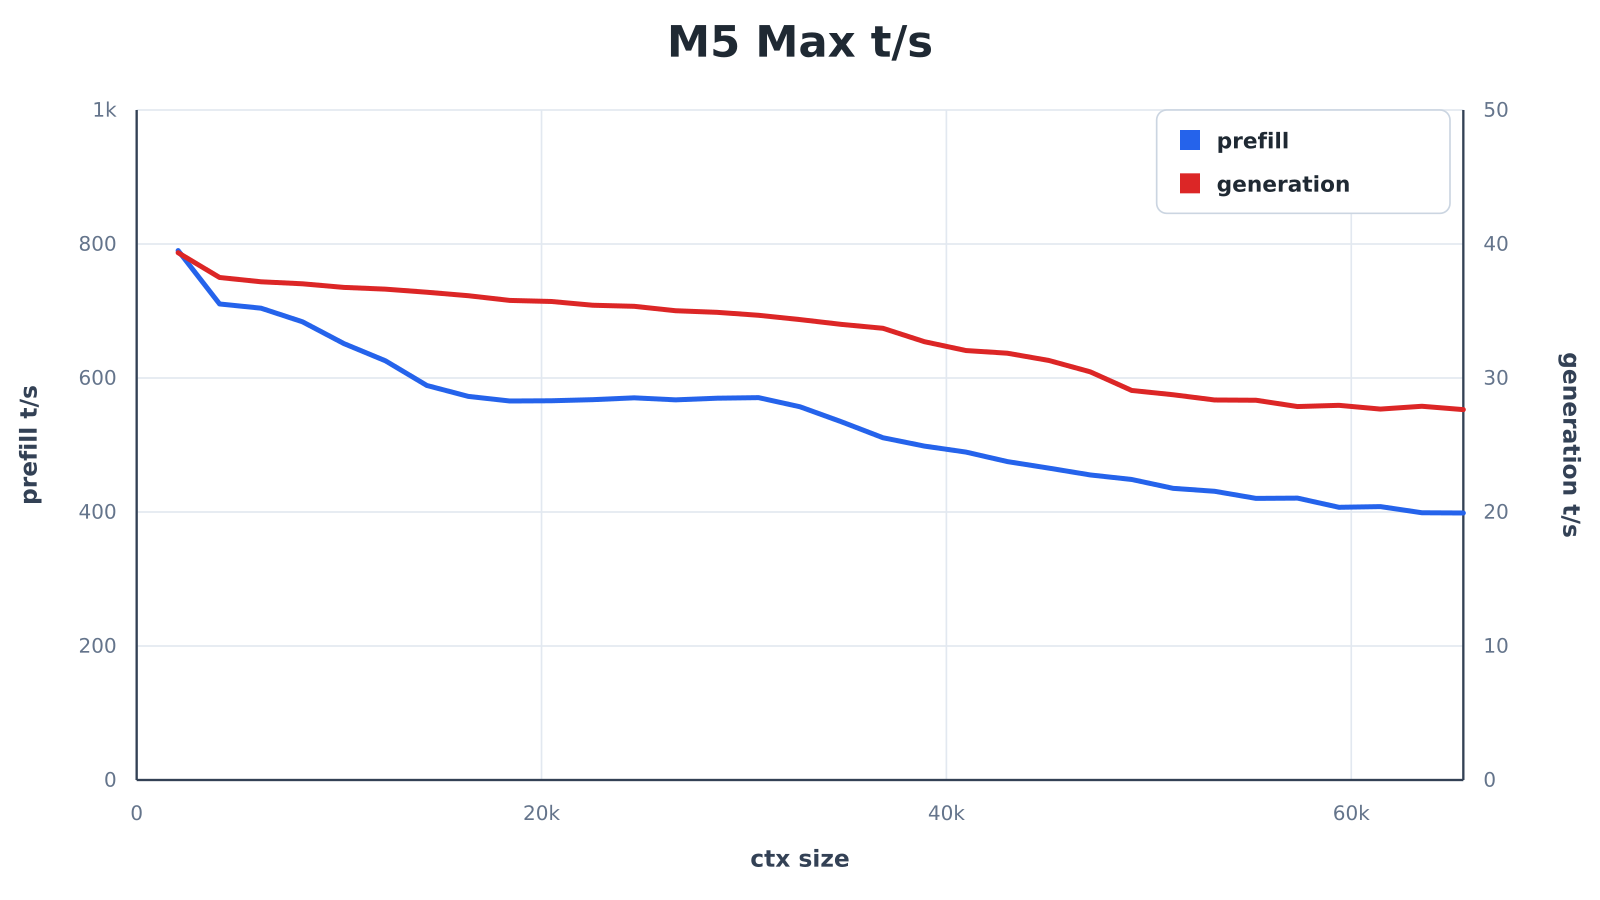 Abb.: Prefill- und Generierungsdurchsatzkurven auf dem M5 Max aus dem ds4-Repository speed-bench. Quelle: antirez/ds4 Repository speed-bench/m5_max_ts.svg
Für native Coding-Agenten erfolgt die Inferenzsteuerung präzise innerhalb eines dedizierten Prozesses. Netzwerklatenzen und Serialisierungsverluste herkömmlicher Cloud-APIs entfallen vollständig. Den schnellen NVMe-Speicher als direkte physikalische Speichererweiterung zu begreifen, bricht mit den starren Konventionen bisheriger LLM-Laufzeitumgebungen.
Zwei 128-GB-Maschinen per RDMA zusammenschalten
Die physikalischen Grenzen einzelner Rechner lassen sich über verteilte Netzwerke horizontal erweitern. ds4 unterstützt Tensor-Parallelität über mehrere Knoten hinweg via Apple RDMA und bildet so einen heterogenen, geräteübergreifenden Speicherpool. Dieser Kommunikationsmechanismus umgeht Systemaufrufe klassischer Netzwerkstacks und senkt die Übertragungslatenz beim Tensorslicing in praxisgerechte Bereiche.
Im Cluster-Betrieb liefert ein Verbund aus 8× L40S-Karten einen aggregierten Generierungsdurchsatz von 126 t/s – genügend Rechenleistung, um parallele Anfragen eines kleineren Entwicklerteams zuverlässig abzufedern. Ältere Beschleunigerkarten, die von offiziellen Frameworks neuerer Modelle nicht mehr priorisiert werden, erhalten so als Rechenknoten ein zweites Leben. Über Multi-User-Inferenzserver wird ihr Restwert maximal ausgeschöpft. Die Grundlage dieser Zusammenarbeit liegt in der präzisen Aufteilung und Neuzusammensetzung von Speicher und Rechenleistung.
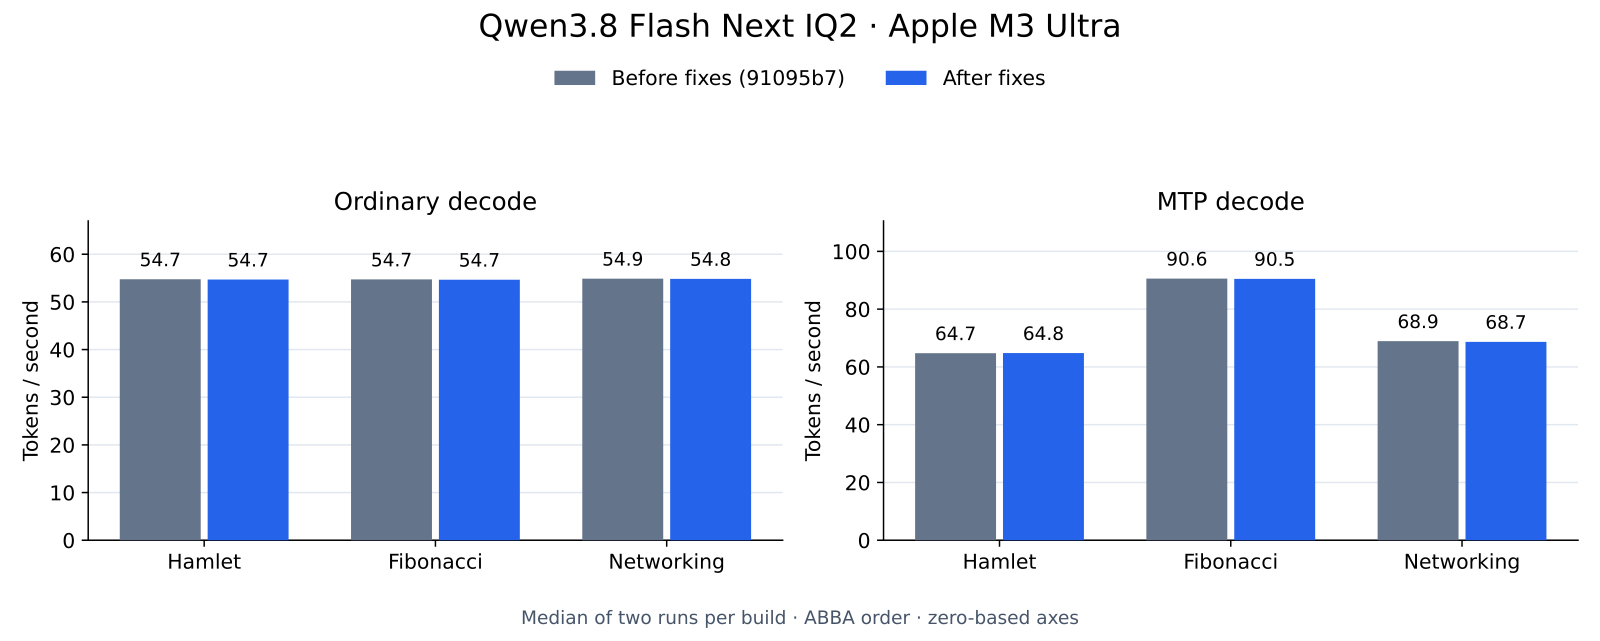 Abb.: Vergleich des Generierungsdurchsatzes verschiedener Qwen3.8-Checkpoints aus dem ds4-Repository speed-bench. Quelle: antirez/ds4 Repository speed-bench/qwen38-checkpoints/generation-throughput.svg
Der Durchsatzgewinn bei parallelen Nutzeranfragen tauscht im Wesentlichen die Latenz einzelner Anfragen gegen eine maximale Auslastung der Busbandbreite ein. Ob Tensor-Slicing oder Pipeline-Parallelität: Das Ziel bleibt, die Grenzen jedes Siliziumchips voll auszureizen. Das verschafft ausgemusterten Beschleunigern abseits gigantischer Hyperscaler-Cluster ein tragfähiges neues Einsatzfeld.
Eine fokussierte Implementierung jenseits generischer Ökosysteme
ds4 verzichtet bewusst darauf, ein universeller GGUF-Runner zu sein, und unterstützt ausschließlich ein eigenes, minimalistisches GGUF-Layout. Diese fokussierte Umsetzung eliminiert den Steuerungs-Overhead für divergente Quantisierungsformate und reserviert den knappen On-Chip-Cache für elementare Rechenbefehle. Dass im Repository auf Releasetags verzichtet wird, unterstreicht den Charakter als schnell iterierende Forschungs- und Validierungsplattform.
Die Entwicklungsprotokolle des Projekts dokumentieren offen, dass KI-Coding-Agenten maßgeblich an der Entstehung beteiligt waren. Die KI-Assistenten griffen direkt in das Refactoring ihrer eigenen Inferenz-Engine ein und verkürzten die hardwarespezifischen Optimierungszyklen erheblich. Dank der MIT-Lizenz lässt sich diese minimalistische Implementierung reibungslos in proprietäre kommerzielle Systeme einbetten.
Der Preis dieser Spezialisierung ist jedoch unübersehbar: Die Lebensdauer des Stacks hängt direkt an den wenigen Frontier-Modellen, deren Gewichte dauerhaft offenbleiben. Sollten führende Labore ihre Lizenzpolitik für Open Weights verschärfen, versiegen die Vorteile dieser tiefen Systemoptimierung schlagartig. Während ds4 Spitzenleistungen aus gezielter Hardware herausholt, bleibt seine technologische Relevanz auf den kontinuierlichen Nachschub aus dem offenen Ökosystem angewiesen.
Dieser Verzicht auf Allgemeingültigkeit zugunsten maximaler Effizienz definiert die Zugangsbarrieren für Spitzenmodelle neu. Er beweist: Wer bereit ist, Abstraktionsebenen auf gezielter Hardware konsequent abzustreifen, stößt bei der lokalen Inferenz nicht mehr an die Rechenleistung von Beschleunigerkarten, sondern an die Kapazitätsgrenzen von Speicher und SSD. Die Fähigkeit, extrem große Modelle lokal auszuführen, ist auf dem Desktop angekommen – beschränkt nur noch durch das physische Speicherlimit des eigenen Rechners.
Referenzlinks:
- HN-Diskussionsprotokoll
- Offizieller Benchmark-Bericht von antirez