284B MoE 塞进 128GB 笔记本
Redis 作者 Salvatore Sanfilippo 写的 C 推理引擎 DwarfStar 4(ds4),把前沿模型跑在本地的门槛从买不买得起加速卡,换成了装不装得下内存。DeepSeek V4 Flash 作为一个 284B MoE 级别的庞然大物,其原生状态需要极高的显存支持。常规消费级设备根本无法直接触及这种量级的参数体积。
ds4 采用非对称 2-bit 量化技术,单压路由专家的做法舍弃了边缘记忆但保全了核心计算能力。将百亿级路由专家施加这种量化,证明了在保留关键路径前提下压缩并不等同于逻辑降智。它把 284B MoE 强行压进 128GB 的消费级机器,这种内存置换算力的设计直接将推理门槛从专业机房拉平到桌面端。
在高端设备端,使用 Mac Studio 512GB 跑 V4 PRO 150 t/s 预填充与 10–13 t/s 解码,这种吞吐组合已经能支撑起复杂代码库的重度分析任务。把算力底座当成约 12k 美元整机的一次性采购,是把大模型从云端拉回本地开发环境的财务基准线。这种硬件投入模式免去了按量计费的不可控成本焦虑。
预填充 790 t/s 揭示真实瓶颈
M5 Max 128GB 在 2048 token 上下文下测出 790.2 t/s 预填充,这种庞大的输入吞吐直接降低了任务的首字等待时间。在同一设备上测出的 39.4 t/s 生成,则暴露出统一内存架构在访存密集阶段依然受限于物理带宽天花板。这种明显的阶段性能差异,决定了终端推理必须扬长避短。
把 M5 Max 与 DGX Spark 两列数字并排读,硬件侧重点一目了然。对比测出的 DGX Spark 825.8 / 18.1 数据,服务器平台在预填充算力上占据上风但生成阶段并未拉开差距。长上下文场景更显严苛,M5 Max 在 65,536 上下文下 398.5 / 27.6,预填充指标坚挺说明 KV 缓存增长并未拖垮流水线。
长上下文下预填充几乎不掉而生成腰斩,这直接定义了编码 agent 的工作流模式。它要求上层调度减少漫长的连续输出,转而依靠高频输入和短轮交互来完成调试任务。这种硬件层面的物理特征,倒逼着软件生态走向基于上下文重载的轻量化交互。
内存放不下就走 SSD 流式加载
内存容量见底时,强制把模型塞进物理内存并不是唯一出路。ds4 给出的核心工程解法是 KV 缓存写入磁盘和 SSD 权重流式加载。当模型参数超越内存极限时系统会将非活跃权重置于 SSD 中,按需拉取有效填补了容量短板。现代固态硬盘的微秒级延迟为流式加载铺平了底层硬件道路。
KV 缓存写入磁盘支持按 prompt hash 恢复,重启不必重新预填充。每次崩溃后直接从磁盘加载命中状态,消除了重复计算前置内容的漫长等待过程。这些底层工程细节比单纯的模型选型更能决定系统在资源受限条件下的可用性。
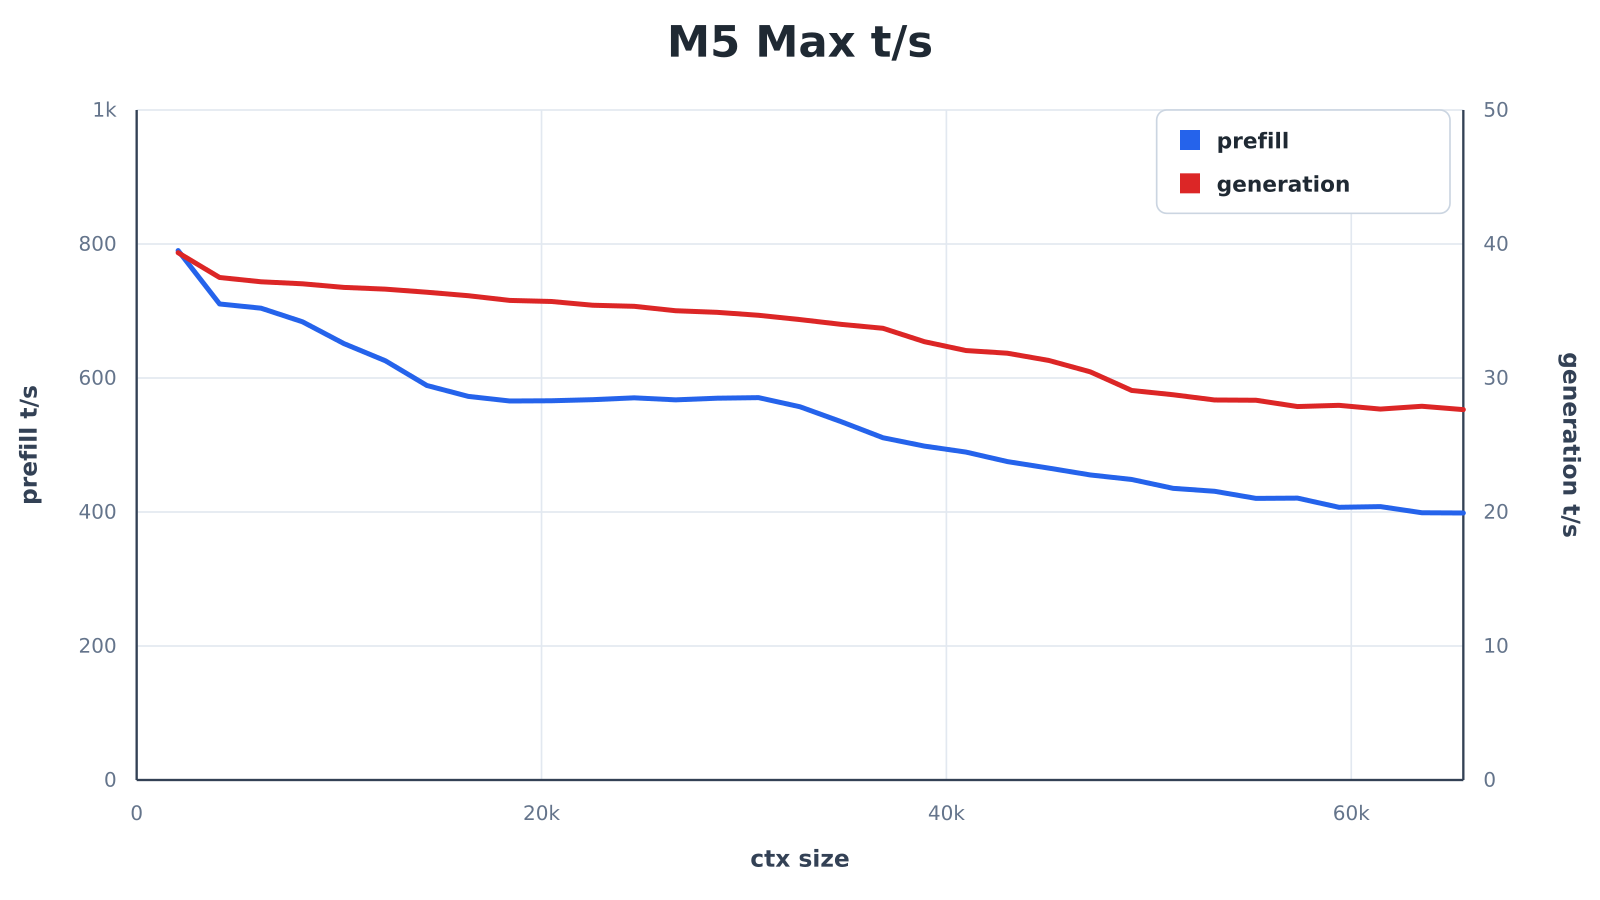 图:ds4 仓库 speed-bench 中 M5 Max 上的预填充/生成吞吐曲线。来源:antirez/ds4 仓库 speed-bench/m5_max_ts.svg
对于原生编码 agent 而言,推理过程直接在独立进程内完成精细控制。传统 API 调用的网络开销与序列化损耗被这种架构干净地剔除。把存储层直接当成内存的物理延伸,打破了传统架构对大模型推理的死板约束。
两台 128GB 机器用 RDMA 拼成一台
单机硬件的物理极限可以通过分布式网络进行水平拓展。ds4 支持多台机器之间用 Apple RDMA 做张量并行,直接打通了跨设备的异构显存池。这种通信机制跳过了常规网络栈的内核系统调用损耗,让张量切片的交互延迟降至可用范围。
集群路线上,配置 8 张 L40S 126 t/s 聚合生成,这种吞吐能力足以支撑起一个小型开发团队的日常并发请求。被新模型官方后端淘汰的老卡重新变成算力,通过多用户推理服务器机制完成了剩余价值的二次压榨。跨设备协同的核心在于对显存和算力的精准切割与重组。
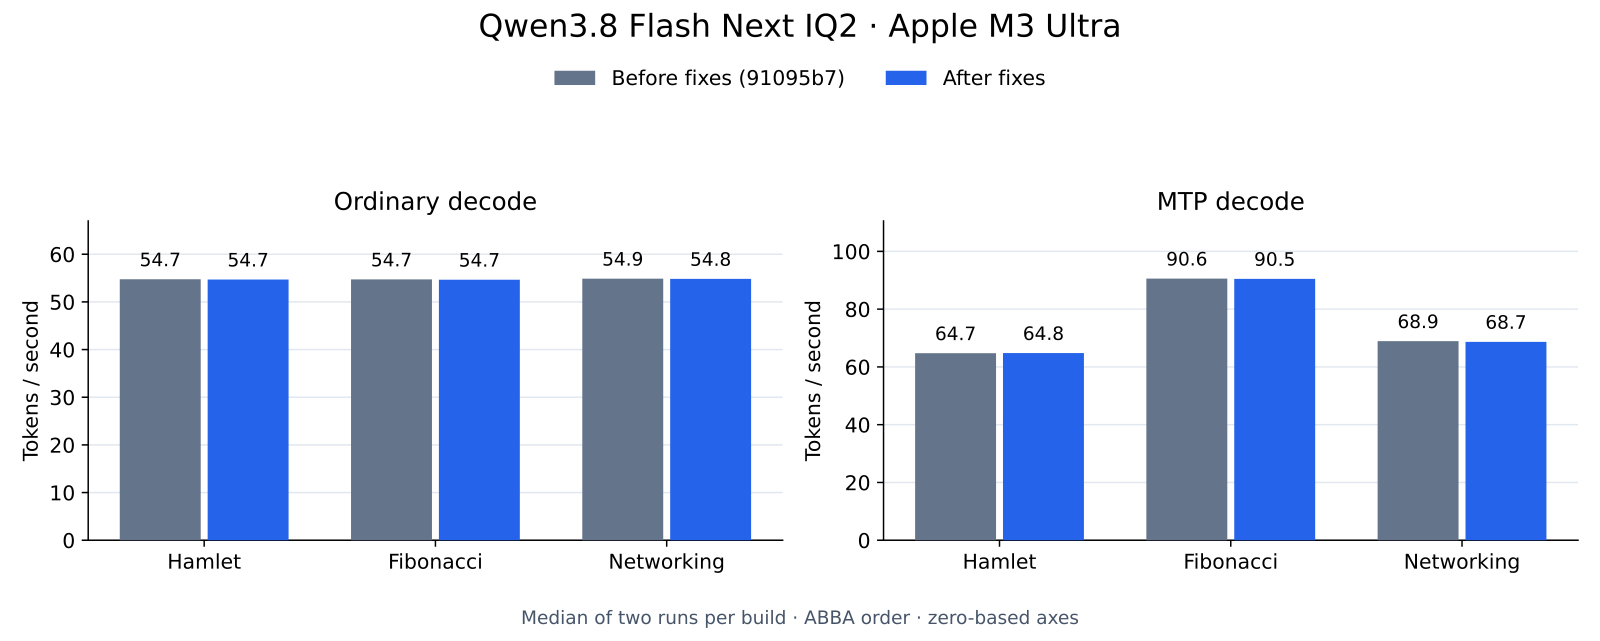 图:ds4 仓库 speed-bench 中 Qwen3.8 各 checkpoint 的生成吞吐对比。来源:antirez/ds4 仓库 speed-bench/qwen38-checkpoints/generation-throughput.svg
多用户并发带来的整体吞吐提升,本质上是拿单个请求延迟换取总线带宽利用率。无论是张量切分还是流水线并行,都在尽可能榨干每一块硅片的极限性能。这让闲置的旧款加速卡找到了云端大规模集群之外的第二生存空间。
窄实现刻意舍弃通用生态
ds4 不做通用 GGUF runner,只认项目自己产出的极简 GGUF 布局。这种窄实现去除了兼容不同量化格式的冗余控制流开销,把宝贵的片上缓存留给了核心计算指令。没有版本库 tag 的发版模式,也表明它更像是一个快速迭代的研究验证载体。
项目的开发日志明确披露了过程中有大量 AI 编码 agent 深度参与。AI 代理直接介入自身底层推理引擎的重构,大幅缩短了针对特定硬件架构的代码级调优周期。采用 MIT 许可意味着这套极简实现能够被无缝嵌入到各类商业闭源系统中。
窄实现的代价同样清晰可见,这套栈的寿命直接绑在少数持续开放权重的大模型身上。一旦头部模型收紧开源授权策略,这种底层深度优化的红利将立刻遭遇断档危机。它在压榨出特定硬件极限性能的同时,也将技术路线牢牢锚定在生态圈的持续供血上。
这种牺牲通用性换取极限压榨的做法,重塑了前沿模型的准入门槛。它证明了只要敢于在特定硬件上做深度的工程剥离,本地推理的瓶颈就不再是加速卡的算力,而是内存和存储的容量。如今,跑通高参数模型的能力已经下放到终端,决定权在于设备物理容量的上限。
参考链接:
- HN 讨论区实录
- antirez 官方性能测试报告