Encajar un MoE de 284B en un portátil de 128 GB
DwarfStar 4 (ds4), un motor de inferencia en C desarrollado por el creador de Redis Salvatore Sanfilippo, redefine la barrera para ejecutar modelos de frontera en local: el factor limitante ya no es si puedes permitirte tarjetas aceleradoras de gama alta, sino si dispones de suficiente memoria. DeepSeek V4 Flash, un coloso Mixture-of-Experts (MoE) de 284 mil millones de parámetros, exige de forma nativa una cantidad monumental de memoria de vídeo (VRAM). Históricamente, el hardware de consumo habitual no tenía opción alguna de gestionar semejante volumen de parámetros.
ds4 aborda este desafío mediante una técnica de cuantización asimétrica de 2 bits, comprimiendo de forma agresiva los expertos enrutados para prescindir de la memoria periférica sin mermar la capacidad de cálculo central. Aplicar esta cuantización sobre decenas de miles de millones de parámetros de expertos enrutados demuestra que comprimir las rutas críticas de ejecución no equivale a degradar la capacidad lógica del modelo. Al comprimir a la fuerza un MoE de 284B en una máquina de consumo de 128 GB, este diseño —que intercambia capacidad de memoria por rendimiento de cómputo— traslada el umbral de la inferencia de frontera desde las salas de servidores de centros de datos directamente al escritorio.
En la gama alta del hardware de usuario, un Mac Studio de 512 GB ejecutando V4 PRO alcanza 150 t/s en prefill y 10–13 t/s en decodificación. Esta combinación de rendimiento basta para asumir tareas pesadas de análisis sobre bases de código complejas. Considerar la infraestructura de cálculo como una adquisición única de una estación de trabajo completa (de unos 12.000 dólares) establece una referencia financiera sólida para repatriar los grandes modelos desde la nube a entornos locales de desarrollo. Esta inversión en hardware elimina por completo la incertidumbre asociada a las facturas variables por uso de tokens en la nube.
Un prefill de 790 t/s revela el verdadero cuello de botella
En un M5 Max con 128 GB de memoria unificada bajo un contexto de 2048 tokens, ds4 registró 790,2 t/s en la fase de prefill, recortando drásticamente el tiempo de espera hasta el primer token. Sin embargo, en esa misma máquina, la generación descendió a 39,4 t/s, lo que evidencia que la arquitectura de memoria unificada sigue topando con los límites del ancho de banda físico en las fases intensivas en accesos a memoria. Esta marcada diferencia de rendimiento entre fases impone que las estrategias de inferencia en el edge deban potenciar sus puntos fuertes y sortear sus limitaciones.
Al contrastar las cifras del M5 Max junto a las del DGX Spark, las prioridades de cada hardware quedan patentes. Frente a las métricas de 825,8 / 18,1 t/s del DGX Spark, la plataforma de servidor domina en potencia bruta de prefill, pero en la fase de generación apenas logra distanciarse. En escenarios de contexto largo la prueba es aún más exigente: con 65.536 tokens de contexto, el M5 Max sostiene 398,5 / 27,6 t/s. Que las cifras de prefill se mantengan firmes confirma que el crecimiento de la caché KV no llega a colapsar el pipeline.
El hecho de que en contextos prolongados el prefill apenas decaiga mientras la generación se reduce a la mitad condiciona directamente el diseño de los flujos de trabajo de los agentes de programación. Esto obliga a las capas de orquestación a evitar largas cadenas de generación continua, apostando en su lugar por entradas de alta frecuencia e interacciones breves y ágiles para las tareas de depuración. Las limitaciones físicas del hardware están guiando al ecosistema de software hacia un modelo de interacción ligero sustentado en la recarga rápida de contexto.
Streaming desde SSD cuando la memoria se agota
Cuando la capacidad de memoria se satura, forzar la totalidad de los parámetros dentro de la RAM física deja de ser el único camino posible. La solución de ingeniería fundamental de ds4 combina el almacenamiento de la caché KV en disco con el streaming de pesos desde SSD NVMe. Si los parámetros superan el límite de memoria, el sistema estaciona los pesos de los expertos inactivos en el SSD y los recupera bajo demanda, supliendo la carencia de capacidad. Las latencias de microsegundos que ofrecen las unidades SSD modernas allanan el terreno a nivel de hardware para este streaming dinámico.
Guardar la caché KV en disco admite la recuperación basada en el hash del prompt, lo que evita tener que repetir el prefill tras un reinicio. Después de cualquier fallo o reinicio inesperado, cargar el estado memorizado directamente desde el disco elimina las largas esperas debidas a cálculos redundantes. En entornos con recursos limitados, estos detalles de ingeniería de bajo nivel pesan mucho más que la simple elección del modelo a la hora de garantizar la viabilidad del sistema.
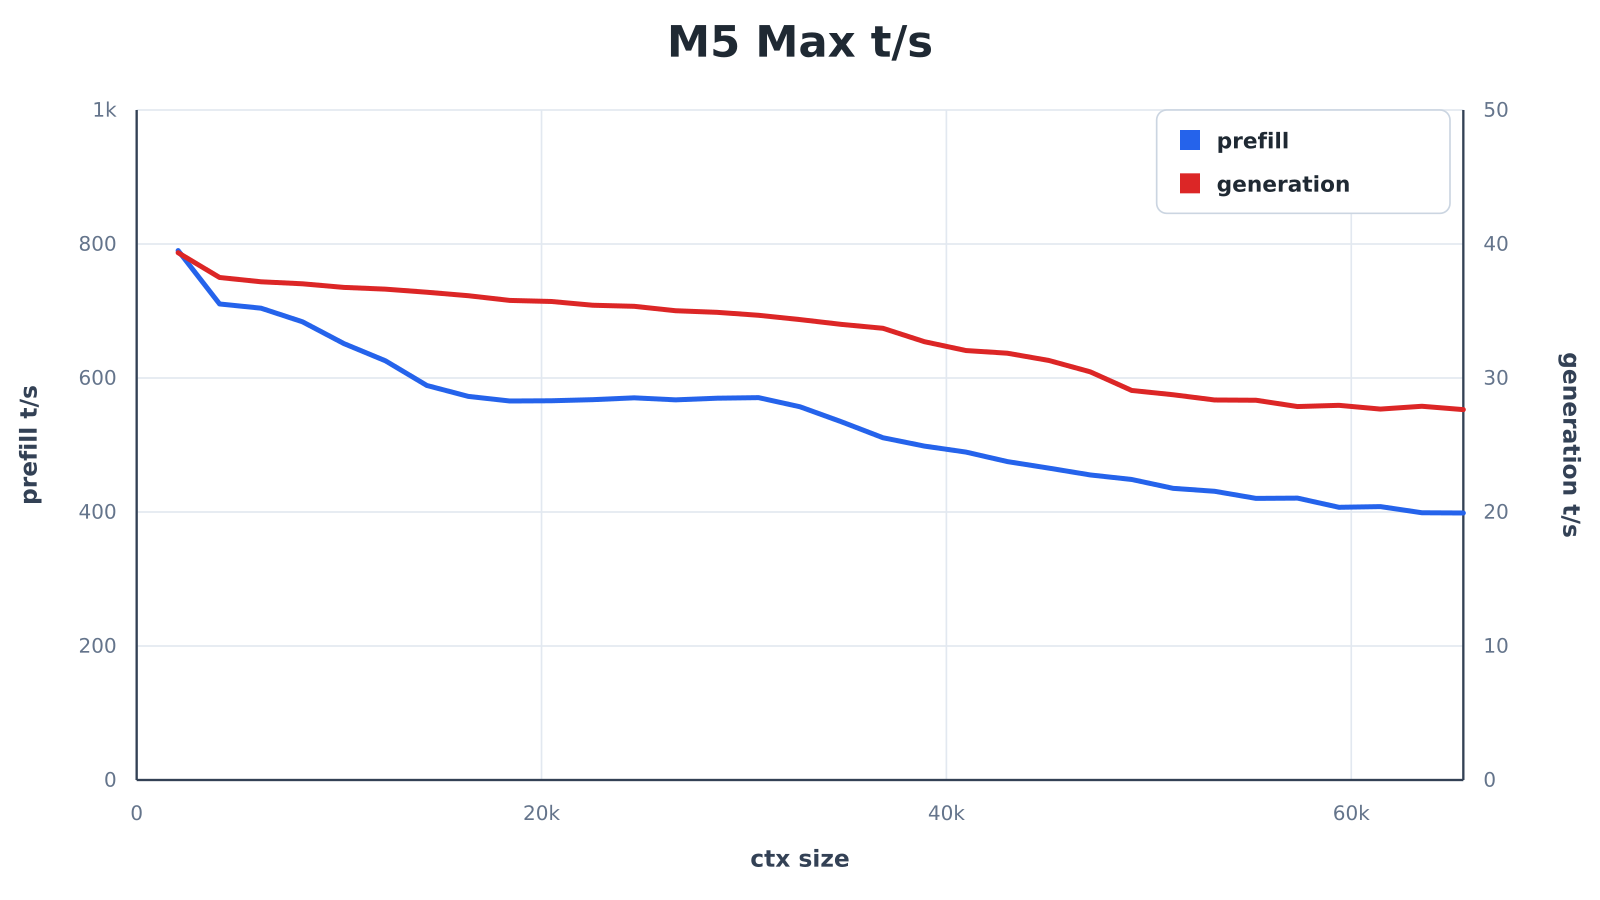 Figura: Curvas de rendimiento de prefill y generación en M5 Max del speed-bench en el repositorio ds4. Fuente: repositorio antirez/ds4 speed-bench/m5_max_ts.svg
Para los agentes nativos de programación, el proceso de inferencia se controla con precisión dentro de un proceso independiente. La latencia de red y la sobrecarga de serialización típicas de las llamadas a API en la nube desaparecen por completo. Concebir la capa de almacenamiento de alta velocidad como una extensión física de la memoria rompe con los esquemas rígidos de los entornos tradicionales de ejecución de LLM.
Unir dos máquinas de 128 GB en una sola mediante RDMA
Los límites físicos de una sola máquina pueden expandirse horizontalmente a través de redes distribuidas. ds4 permite paralelismo de tensores entre varios nodos mediante Apple RDMA, articulando un grupo de memoria heterogéneo compartido entre dispositivos. Este mecanismo de comunicación sortea las sobrecargas habituales de llamadas al sistema del kernel en las pilas de red estándar, reduciendo la latencia de intercambio entre fragmentos de tensores a rangos plenamente operativos.
En configuraciones de clúster, un despliegue de 8 tarjetas L40S ofrece un rendimiento agregado de generación de 126 t/s, capacidad suficiente para abastecer las peticiones concurrentes habituales de un equipo de desarrollo pequeño. Tarjetas aceleradoras de generaciones previas, relegadas por los backends oficiales de los modelos más recientes, vuelven a convertirse en potencia de cómputo útil, exprimiendo su valor residual mediante servidores de inferencia multiusuario. La clave de esta colaboración entre dispositivos radica en la segmentación y recomposición precisa de la memoria y el cómputo.
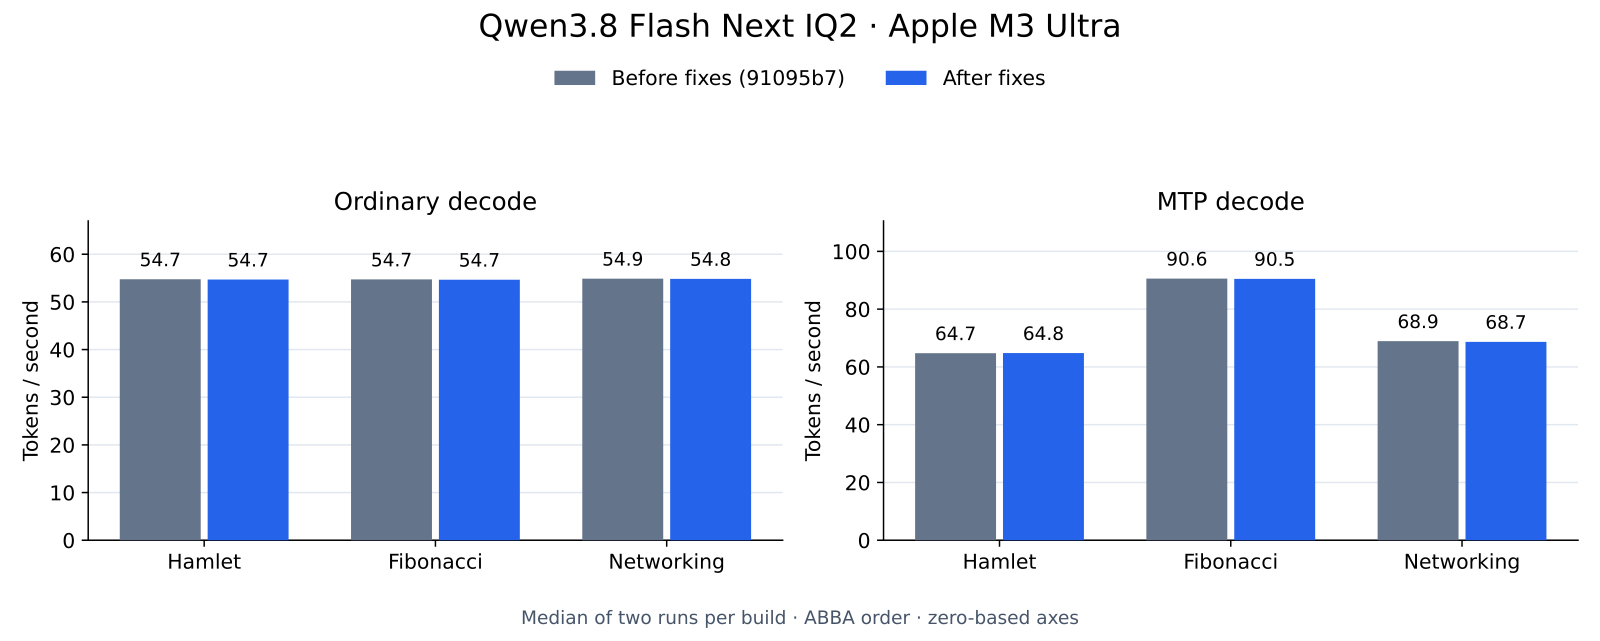 Figura: Comparación del rendimiento de generación entre diferentes checkpoints de Qwen3.8 del speed-bench de ds4. Fuente: repositorio antirez/ds4 speed-bench/qwen38-checkpoints/generation-throughput.svg
La ganancia en rendimiento global propiciada por la concurrencia multiusuario consiste, en esencia, en sacrificar parte de la latencia de cada petición individual a cambio de maximizar el aprovechamiento del ancho de banda del bus. Tanto en la partición de tensores como en el paralelismo de pipeline, el propósito es exprimir al máximo el rendimiento de cada chip de silicio. Esto brinda a las tarjetas antiguas en desuso un segundo espacio de utilidad viable al margen de los grandes clústeres en la nube.
Una implementación reducida que renuncia deliberadamente al ecosistema genérico
ds4 renuncia expresamente a ser un ejecutor genérico de formatos GGUF y solo reconoce la disposición GGUF minimalista generada por el propio proyecto. Esta implementación reducida suprime la sobrecarga del flujo de control necesaria para dar soporte a múltiples esquemas de cuantización, reservando las valiosas líneas de caché del chip para las instrucciones de cómputo centrales. El hecho de prescindir de etiquetas de versión en el repositorio refuerza su perfil como plataforma de investigación y validación de iteración rápida.
El registro de desarrollo del proyecto expone con total transparencia que numerosos agentes de codificación basados en IA participaron de forma activa en el proceso. Los propios agentes intervinieron directamente en la refactorización de su motor de inferencia subyacente, acelerando de forma sustancial los ciclos de optimización a nivel de código para la arquitectura de hardware de destino. La adopción de la licencia MIT permite integrar esta implementación minimalista sin fricción en sistemas comerciales propietarios.
Con todo, el coste de una implementación tan ceñida es igualmente evidente: la vigencia del software queda atada a los escasos modelos punteros que mantengan sus pesos abiertos. Si los principales laboratorios endurecen sus políticas de licencias abiertas, las ventajas de una optimización tan profunda a bajo nivel podrían desaparecer de inmediato. Al mismo tiempo que exprime la potencia máxima de un hardware específico, su continuidad tecnológica permanece supeditada al suministro ininterrumpido del ecosistema abierto.
Esta apuesta por sacrificar la generalidad en favor de una optimización extrema transforma los umbrales de acceso a los modelos de frontera. Demuestra que, si se tiene la audacia de depurar las capas de abstracción sobre un hardware concreto, el cuello de botella de la inferencia local ya no radica en la potencia bruta del acelerador, sino en la capacidad de la memoria y el almacenamiento. La capacidad de ejecutar modelos masivos se ha democratizado hasta los dispositivos de escritorio; el factor determinante reside ahora en el límite físico de la memoria de la máquina.
Enlaces de referencia:
- Registro de debate en HN
- Informe oficial de pruebas de rendimiento de antirez