Faire tenir un MoE de 284B dans un portable de 128 Go
DwarfStar 4 (ds4), un moteur d’inférence en C conçu par le créateur de Redis Salvatore Sanfilippo, déplace radicalement le ticket d’entrée pour exécuter des modèles de pointe en local : la question n’est plus d’avoir les moyens de s’offrir des cartes accélératrices hors de prix, mais de disposer d’assez de mémoire vive. DeepSeek V4 Flash, colosse de 284 milliards de paramètres au format Mixture-of-Experts (MoE), requiert nativement une quantité vertigineuse de mémoire vidéo (VRAM). Historiquement, les équipements grand public ne pouvaient même pas envisager de manipuler un tel volume de paramètres.
ds4 relève le défi grâce à une quantification asymétrique 2-bit, compressant de manière ciblée les experts routés afin d’élaguer les données périphériques tout en préservant le cœur de la capacité de calcul. Appliquer une telle compression à des dizaines de milliards de paramètres d’experts prouve que rogner sur les chemins d’exécution non critiques n’entraîne pas d’amputation cognitive du modèle. En compressant de force un MoE de 284B dans une machine grand public de 128 Go, cette conception — qui troque la capacité mémoire contre le débit de calcul — ramène l’inférence de pointe des salles de serveurs directement sur le bureau du développeur.
Sur le segment haut de gamme, un Mac Studio 512 Go exécutant V4 PRO affiche un débit de 150 t/s en pré-remplissage (prefill) et 10 à 13 t/s en décodage. Une telle cadence suffit amplement à soutenir des analyses approfondies sur des bases de code massives. Envisager l’infrastructure de calcul sous la forme d’un achat unique d’une station de travail complète d’environ 12 000 dollars offre un repère financier solide pour rapatrier les grands modèles du cloud vers les environnements de développement locaux. Cet investissement matériel écarte définitivement l’angoisse des coûts imprévisibles liés à la facturation au token.
Un pré-remplissage à 790 t/s révèle le véritable goulot d’étranglement
Sur un M5 Max doté de 128 Go de mémoire unifiée avec un contexte de 2048 tokens, ds4 a atteint un débit de 790,2 t/s en pré-remplissage, réduisant à néant le temps d’attente du premier token. En revanche, sur cette même machine, la génération plafonne à 39,4 t/s, mettant en lumière le fait que l’architecture à mémoire unifiée reste bridée par la bande passante physique lors des phases intensives en accès mémoire. Cette divergence marquée entre les phases d’inférence impose d’adapter les stratégies d’inférence locale en maximisant leurs atouts tout en contournant leurs limites matérielles.
La mise en parallèle des chiffres du M5 Max et du DGX Spark rend les arbitrages matériels particulièrement explicites. Face aux 825,8 / 18,1 t/s mesurés sur DGX Spark, la plateforme serveur conserve l’avantage en puissance de calcul brute lors du pré-remplissage, mais la génération ne creuse aucun écart significatif. L’épreuve devient encore plus manifeste en contexte long : à 65 536 tokens, le M5 Max maintient 398,5 / 27,6 t/s. La constance des scores de pré-remplissage démontre que le gonflement du cache KV ne fait pas s’effondrer le pipeline.
Le fait qu’en contexte étendu le pré-remplissage ne faiblisse presque pas tandis que la génération est divisée par deux redéfinit le mode opératoire des agents de codage. Cela contraint les couches d’orchestration à proscrire les longues sorties continues au profit d’entrées fréquentes et d’échanges courts et cadencés pour mener à bien le débogage. Les contraintes physiques du silicium orientent ainsi l’écosystème logiciel vers des interactions légères fondées sur un rechargement rapide de contexte.
Streaming depuis le SSD quand la mémoire fait défaut
Lorsque la mémoire sature, forcer l’intégralité du modèle à résider en RAM physique n’est plus la seule issue envisageable. La réponse d’ingénierie centrale apportée par ds4 repose sur la sauvegarde du cache KV sur disque couplée au streaming des poids depuis un SSD NVMe. Quand les paramètres excèdent la capacité de la mémoire vive, le système relègue les poids des experts inactifs sur le SSD pour les charger à la demande, comblant ainsi le déficit de mémoire. Les latences de l’ordre de la microseconde des SSD NVMe modernes créent le socle matériel indispensable à cette approche dynamique.
Le cache KV écrit sur disque prend en charge une restauration indexée par le hash du prompt, ce qui dispense d’avoir à recalculer le pré-remplissage après un redémarrage. Après un crash imprévu ou une réinitialisation, recharger directement l’état sauvegardé depuis le disque élimine les longues attentes associées au recalcul des entrées. Dans un cadre contraint en ressources, ces finesses d’ingénierie bas niveau pèsent bien plus lourd sur la viabilité pratique du système que le choix intrinsèque du modèle.
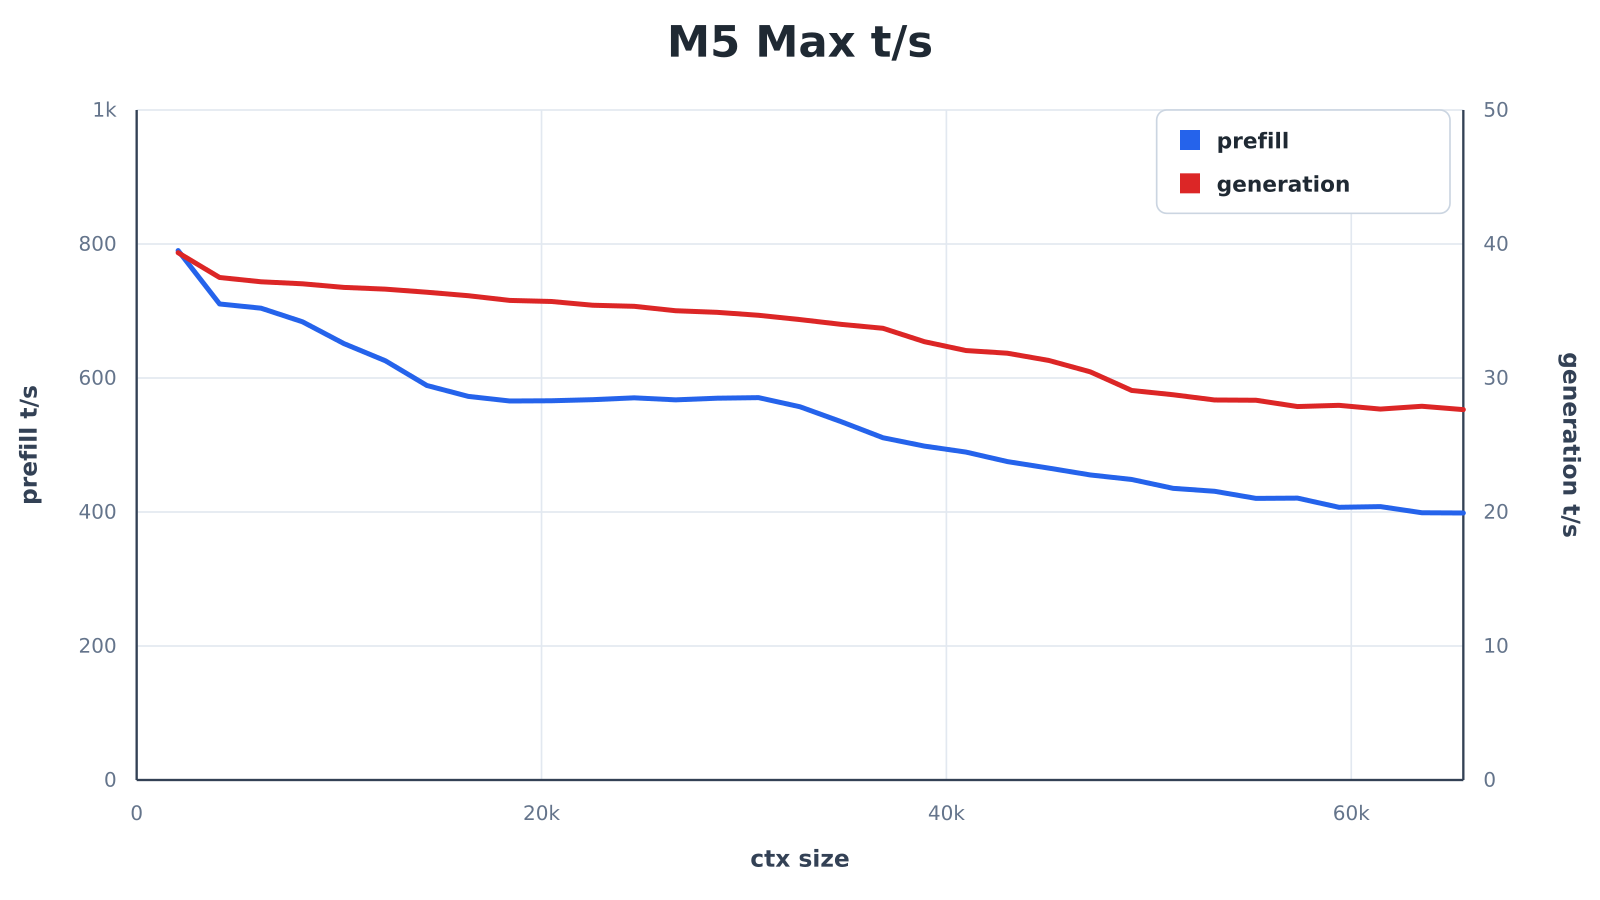 Figure : Courbes de débit de pré-remplissage et de génération sur M5 Max issues du speed-bench de ds4. Source : dépôt antirez/ds4 speed-bench/m5_max_ts.svg
Pour les agents de codage natifs, l’exécution de l’inférence est pilotée avec minutie au sein d’un processus autonome dédié. Les latences réseau et les surcoûts de sérialisation inhérents aux API cloud traditionnelles sont purement et simplement balayés. Considérer le stockage haute vitesse comme une extension physique directe de la mémoire fait voler en éclats les conventions figées des environnements d’exécution de LLM.
Fusionner deux machines de 128 Go via RDMA
Les frontières physiques d’un équipement individuel peuvent s’étendre horizontalement sur le réseau local. ds4 prend en charge le parallélisme de tenseurs entre plusieurs machines grâce à Apple RDMA, unifiant un pool de mémoire hétérogène partagé entre les périphériques. Ce canal de communication s’affranchit des appels système coûteux des piles réseau conventionnelles, réduisant la latence d’échange des tranches de tenseurs à des seuils tout à fait opérationnels.
En configuration de grappe, un déploiement de 8 cartes L40S délivre un débit de génération cumulé de 126 t/s, une capacité amplement suffisante pour absorber les requêtes simultanées quotidiennes d’une petite équipe de développement. Des cartes accélératrices d’anciennes générations, délaissées par les backends officiels des modèles récents, retrouvent ainsi une seconde jeunesse sous forme de puissance de calcul utile, leur valeur résiduelle étant exploitée au maximum via un serveur d’inférence multi-utilisateurs. Le secret de cette synergie multi-machines repose sur un découpage chirurgical et une recomposition minutieuse de la VRAM et du calcul.
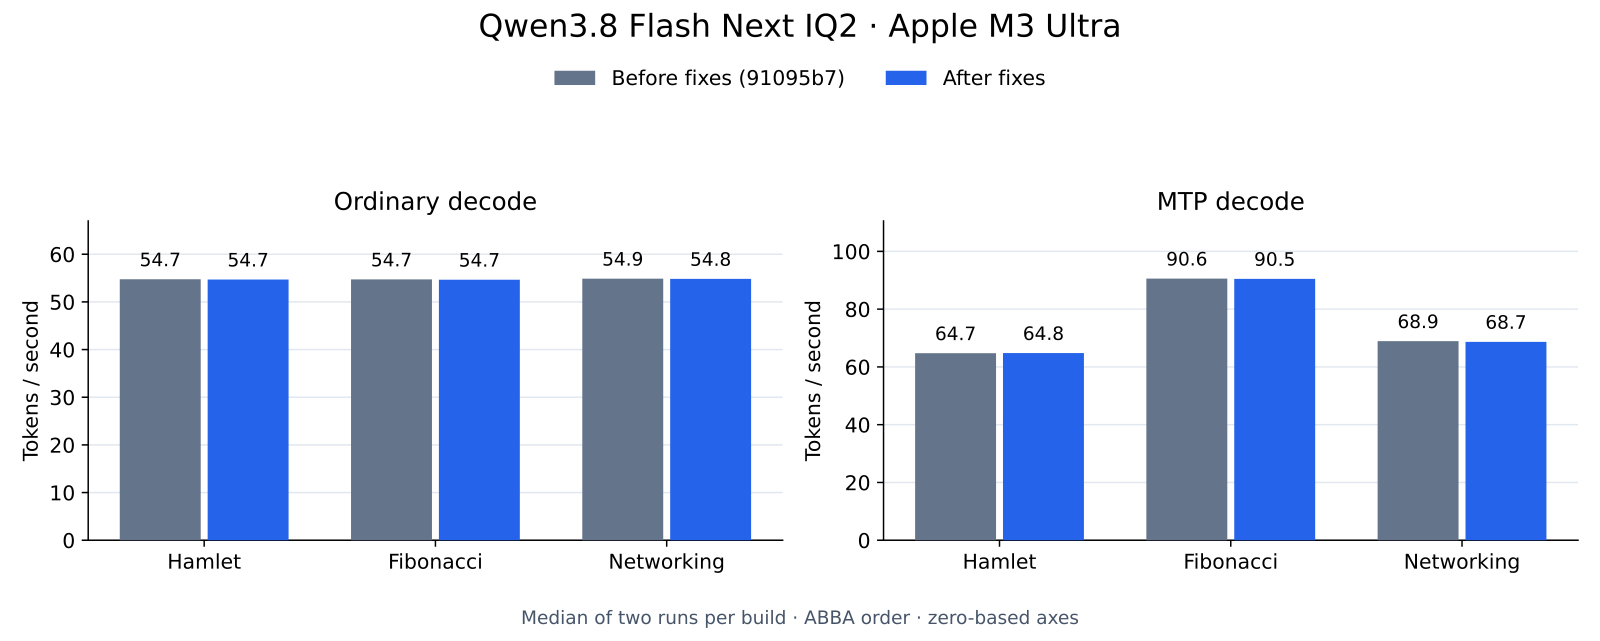 Figure : Comparaison du débit de génération entre différents points de contrôle de Qwen3.8 issue du speed-bench de ds4. Source : dépôt antirez/ds4 speed-bench/qwen38-checkpoints/generation-throughput.svg
Le gain de débit global apporté par la concurrence multi-utilisateur consiste essentiellement à consentir une légère hausse de la latence individuelle pour maximiser l’occupation de la bande passante du bus. Qu’il s’agisse de partitionnement de tenseurs ou de parallélisme de pipeline, l’objectif reste de pousser chaque puce de silicium dans ses derniers retranchements. Les accélérateurs plus anciens trouvent ainsi un nouvel espace d’exploitation viable, bien loin des méga-centres de données hyperscale.
Une implémentation ciblée qui renonce délibérément à l’écosystème généraliste
ds4 refuse catégoriquement d’endosser le rôle de moteur GGUF universel et ne prend en compte que la structure GGUF minimaliste propre au projet. Cette implémentation étroite élimine la complexité et les branchements superflus requis pour accommoder une multitude de formats de quantification, réservant les précieuses lignes de cache processeur aux boucles d’instructions critiques. L’absence délibérée d’étiquettes de version (tags) dans le dépôt rappelle d’ailleurs qu’il s’agit avant tout d’une plateforme d’exploration et de validation à cycle court.
Le journal de bord du projet documente sans détour l’intervention poussée d’agents de codage dopés à l’IA tout au long de sa gestation. Les agents ont participé directement au refactoring de leur propre moteur d’inférence sous-jacent, accélérant de manière spectaculaire les cycles d’optimisation au plus près du matériel. La licence MIT assure quant à elle que cette implémentation ultra-légère peut s’insérer sans accroc au cœur de solutions logicielles commerciales et propriétaires.
Le revers d’une spécialisation aussi pointue n’en demeure pas moins évident : la longévité de cette pile technique est intimement liée aux rares modèles de premier plan dont les poids demeurent sous licence ouverte. Si les laboratoires pionniers venaient à verrouiller leurs politiques de distribution ouverte, les fruits d’une telle optimisation en profondeur pourraient se tarir d’un coup. Tout en extrayant la quintessence de puces précises, cette trajectoire technologique reste tributaire du dynamisme continu de l’écosystème open source.
Ce choix délibéré de sacrifier l’universalité au profit d’une optimisation extrême redessine les conditions d’accès aux modèles de frontière. Il prouve que lorsque l’on accepte d’élaguer sans compromis les couches d’abstraction sur un matériel ciblé, le véritable goulot d’étranglement de l’inférence locale ne réside plus dans la puissance de calcul des accélérateurs, mais dans la capacité de la mémoire vive et du stockage. Désormais, la capacité d’exécuter des modèles aux dimensions colossales est descendue jusqu’aux postes de travail ; l’ultime arbitre n’est autre que le plafond physique de mémoire vive de la machine.
Liens de référence :
- Compte-rendu des discussions sur HN
- Rapport officiel de benchmarks par antirez