284B MoEを128GBノートPCに詰め込む
Redisの生みの親Salvatore Sanfilippoが開発したC言語推論エンジン「DwarfStar 4(ds4)」は、フロンティアモデルをローカルで動かすためのハードルを「高価なアクセラレータを購入できるか」から「十分なメモリを積めるか」へと塗り替えた。284BのMoE(Mixture of Experts)という巨大な規模を誇るDeepSeek V4 Flashは、ネイティブ状態では莫大なビデオメモリ(VRAM)を要求する。一般的なコンシューマー向け機器では、この規模のパラメータを直接ロードすることすら不可能だった。
ds4は非対称2-bit量子化技術を採用し、ルーティングされたエキスパートを集中的に圧縮することで、周辺的な記憶を削ぎ落としつつコアな計算能力を維持した。数百億規模のルーティングエキスパートにこの量子化を適用したことは、クリティカルパスを維持する限り、圧縮が必ずしもモデルの論理的知能の低下を意味しないことを示している。284B MoEを128GBのコンシューマー向けマシンに強引に収めたこの設計(メモリ容量と計算スループットのトレードオフ)は、フロンティア推論の敷居をデータセンターのサーバルームから一気にデスクトップ環境へと引き下げた。
ハイエンド環境では、512GBのMac StudioでV4 PROを実行し、プリフィル150 t/s、デコード10〜13 t/sのスループットを記録した。このスループットの組み合わせは、複雑なコードベースに対する本格的な解析タスクを十分に支えうる実用域に達している。計算リソースを約1万2000ドルのマシン一括購入という形で捉えることは、大規模モデルをクラウドからローカル開発環境へと引き戻すための明快な財務的基準線となる。このハードウェア投資モデルは、従量課金に伴う予測不能なコスト不安を完全に払拭してくれる。
プリフィル790 t/sが暴く真のボトルネック
128GBのユニファイドメモリを備えたM5 Maxにおいて、2048トークンのコンテキスト下で790.2 t/sのプリフィル性能が測定された。この圧倒的な入力スループットは、推論タスクのファーストトークン待機時間(TTFT)を劇的に短縮する。一方で同一マシンにおける生成速度は39.4 t/sにとどまり、メモリバウンドなデコード段階においてユニファイドメモリアーキテクチャが依然として物理帯域の上限に縛られている現実を浮き彫りにした。この推論フェーズ間の顕著な性能差は、エッジ推論が長所を生かし短所を避けるアーキテクチャ設計をとるべきであることを示している。
M5 MaxとDGX Sparkの数値を並べて比較すると、ハードウェアごとの設計思想の違いが一目瞭然となる。DGX Sparkが記録した825.8 / 18.1 t/sと比較すると、サーバー向けプラットフォームはプリフィル計算力で優位に立つものの、生成フェーズでは差がほとんど開かない。長コンテキスト環境ではこの差がさらに顕著になる。65,536トークンのコンテキスト下でM5 Maxは398.5 / 27.6 t/sを記録し、KVキャッシュの肥大化がパイプラインを崩壊させていない粘り強さを示した。
長コンテキスト下でプリフィル性能がほとんど低下せず生成速度が半減するという現象は、コーディングエージェントのワークフロー設計を決定づける。これは上位のオーケストレーション層に対し、長時間の連続出力を抑制し、高頻度な入力と短いターン数の対話によってデバッグを進めるよう促している。ハードウェアの物理的特性が、コンテキストのリロードを軸とした軽量なインタラクション設計へとソフトウェアエコシステムを方向づけているのである。
メモリが足りなければSSDストリーミングで補う
メモリ容量が底を突いたとき、モデルのすべてを無理やり物理RAMに詰め込むことだけが唯一の選択肢ではない。ds4が提示した核心的なエンジニアリング解は、KVキャッシュのディスク退避とSSDからの重みストリーミングの組み合わせである。パラメータサイズがメモリ上限を超えた場合、システムは非アクティブなエキスパートの重みをSSD上に配置し、必要に応じてオンデマンドで読み出すことで容量不足を補う。現代のNVMe SSDが備えるマイクロ秒クラスの低レイテンシが、このストリーミングを支えるハードウェア基盤となっている。
ディスクに書き込まれたKVキャッシュはprompt hashに基づく復元に対応しており、プロセスが再起動してもプリフィルをやり直す必要がない。予期せぬクラッシュや再起動の後でも、ディスクからキャッシュされた状態を直接読み込むことで、プロンプトの冗長な再計算による待ち時間を解消できる。リソースが限られた環境においては、単なるモデル選定よりも、こうした低レイヤーのエンジニアリングの工夫こそがシステムの可用性を決定づける。
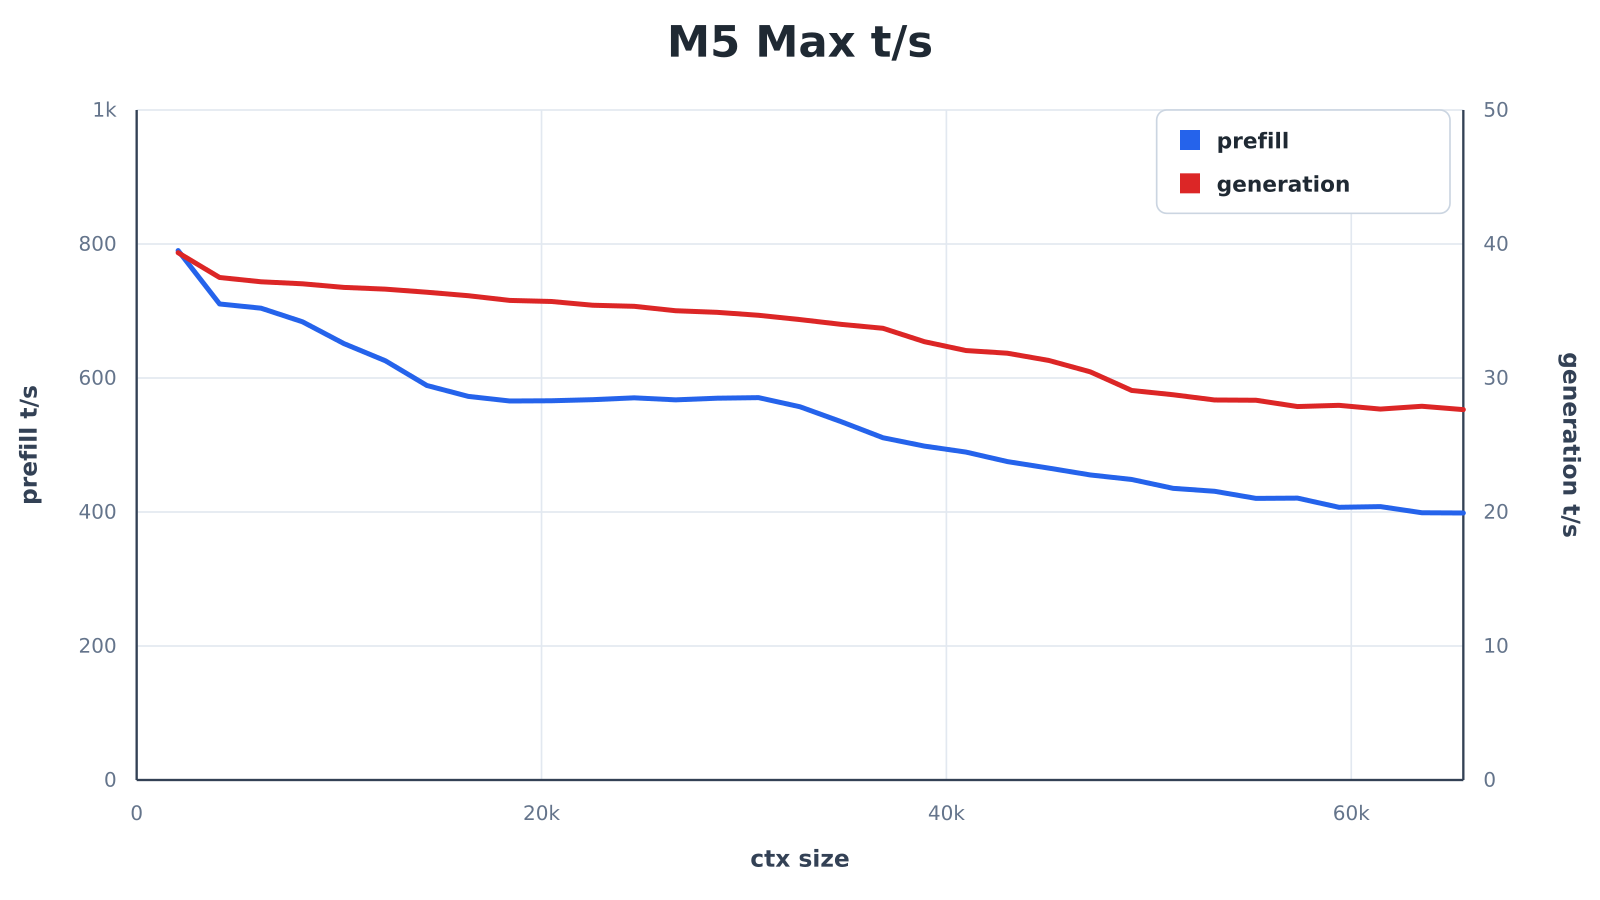 図:ds4リポジトリのspeed-benchにおけるM5 Maxのプリフィル/生成スループット曲線。出典:antirez/ds4リポジトリ speed-bench/m5_max_ts.svg
ネイティブコーディングエージェントにとって、推論処理は独立したプロセス内で緻密に制御される。従来のクラウドAPI呼び出しに伴うネットワーク遅延やシリアライズのオーバーヘッドは、このアーキテクチャによって完全に排除される。ストレージ層をメモリの物理的拡張として直接扱うアプローチは、大規模モデル推論に対する従来の固定観念を打ち破った。
2台の128GBマシンをRDMAで結合する
単一ハードウェアの物理的限界は、分散ネットワークを介して水平方向に拡張できる。ds4は複数マシン間でApple RDMAを用いたテンソル並列をサポートしており、デバイスをまたいだヘテロジニアスなメモリプールを構築できる。この通信機構は通常のネットワークスタックにおけるカーネルシステムコールのオーバーヘッドを回避し、テンソル分割に伴うデータ交換のレイテンシを実用域まで引き下げる。
クラスタ構成においては、8基のL40Sを配置することで126 t/sの合計生成スループットを達成した。このスループットは、小規模な開発チームの日常的な同時リクエストを処理するのに十分な能力である。新モデルの公式バックエンドから弾き出された旧世代カードが再び計算資源として息を吹き返し、マルチユーザー推論サーバーの仕組みを通じてその余剰価値が徹底的に引き出される。クロスデバイス協調の要は、メモリと計算リソースの精密な切り出しと再構成にある。
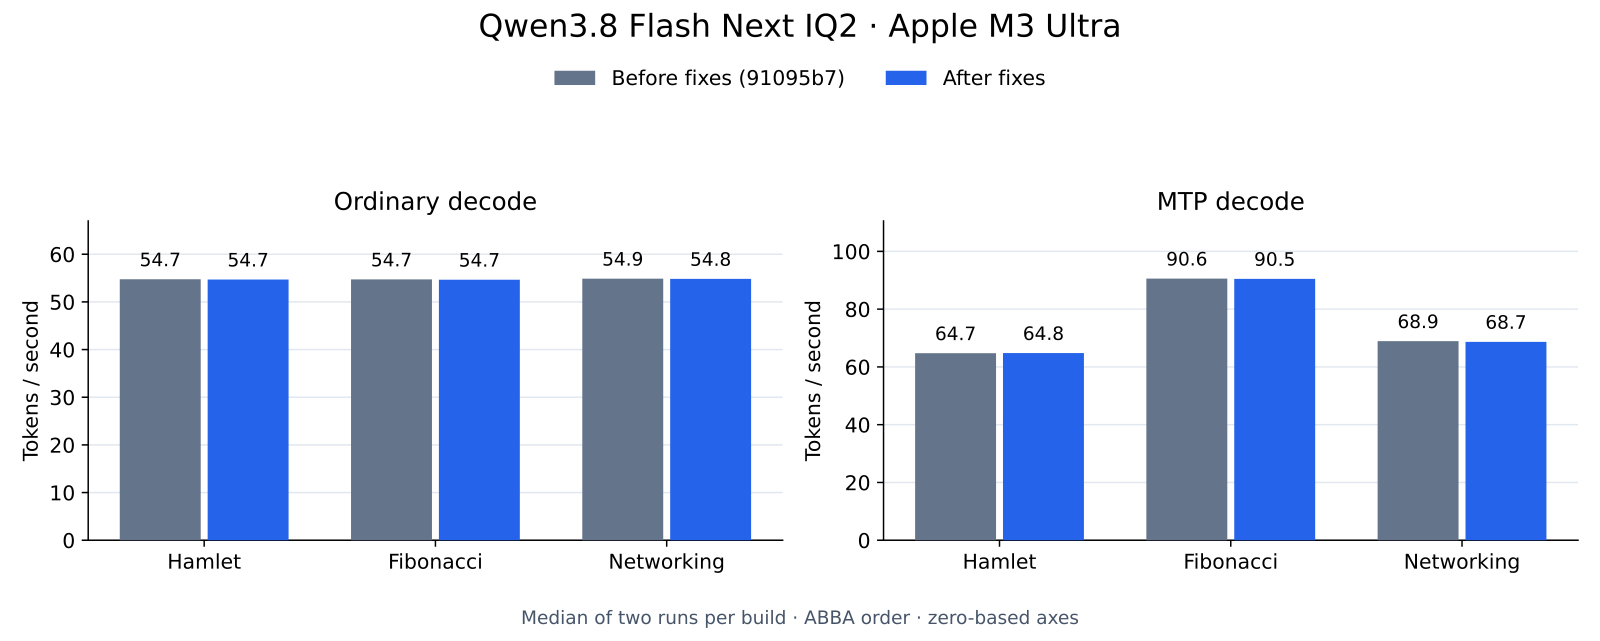 図:ds4リポジトリのspeed-benchにおけるQwen3.8各チェックポイントの生成スループット比較。出典:antirez/ds4リポジトリ speed-bench/qwen38-checkpoints/generation-throughput.svg
マルチユーザー同時実行によるトータルスループットの向上は、本質的に単一リクエストのレイテンシと引き換えにバス帯域の利用効率を最大化するアプローチである。テンソル分割であれパイプライン並列であれ、目的はシリコンの限界性能を隅々まで絞り出すことにある。これにより、遊休化していた旧型アクセラレータは、巨大なクラウドクラスタの外部において確固たる第2の居場所を見出した。
汎用エコシステムをあえて切り捨てる「狭い実装」
ds4は汎用的なGGUFランナーを目指さず、自プロジェクトが生成した極限まで削ぎ落とされたGGUFレイアウトのみを認識する。この「狭い実装」によって多様な量子化フォーマットをサポートするための冗長な制御フローを排除し、貴重なオンチップキャッシュをコアな計算命令のために確保した。リポジトリにリリースタグを付けない運用形態も、これが高速に反復検証を進める研究用プラットフォームであることを示している。
プロジェクトの開発ログには、プロセス全体を通じてAIコーディングエージェントが深く関与していたことが明記されている。AIエージェント自身が自らの下層にある推論エンジンのリファクタリングに直接介入することで、特定ハードウェア向けコードレベルのチューニングサイクルが大幅に短縮された。MITライセンスの採用により、この極小実装は商用のプロプライエタリなシステムにも摩擦なく組み込むことができる。
一方で、「狭い実装」の代償も明確である。このスタックの寿命は、継続的に重みをオープン公開してくれるごく少数のフロンティアモデルに直接依存している。主要なモデル開発企業がオープンウェイトのライセンス方針を引き締めれば、こうした低レイヤーの最適化による恩恵は一夜にして途絶えるリスクを孕む。特定ハードウェアの極限性能を引き出す一方で、その技術的ロードマップはオープンエコシステムの持続的な供給に固く結びつけられている。
汎用性を犠牲にして極限の効率を追求するこのアプローチは、フロンティアモデルへのアクセス障壁を塗り替えた。特定ハードウェアに特化した徹底的なエンジニアリング削ぎ落としを恐れなければ、ローカル推論のボトルネックはもはやアクセラレータの計算力ではなく、メモリとストレージの容量であることが証明された。今や高パラメータモデルを自前で動かす力は末端の端末へと解放され、その決定権はマシンの物理メモリ容量の上限へと委ねられている。
参考リンク:
- HNディスカッション記録
- antirez公式ベンチマークレポート