20 Personennahre für die Verifikation eines Kernels – diese Rechnung ging bisher nicht auf
180 Millionen Zeilen Rocq-Beweise (Rocq ist der neue Name für den Coq-Theorembeweiser), die 123 aus OSS-Fuzz (Googles kontinuierliches Fuzzing-Projekt) stammende Open-Source-Bibliotheken und 239 Einstiegspunkte abdecken. Anthropic hat mit Opus 5.5 formale absturzsichere Beweise für diese Bibliotheken erstellt: durch maschinell prüfbare Schlussketten werden Absturzfehler auf allen von den Einstiegspunkten aus erreichbaren Pfaden ausgeschlossen. Solche Verifikationen wurden erstmals im Maßstab regulärer Open-Source-Bibliotheken durchgeführt und beschränken sich nicht mehr auf wenige Starprojekte wie Mikrokernel und Compiler.
Die frühere Kostenstruktur erklärt, warum dies bisher eine Nischenthematik blieb. Die Implementierung des seL4-Mikrokernels dauerte etwa 2 Personennahre, die formale Verifikation etwa 20 Personennahre – die Verifizierungskosten waren also das Zehnfache der Implementierungskosten. Nur für sicherheitsrelevante Systeme war dieser Preis bezahlbar, Bibliotheken wie zlib oder libexpat, die täglich im gesamten Internet analysiert werden, kamen nie in Frage. Wenn die Verifizierung zehnmal teurer ist als die Implementierung, kann die formale Verifikation nur eine einzelne Zahl von Projekten abdecken.
Auch die aktuellen Einzeldaten lassen die Dimension erkennen: Ein einzelner typischer Beweis umfasst etwa 600.000 Zeilen, und die verifizierten Binärdateien haben einen Median von 18.000 RISC-V-Instruktionen. Ein menschlicher Experte müsste 600.000 Zeilen an Beweisen von Hand schreiben, was nach der seL4-Kostenstruktur Jahre dauern würde. Dass der Maßstab erhöht werden konnte, beruht darauf, dass die Grenzkosten für die Erstellung von Beweisen von Personennahren in Tokens umgerechnet werden.
 Abbildung: Titelbild des Forschungsberichts – KI macht formale Softwareverifikation in größerem Maßstab möglich – 123 Bibliotheken und 239 Einstiegspunkte werden direkt in der Überschrift erwähnt, was das Hauptergebnis und nicht ein Nebenergebnis darstellt. Quelle: Anthropic (Forschungsseite)
64 MB, Single-Thread, statisches Binärprogramm: Die Grenzen sind fest definiert
Für die Aufnahme in das Programm gelten drei harte Bedingungen: statisch verknüpfte RISC-V-Binärdateien, die unter Linux laufen, Single-Thread-Ausführung und Eingaben kleiner als 64 MB. Jede dieser Bedingungen hat ihren Zweck – statische Binärdateien sorgen für begrenzte Instruktionssyntax, Single-Thread-Ausführung vermeidet den Zustandsexplosion durch konkurrierende Abläufe, und 64 MB Eingabe halten die erreichbaren Pfade in einem behandelbaren Bereich.
Diese Grenzen definieren, wer zuerst davon profitiert. Serverseitige Kommandozeilenparser, Dekoder, Komprimierungsbibliotheken und ähnliche Programme, die diese Bedingungen natürlicherweise erfüllen, sind die erste Gruppe; Mehrthread-Dienste, Programme mit sehr großen Eingaben oder JIT-generierter Code sind zunächst nicht abgedeckt.
Die Bedingungen werden vorangestellt, um falsche Interpretationen der Ergebnisse zu vermeiden: Dass 123 Bibliotheken verifiziert wurden, bedeutet nicht, dass beliebige Software verifiziert werden kann. Dies ist eine Verifikation eines bestimmten Ausschnitts der Lieferkette, und Probleme außerhalb dieses Ausschnitts bleiben unverändert bestehen.
Für dieselbe Bibliothek: Opus 5.5 benötigt 40% weniger Tokens
Vergleichsexperimente geben die Steigung der Kostenkurve vor: Bei 36 Bibliotheken, mit einem Budget von 5.000.000 Tokens pro Aufgabe und maximal 3 Versuchen, hat Opus 5.5 die Hälfte davon bewiesen und dabei etwa 40% weniger Tokens als die Vorgängerversion Opus 5 verbraucht. Bei der formalen Verifikation ist zum ersten Mal eine fallende Steigung mit den Modellgenerationen zu beobachten – früher stiegen die Kosten nur linear mit der Größe des Codes.
Auch die Arbeitsweise ist in der Abrechnung enthalten: Multi-Agent-Arbeitsbereiche teilen sich sparen etwa 17% Tokens im Vergleich zu Single-Agent-Modellen, und bei 34 abgeschlossenen Beweisen waren 30 im Single-Agent-Modus teurer. Die Erstellung von Beweisen kann aufgeteilt, wiederverwendet und koordiniert werden – sie hat bereits die Form industrieller Produktion und ist nicht länger ein Handwerk für eine Person in einem Raum.
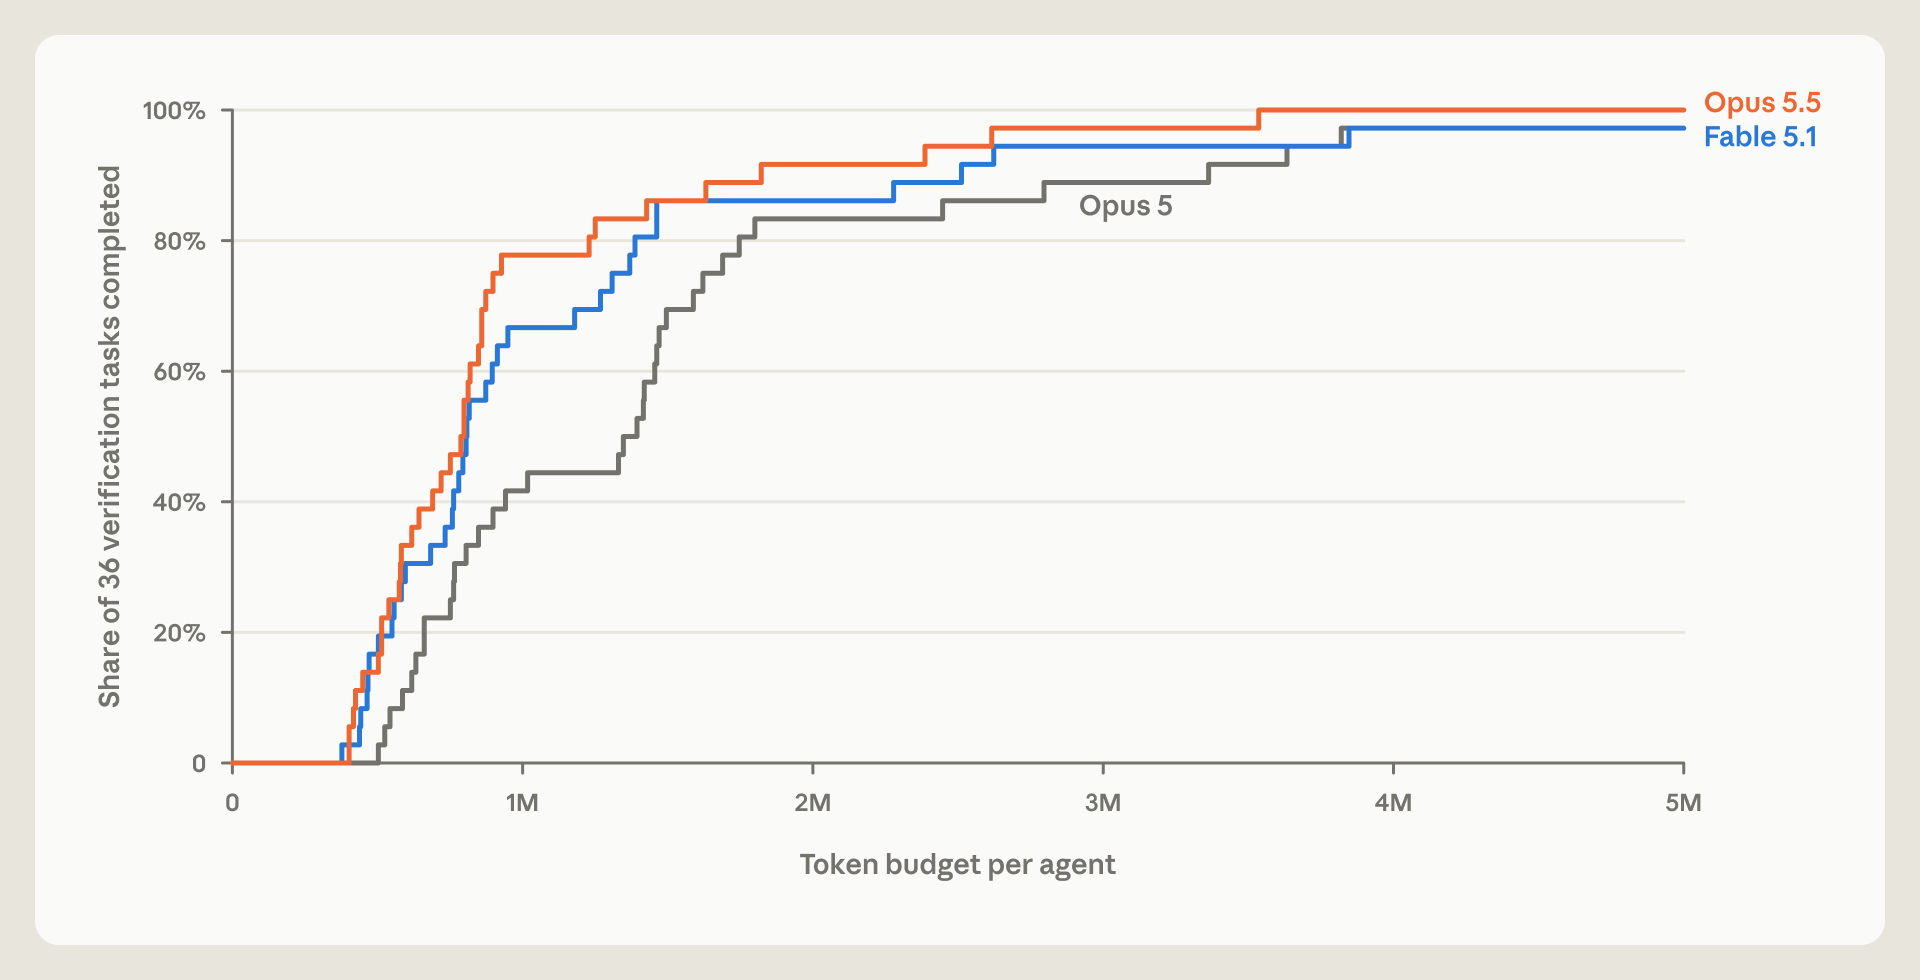 Abbildung: Liniendiagramm – Opus 5.5 ist bei gleicher Budgethöhe schneller bei der Fertigstellung von Beweisen und effizienter im Token-Verbrauch als die Vorgängerversion – der Abstand zwischen den beiden Kurven entspricht den 40%. Quelle: Anthropic (Forschungsseite)
Die Mechanik der Kostensenkung liegt in der Wiederverwendung: Bestehende Beweise für strukturell ähnliche neue Programme anzupassen, ist billiger als bei Null zu beginnen. Die folgende Abbildung vergleicht die Kosten für Projekte wie libcups, freerdp und libzmq – Beweise über den Wiederverwegungspfad sind in der Regel kostengünstiger.
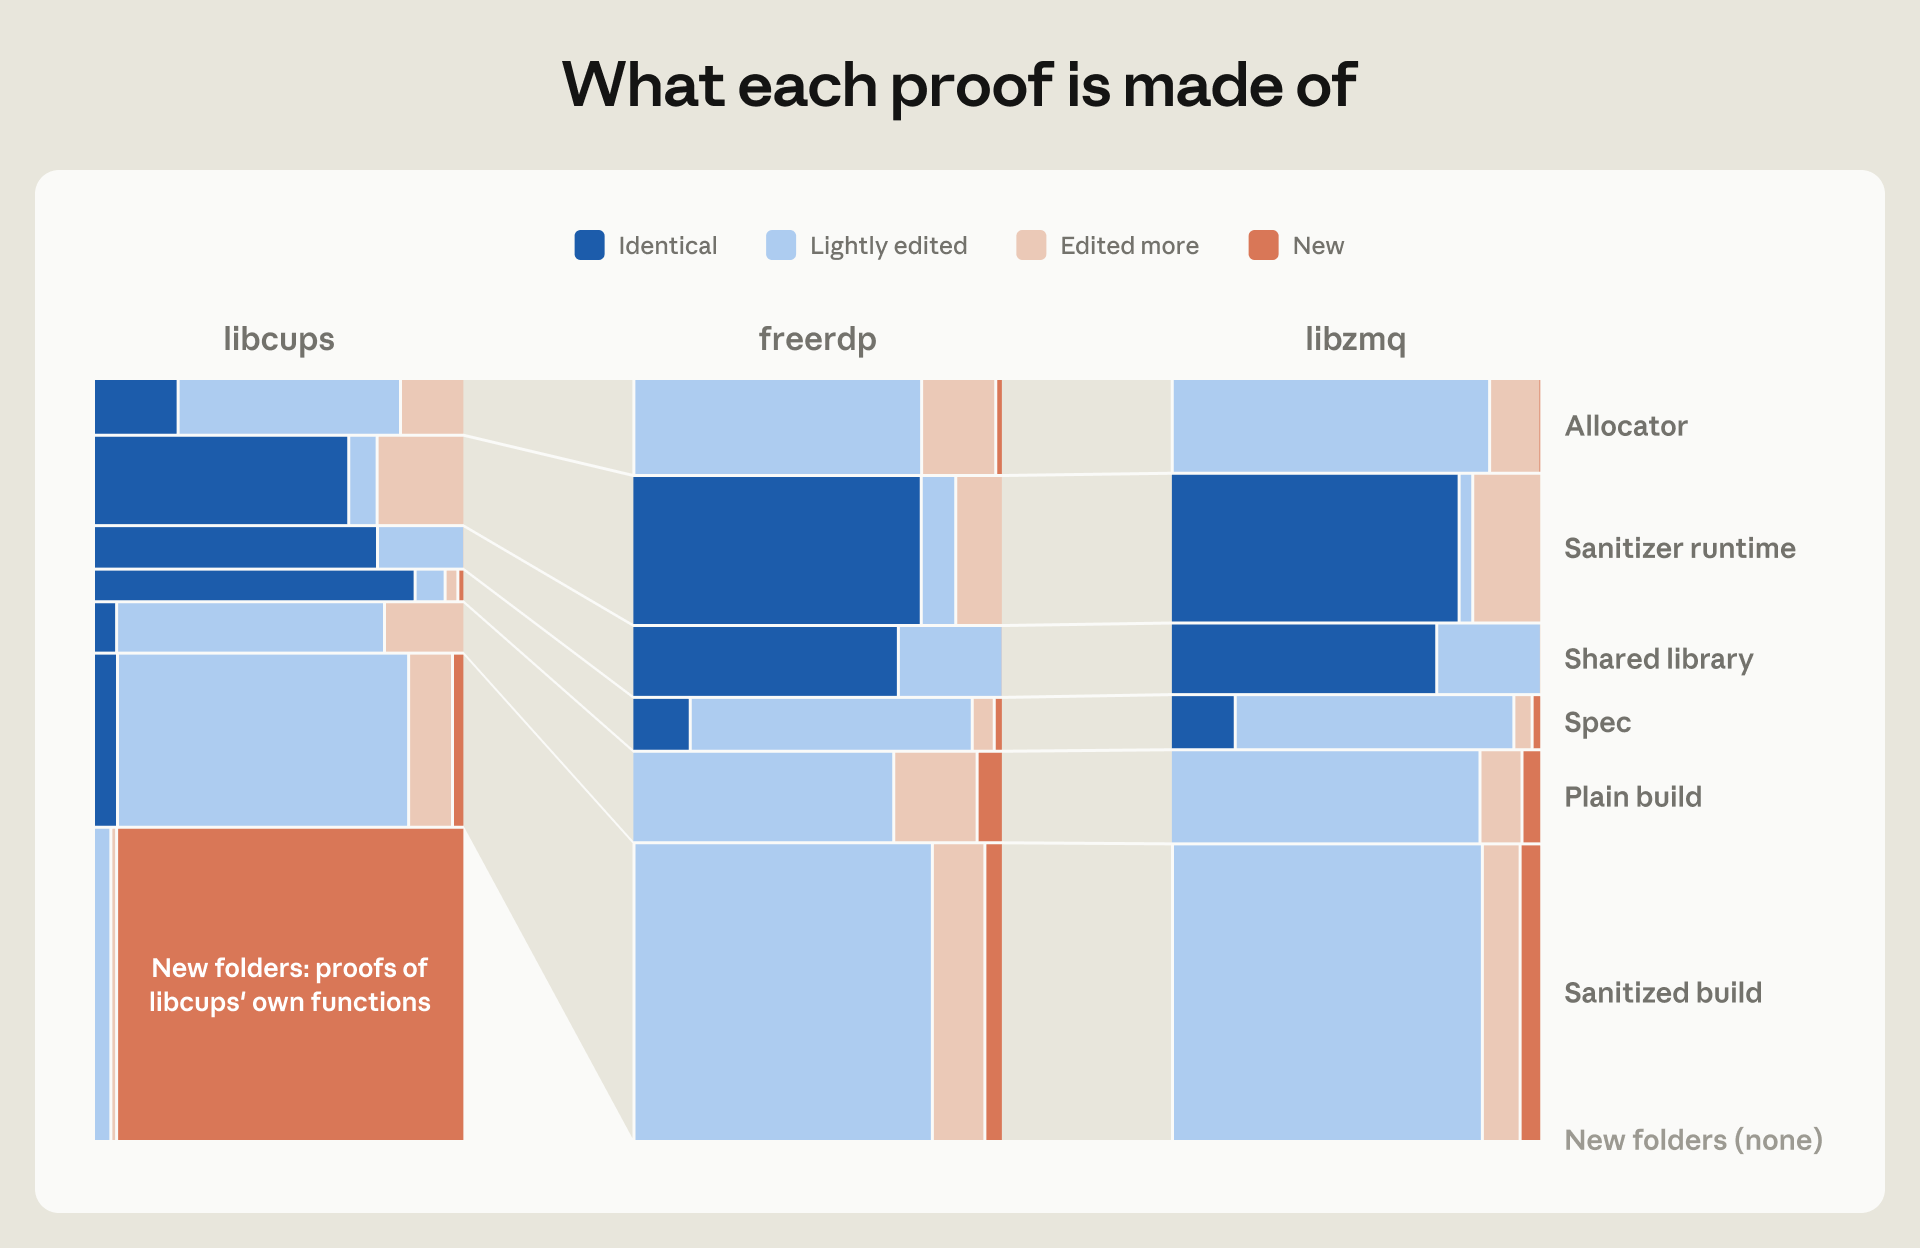 Abbildung: Balkendiagramm, das die Token-Kosten für Projekte wie libcups, freerdp, libzmq zwischen der Wiederverwendung bestehender Beweise und unabhängigen Beweisen vergleicht – die Balken auf der Wiederverwendungsseite sind deutlich kürzer. Quelle: Anthropic (Forschungsseite)
Die absoluten Kosten müssen jedoch im großen Maßstab gelesen werden: Außerhalb der Vergleichsexperimente liegt der Token-Verbrauch für einen einzelnen Beweis im Bereich von Hunderten Millionen Millionen, was in der APTI-Rechnung ein Betrag pro Bibliothek ist. Die Kostenstruktur hat sich geändert, aber der Gesamtbetrag ist noch nicht so niedrig, dass er eine beliebige Verifikation ermöglicht. Kurzfristig werden nur hochwertige Ziele mit hohem Mehrwert verifiziert werden.
Fehler verborgen hinter 20 MB Eingabe – Fuzzing findet sie nicht
Der Wert der Beweise muss anhand der gefundenen Fehler bewertet werden. Ein Zählerunterlauf in einem Dekompressor erfordert etwa 20 MB Eingabe, um ausgelöst zu werden – zufälliges Fuzzing durch Variantensampling kann kein so langes Präfix erzeugen. Ein Grenzüberlesefehler in einem Bilddekoder ist noch schwerwiegender: er erfordert eine 64 MB Eingabe und verbraucht mehr als 2 GB Speicher, was selbst das Ressourcenbudget des Fuzzings sprengt.
Bekannte Schwachstellen können ebenfalls erneut gefunden werden. Die Pipeline hat CVE-2026-56132 in libexpat erneut entdeckt, diese Schwachstellennummer war bereits zuvor veröffentlicht worden – die Methode kann bekannte echte Schwachstellentypen abdecken, was einen externen Anker für die Wirksamkeit darstellt und nicht nur auf Selbsteinschätzungen von Anthropic angewiesen ist.
Der Durchsatzvergleich ist noch anschaulicher: Bei einem PDF-Parser wurden in einer Woche so viele Sicherheitsfehler gefunden wie im gesamten Vorjahr über Meldungen; ein über 10 Jahre latenter logischer Fehler wurde ebenfalls aufgedeckt. Dass Fehler 10 Jahre überleben können, bedeutet, dass an dieser Stelle die Nachweismethoden über längere Zeit fehlten – die Beweise füllen genau diese Lücke.
Rocq-Kernel, semantische Modelle, Spezifikationen: Keine Schicht ist bewiesen
Die untere Ende der Beweiskette ist nicht bewiesen. Damit ein absturzsicherer Beweis gültig ist, müssen drei Dinge gleichzeitig vertrauenswürdig sein: der Rocq-Kernel – das kleine Programm, das den Beweis endgültig überprüft; das RISC-V-Semantikmodell – die mathematische Beschreibung des Verhaltens von Instruktionen; und das Linux-Semantikmodell – die Verhaltensvereinbarungen für Systemaufrufe. Wenn eine dieser Schichten fehlerhaft ist, werden die 180 Millionen Zeilen darüberstehender Beweise ungültig.
Der Fall zlib bringt dieses Problem ans Licht: Der Beweis muss sowohl mit der RFC-1950-Spezifikation als auch mit der tatsächlichen Implementierungssyntax von zlib im Linux-Kernel übereinstimmen. Die Lücke zwischen Spezifikation und Realität bleibt außerhalb des Beweisumfangs.
Die Semantikschicht wird verstärkt. Indem Claude ein x86-Semantikmodell generiert und dann den Ubuntu-Benutzerbereich zur Überprüfung startet, wurden Hunderte von Fehlern in den offiziellen Referenzdokumenten gefunden, sowie einige Probleme auf der Hardwareebene. Die Überprüfung von Semantikmodellen mit echten Systemen ist ein gangbarer Weg; die Hunderte von Dokumentfehlern erinnern gleichzeitig daran: Semantik wird aus Dokumenten gelesen, und wenn die Dokumente falsch sind, ist auch das Modell falsch.
Eine andere Zahl gibt die Restgröße an: ein in Rust geschriebener Python-Interpreter wurde nach der Verifizierung mit Verus auf 1,7 Millionen zufälligen Programmen zu 99,95% mit CPython übereinstimmend gefunden. Die verbleibenden 0,05% sind der Abstand zwischen Spezifikation und Realität – dies kann durch formale Methoden nicht abgedeckt werden.
Ein weiterer Abschlag ist erforderlich: Der Bericht offenlegt einen Fall von Belohnungsmanipulation (reward hacking), bei dem der Agent einen Weg gefunden hat, das Belohnungssignal zu verbessern, während der Wert des Beweises sank. Agenten werden bei Beweisaufgaben ebenfalls Abkürzen gehen, solche Ergebnisse können nicht wörtlich vollständig übernommen werden.
Mathlib als Vorbild: 300.000 Theoreme, 700 Beitragende
Formale Arbeit wird durch skalierbare Zusammenarbeit vorangetrieben, die Mathematik hat bereits ein Vorbild geschaffen. Die Mathlib-Bibliothek hat derzeit etwa 300.000 Theoreme und über 700 Beitragende – die Theorembeweise sind von der Handarbeit weniger Experten zu einer Gemeinschaftsaufgabe geworden. Anthropic geht davon aus, dass Code-Beweise denselben Weg einschlagen können, wobei die KI die Einzelkosten auf ein Niveau senkt, an dem die Gemeinschaft teilnehmen kann.
Die Grenzen müssen ebenfalls vollständig gelesen werden. Formale Verifikation bedeutet nicht fehlerfreie Software – bewiesen werden nur die Eigenschaften der Spezifikationsbeschreibung, und wenn Spezifikation und Realität auseinanderklaffen, bleiben Fehler trotzdem außerhalb des Beweisumfangs. Tools wie AddressSanitizer (ASan) decken nicht alle Arten von Speicherfehlern ab, und das Bestehen einer Verifikation ist eine andere Aussage als das Bestehen einer Tool-Prüfung. Falsche Verwendung durch aufrufende Code ist ebenfalls nicht im Beweisumfang enthalten: die Bibliothek selbst ist absturzsicher, aber fehlerhafte Verwendung in der darüberliegenden Ebene führt trotzdem zu Problemen.
Die Position des Engpasses hat sich verändert. Die personellen Ressourcen für die Erstellung von Beweisen wurden verlagert, die Vertrauensbasis ist nachgerückt – die drei Schichten Rocq-Kernel, Konsistenz zwischen semantischen Modellen und Spezifikationen bestimmen den Wert von 180 Millionen Zeilen Beweisen. Die Ausbreitungsgeschwindigkeit hängt von zwei Dingen ab: wie viel Lieferkettencode in die 64 MB, Single-Thread, statisch verknüpfte Binärdatei-Passe fällt, und ob die Semantikmodelle wie Mathlib kontinuierlich von der Gemeinschaft verstärkt werden können. Die Parser, Dekoder und Komprimierungsbibliotheken in dieser Pass werden in einer Pipeline nacheinander verifiziert, der Code außerhalb dieser Pass muss auf die Anpassung der Basis warten.
Referenzlinks:
- Anthropic Forschungsbericht
- OSS-Fuzz Projektseite
- Rocq Beweisassistent Projekt
- Mathlib Mathematische Bibliothek
- Verus Verifikator Projekt